Python栈的基本定义与使用方法示例【初始化、赋值、入栈、出栈等】
本文通过Python代码示例,详细讲解了栈的基本定义与使用方法。内容涵盖栈的初始化、节点类的构建,以及入栈(push)、出栈(pop)和获取栈顶元素(peek)等核心操作的具体实现与运行结果分析,帮助读者理解栈先进后出的特性。
2026-10-13
13

本文通过Python代码示例,详细讲解了栈的基本定义与使用方法。内容涵盖栈的初始化、节点类的构建,以及入栈(push)、出栈(pop)和获取栈顶元素(peek)等核心操作的具体实现与运行结果分析,帮助读者理解栈先进后出的特性。
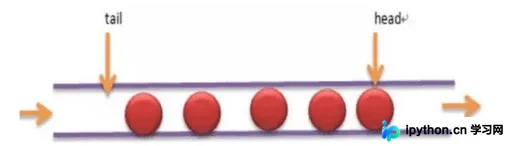
本文详解Python中队列(Queue)的基本定义与使用方法。队列遵循先进先出(FIFO)原则,广泛应用于消息通信及多进程/多线程协同场景。文章通过Node和Queue类的代码示例,演示了队列的初始化、入队(enqueue)与出队(dequeue)操作,并提供了完整的运行结果分析,帮助开发者掌握Python数据结构的核心应用。
本文详细介绍Python中单向链表的完整实现方法,涵盖节点定义、链表初始化、长度计算及空判断。重点演示头插、尾插、指定位置插入、元素删除与查找等核心操作,并提供包含遍历功能的完整代码示例,帮助开发者掌握链表数据结构的基础应用。
本文介绍如何使用Python实现获取单向链表倒数第K个节点的值。通过定义链表节点类,结合长度校验与双指针(快慢指针)技术,高效定位目标节点。文章包含完整代码示例及运行结果,适用于Python数据结构学习与算法实践参考。
本文介绍如何使用Python的python-docx库读取Word文档中指定位置的表格数据。通过定位特定文本段落后的表格元素,提取单元格内容并处理,适用于自动化办公场景。
本文详细介绍Python中导入模块的四种核心方法:直接导入整个模块、导入特定函数、导入所有函数以及使用别名导入。通过具体代码示例解析import和from...import语句的区别与适用场景,帮助开发者规范代码结构并提高开发效率。
本文详细介绍Python中Numpy库的核心基础。涵盖ndarray对象的创建方式、数据类型定义及shape/size属性;深入解析基于下标、布尔及花式索引的数组访问方法;重点讲解不同形状数组间的广播运算原理与tile函数实现;最后汇总常用的数学、算术及排序函数,帮助开发者高效进行科学计算。
本文详细介绍pandas中遍历Dataframe的三种核心方法:iterrows、itertuples和iteritems。通过对比分析,说明iterrows按行返回(index, Series)对,itertuples按行返回元组且效率更高,iteritems按列返回(列名, Series)对。文章提供具体代码示例,帮助开发者根据性能需求和访问方式选择最合适的数据遍历方案。

本文介绍在Python中使用Pandas库遍历DataFrame每个元素的两种方法。第一种利用applymap函数结合逻辑索引,实现全表快速筛选;第二种通过遍历列名并使用Series.str.contains进行逐列处理。文章对比了两种方式的适用场景,并强调高阶函数在提升数据处理效率方面的优势。
本文详解Python3中如何实现List的多级排序。重点讲解sorted函数移除cmp参数后,如何通过key结合lambda表达式实现按多个元素排序。通过具体代码示例,展示如何自定义排序规则,如先按第一个元素再按第二个元素排序,并提供完整的代码实现与输出结果分析。
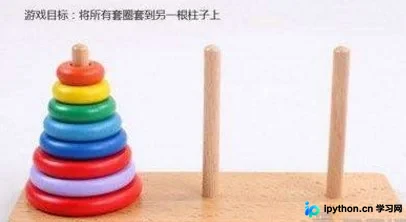
本文详细介绍使用Python实现汉诺塔算法的方法。文章阐述了汉诺塔的三条基本规则,并通过三阶汉诺塔的具体案例,深入解析了递归函数的调用逻辑与执行步骤。提供了完整的Python代码示例及程序运行结果,帮助读者理解形参与实参的区别,掌握递归在解决复杂移动问题中的应用。
本文详细解析在 Pandas 中遍历 DataFrame 行的多种方法。重点对比了 iterrows()、itertuples()、apply() 以及 iloc 的性能差异与适用场景。文章指出 itertuples() 通常比 iterrows() 更快,并强调避免在迭代中修改数据的重要性,同时提供自定义 namedtuple 迭代器以进一步提升处理效率。