

Python利用pandas一行代码爬取网页表格数据
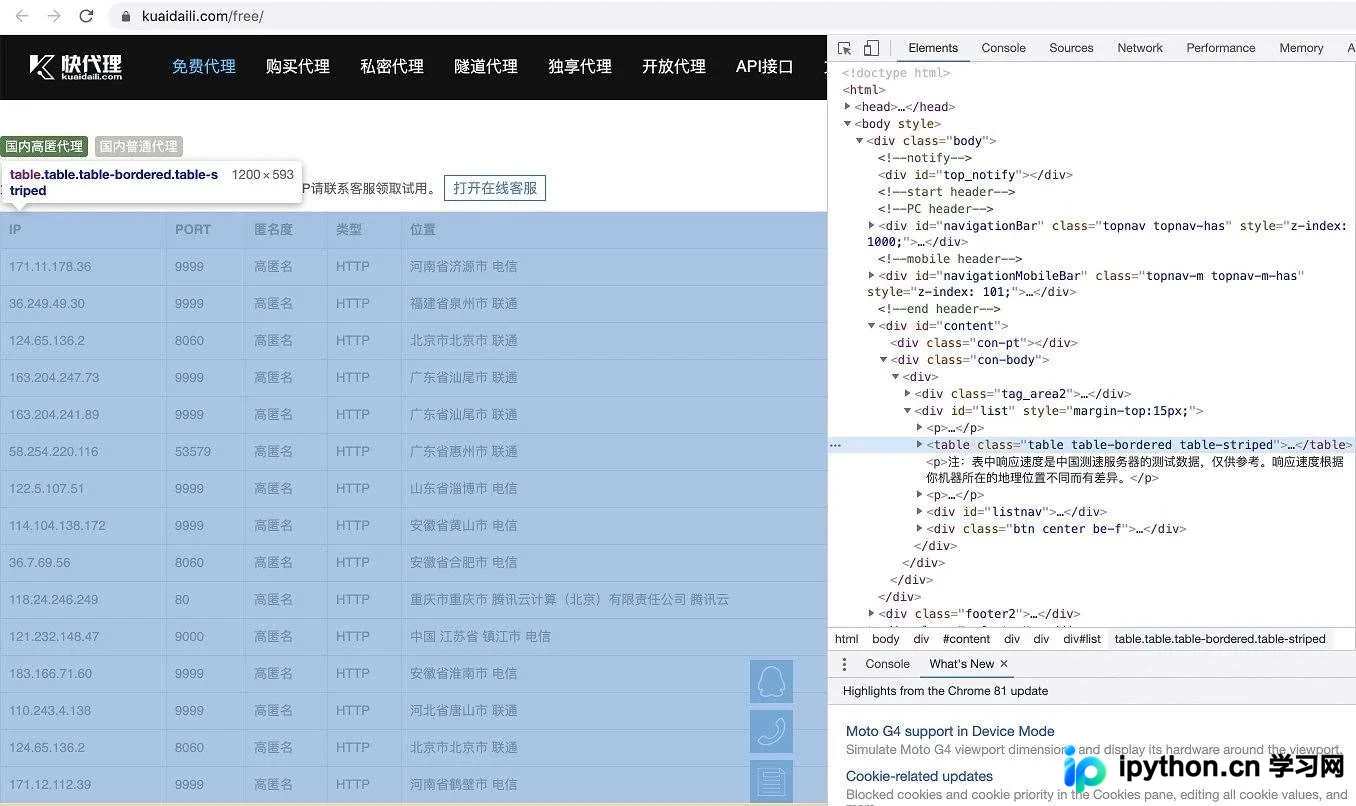
本文介绍如何使用Python的pandas库通过一行代码高效抓取网页表格数据。相比传统结合requests和bs4的复杂解析方式,pd.read_html()能直接处理URL并返回DataFrame对象。文章详细演示了从抓取代理IP网站表格到保存为CSV文件的完整流程,并解析了read_html函数的常用参数及返回值处理技巧,帮助开发者简化数据采集工作。
2026-10-13
10

本文介绍如何使用Python的pandas库通过一行代码高效抓取网页表格数据。相比传统结合requests和bs4的复杂解析方式,pd.read_html()能直接处理URL并返回DataFrame对象。文章详细演示了从抓取代理IP网站表格到保存为CSV文件的完整流程,并解析了read_html函数的常用参数及返回值处理技巧,帮助开发者简化数据采集工作。
本文详细解析Python中sort、sorted、reverse和reversed四个函数的核心区别。重点说明sort和reverse为原地修改方法,仅适用于列表;而sorted和reversed为内置函数,支持多种可迭代对象并返回新结果。文章还深入讲解了sorted函数的cmp、key及reverse参数的具体用法与示例,帮助开发者根据实际需求选择正确的排序与反转方式。
本文详解Python中Unicode字符串与普通字符串的相互转换方法,包括encode与decode的具体用法。同时提供利用json模块解决Python列表输出时Unicode编码未正确显示为中文的问题,通过设置ensure_ascii=False实现格式化输出,并介绍如何反向解析恢复数据。
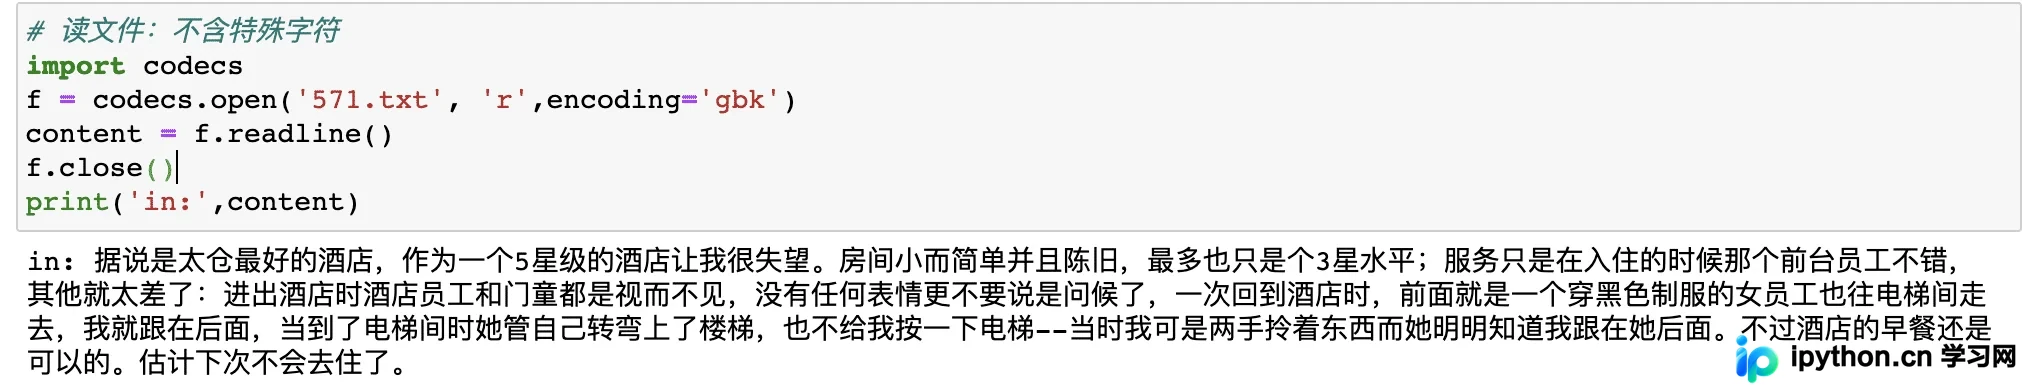
本文解析Python中使用codecs模块读取文件时遇到的UnicodeDecodeError错误。当utf-8与gbk编码均无法正确解析文件,且出现乱码或特殊字符时,可通过在codecs.open中设置errors="ignore"参数来忽略无法解码的字节,从而正常读取文件内容。
本文介绍在Python爬虫或数据处理中,当保存的中文数据呈现为Unicode编码格式时,如何利用eval函数将其还原为可读字符串。通过解析Python表达式,eval可将表示字符串的Unicode字面量转换为实际字符。文章同时补充了使用str或repr函数处理特殊字符的基础知识,并提供相关代码示例以供参考。
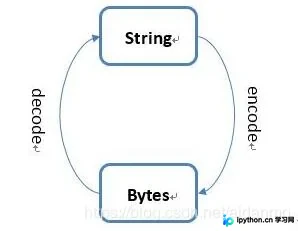
本文深入解析Python3中字符串与字节流的区分机制,详细演示如何使用encode和decode方法处理\xe6\x97\xa0\xe6\xb3\x95格式的乱码。通过raw_unicode_escape编码及str()构造函数,提供将字节串转换为可读汉字的实用代码示例,并涵盖从网络抓取网页时处理中文乱码的实际应用技巧。
本文介绍如何在Python中将字典内的Unicode编码字符转换为中文显示。主要方法包括使用json.dumps配合decode('unicode-escape'),以及通过ord()函数获取字符编码并以16进制格式打印。同时涵盖从UTF-8或GBK文件读取字符串并转换为Unicode字符串的操作。
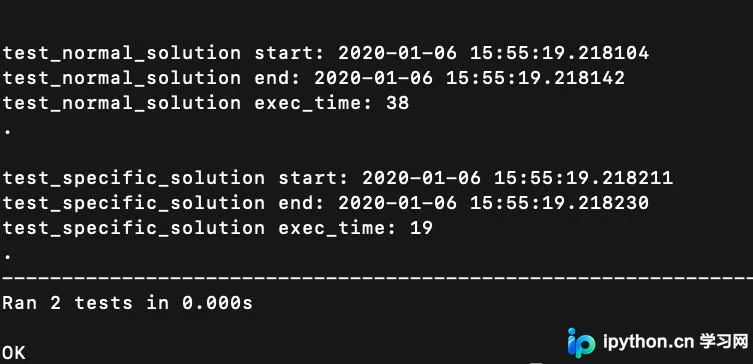
本文介绍在 Python 中查找出现次数超过数组长度一半元素的两种方法。首先展示基于字典计数的通用解法,适用于任意频次统计;随后提供针对该特定条件的优化解法。文章包含完整的单元测试代码、运行结果及执行时间分析,帮助开发者理解不同场景下的实现策略。
本文详细介绍如何利用Ansible Playbook实现KVM虚拟化环境的自动化部署及Python3环境的配置。内容涵盖YAML基础语法、Playbook核心组件解析,并提供完整的自动化脚本示例与执行命令,帮助运维人员快速掌握批量服务器配置技巧,提升部署效率。
本文深入解析Python内置库urllib.request,涵盖其核心模块功能及常用方法。通过读取内容、获取URL、状态码及HTTP头信息等案例,演示如何模拟浏览器发起HTTP请求,并展示文件保存与图片下载的完整代码实现,适合Python初学者快速掌握网络数据抓取基础。
本文介绍如何在Python中将字典转换为对象,从而实现通过点号(.)访问属性的便捷方式。通过自定义Dict类并重写特殊方法,实现递归转换嵌套字典。同时详细解析vars()函数的用法,展示如何提取对象的属性和属性值,返回字典类型,帮助开发者更灵活地处理数据结构。
本文详细介绍如何使用Python调用阿里云市场提供的短信验证API接口。内容涵盖接口地址、请求方式、参数说明及返回示例,并提供完整的Python代码实现与CURL命令示例,帮助开发者快速集成短信发送功能。