Python 格式化输出百分比的两种方法及参数详解
本文介绍在Python中输出百分比的两种主要方式:使用{:.2%}直接格式化,以及先转为float再拼接%符号。详细解析了小数位控制、参数序号指定及format函数的使用细节,适用于Python3环境。
2026-10-14
7

本文介绍在Python中输出百分比的两种主要方式:使用{:.2%}直接格式化,以及先转为float再拼接%符号。详细解析了小数位控制、参数序号指定及format函数的使用细节,适用于Python3环境。
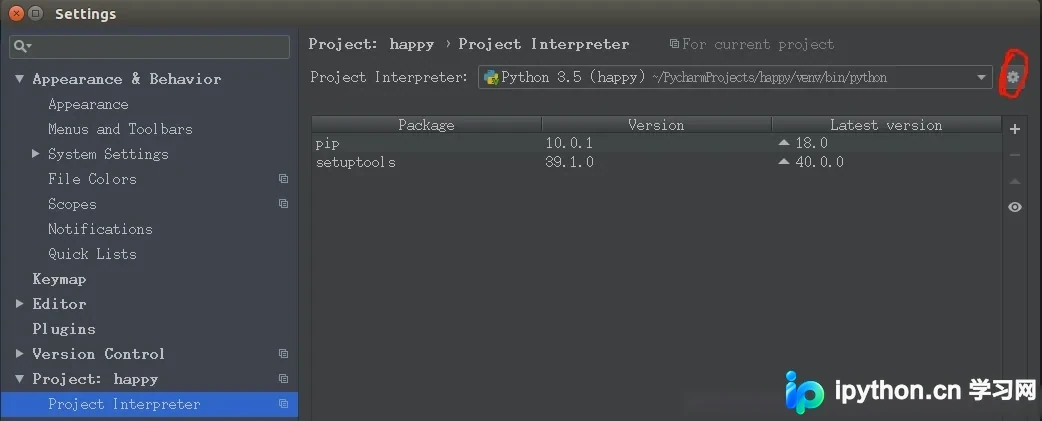
本文详细介绍在 PyCharm 中配置 Anaconda 解析器的具体操作步骤。通过 File-Settings-Project Interpreter 路径添加 Python 解释器,定位 Anaconda 安装目录下的 bin 文件夹中的 python 可执行文件,即可让 PyCharm 识别并调用 Anaconda 环境中的各类第三方包,实现无缝开发。
本文详解 Python 中使用 Elasticsearch 进行数据翻页的三种方式。针对大数据量场景,传统 from+size 浅分页存在性能瓶颈,推荐使用 scroll 滚动查询或 search_after 基于游标的深分页。文章对比了各方案的原理、适用场景及代码实现,帮助开发者解决 ES 集群内存压力与数据一致性难题。
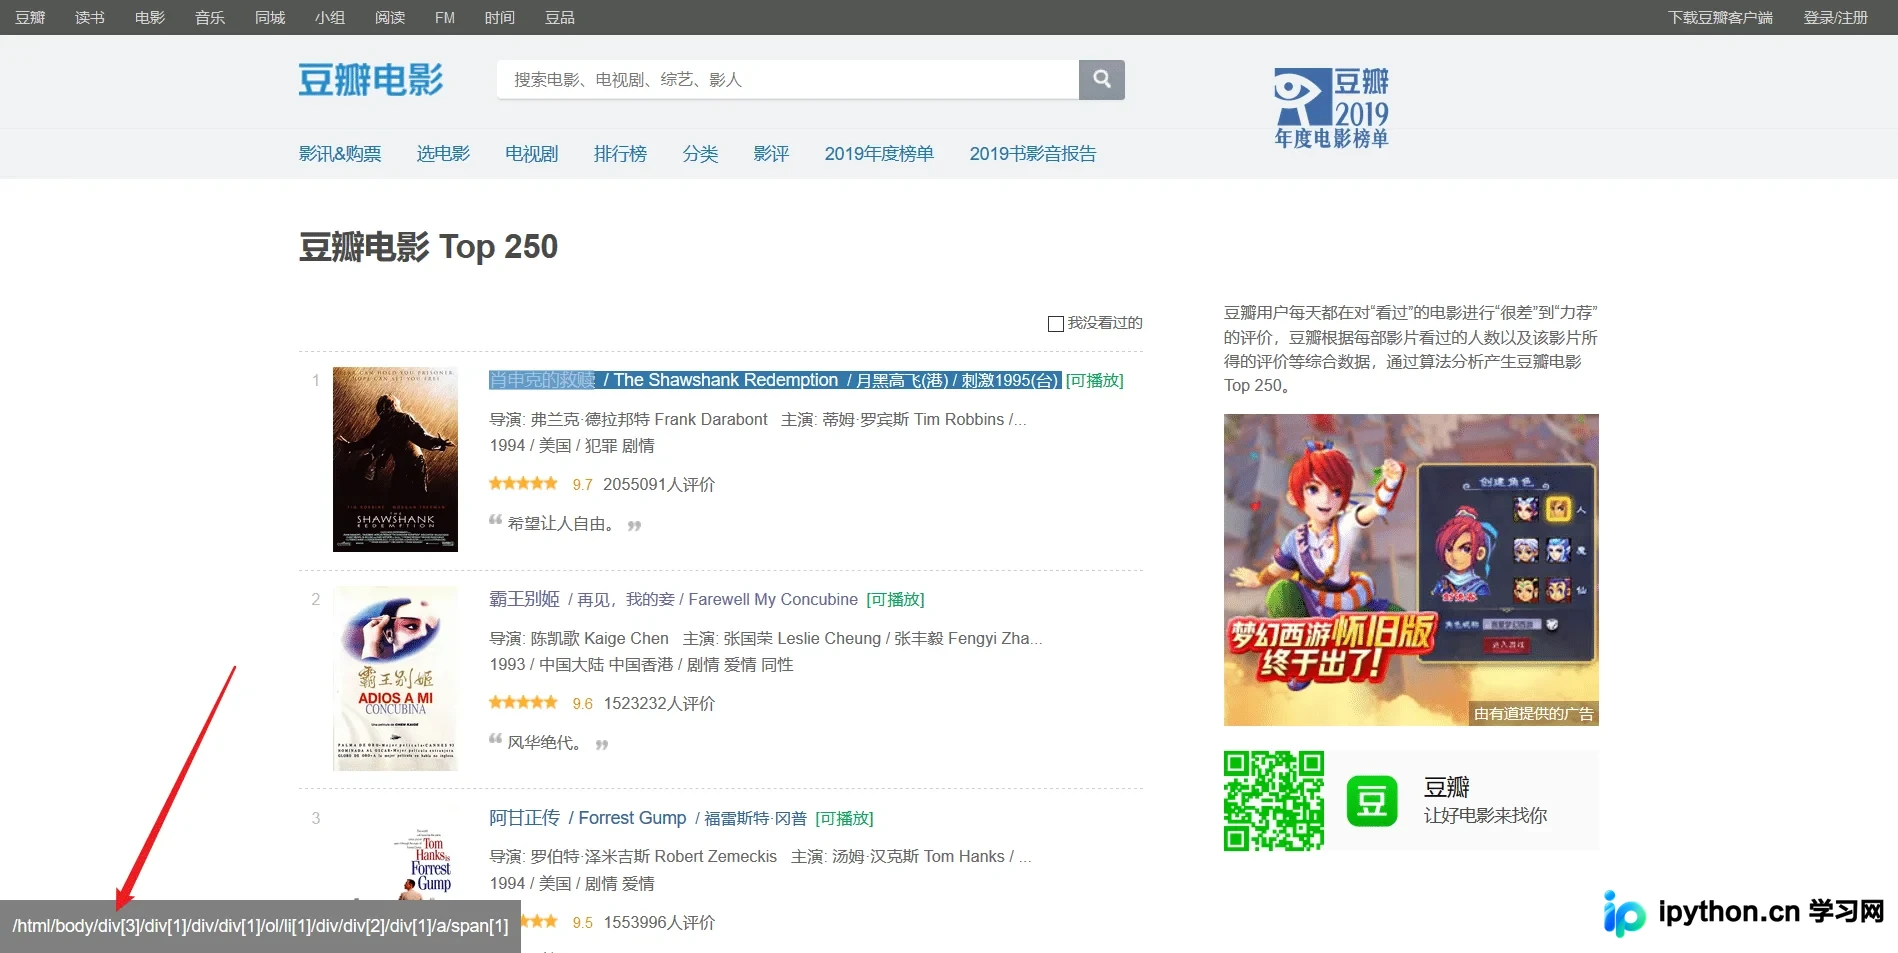
本文详解如何使用Python爬虫技术抓取豆瓣电影Top250榜单数据。通过requests库处理反爬机制,利用lxml进行XPath解析,并结合xlwt库将电影名称、评分及简介等信息批量写入Excel文件。文中包含完整的代码示例及异常处理方案,适合Python初学者参考学习。
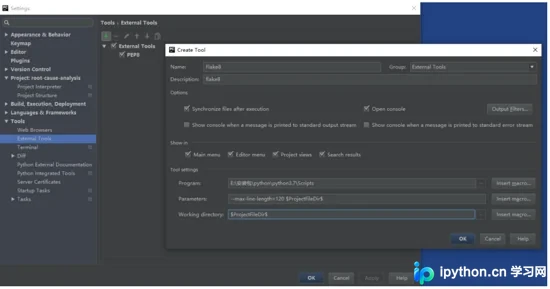
本文详细介绍Python代码规范性检测的两种主流方案:静态本地检测与Git Hook集成。重点讲解如何使用Flake8进行PEP8、语法及复杂度检查,并在PyCharm中配置参数;同时深入解析Pre-commit工具的安装、配置及在git commit前自动执行代码规范检查的流程,帮助开发者提升代码质量。
本文解析Python中统计执行时间的常见误区,指出time.clock()仅统计CPU时间而非实际程序耗时。通过对比datetime.datetime.now()、time.time()和time.clock()三种方法,说明如何准确获取包含IO和等待时间的真实程序执行时间,帮助开发者避免生产环境中的监控偏差。
在使用Python lxml库解析HTML数据时,常因网页编码与程序解码不一致导致中文显示为乱码。本文介绍通过XPath定位节点后,利用encode('ISO-8859-1').decode('UTF-8')方法进行编码转换的技巧,有效解决数据抓取中的字符显示异常问题。
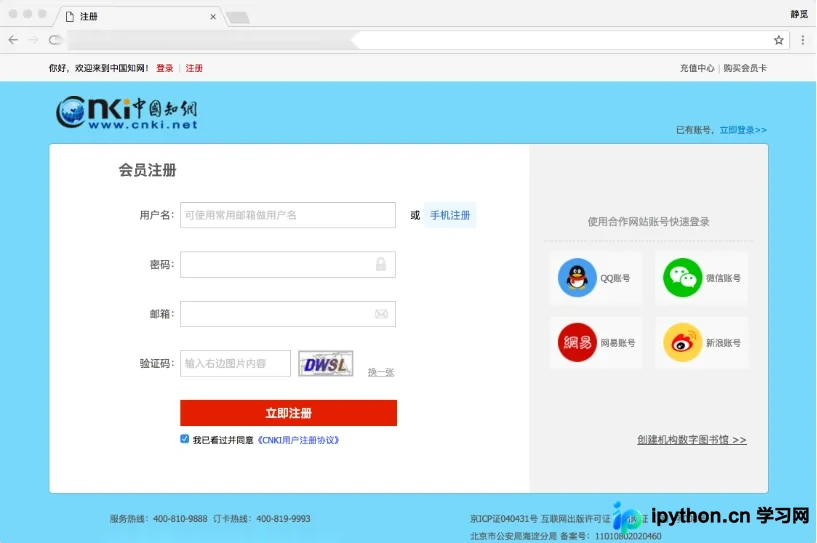
本文详细讲解在Python3爬虫中如何使用Tesserocr库识别简单的图形验证码。内容涵盖从获取验证码图片、直接调用OCR接口,到通过灰度转换和二值化处理去除干扰线条以提高识别准确率的全过程。结合知网注册页面实例,提供完整的代码示例与参数设置说明,帮助开发者解决验证码识别难题。
本文详解如何在Python中为元类定义可选参数,通过修改__prepare__、__new__和__init__方法并强制使用关键字参数,实现对类创建过程的精细控制。对比类变量方式,阐述参数传递的优势及注意事项,帮助开发者掌握高级元类编程技巧。
本文详解Python中实现字符串对齐的多种方法,包括ljust、rjust和center内置函数,以及更通用的format()函数。通过示例展示如何指定宽度和自定义填充字符,对比旧式%操作符,推荐在代码中优先使用format()以实现更灵活的对象格式化。
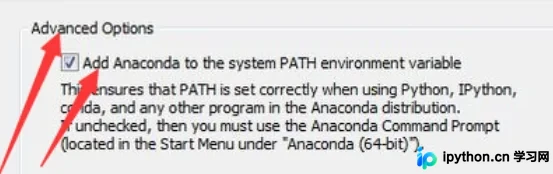
本文详细记录在Windows 10环境下,使用Anaconda和PyCharm安装TensorFlow 2.2的完整流程。涵盖从Visual Studio、Anaconda基础安装,到创建独立conda环境、配置CUDA 10.1与cuDNN 7.6 GPU支持,以及最后在PyCharm中绑定解释器并验证安装成功的全过程。
本文深入解析Python爬虫的核心原理,涵盖发起请求、获取响应、解析内容及保存数据四大基本流程。详细阐述HTTP Request与Response的结构,包括GET/POST等请求方式及状态码含义,并介绍正则、BeautifulSoup等数据解析技术,以及针对JS渲染数据的Selenium等解决方案。