pandas.DataFrame.drop_duplicates 参数详解与去重实战
本文详细介绍pandas库中DataFrame.drop_duplicates函数的使用方法,重点解析subset、keep和inplace三个核心参数的具体含义与配置选项。通过实际代码示例,演示如何指定列进行去重、保留首尾重复项或完全删除重复数据,帮助开发者高效处理数据清洗中的重复值问题。
2026-10-14
9

本文详细介绍pandas库中DataFrame.drop_duplicates函数的使用方法,重点解析subset、keep和inplace三个核心参数的具体含义与配置选项。通过实际代码示例,演示如何指定列进行去重、保留首尾重复项或完全删除重复数据,帮助开发者高效处理数据清洗中的重复值问题。
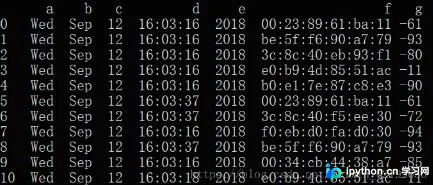
本文介绍如何利用Python的Pandas库高效处理Excel数据,重点演示删除表格中的重复行及空值。通过read_excel读取数据,使用duplicated和drop_duplicates函数识别并去除重复记录,支持按指定列去重及保留策略配置。同时涵盖缺失值检测与删除方法,适用于大数据集的自动化预处理场景。
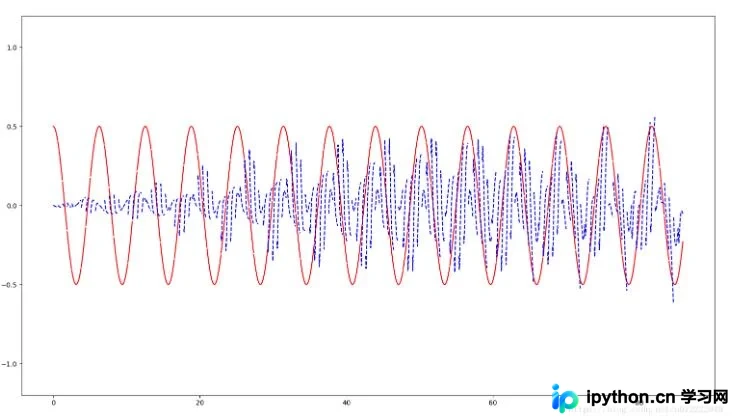
本文探讨了在TensorFlow中混合使用Keras Function API与原生TF算子时,GRU层initial_state未正确更新导致预测波形断续且不收敛的问题。通过对比Keras封装代码与原生dynamic_rnn实现,指出需手动管理状态更新。此外,还整理了TensorFlow除法运算中的类型匹配错误及tf.cast等常用函数的避坑指南。
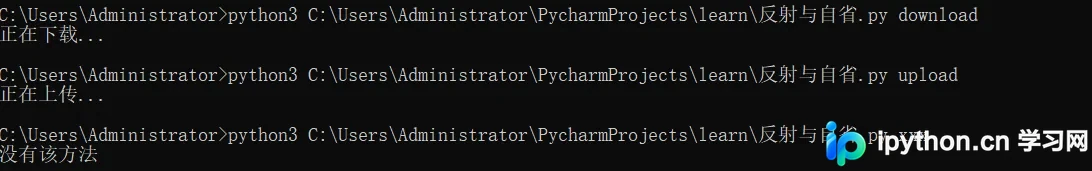
本文深入解析Python中的自省与反射概念,详细列举dir、hasattr、getattr等常用方法及其应用场景。通过代码示例展示如何动态获取和操作对象属性,并进一步剖析反射机制在底层如何通过__getattribute__、__setattr__等双下方法实现,帮助开发者理解Python动态特性的内部工作原理。
本文介绍如何在Windows命令行中启动Python交互环境,并详细列出三种退出方法:Ctrl+Z加回车、输入exit()或quit()。同时解析命令行模式与Python交互模式的区别,包括提示符差异、执行方式及适用场景,帮助初学者快速掌握基础操作。
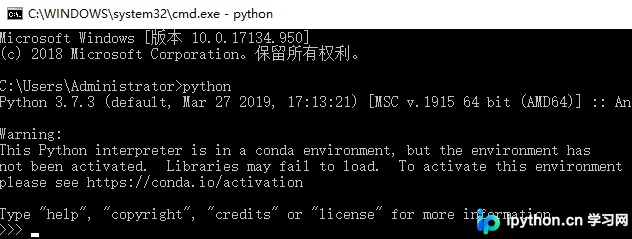
本文介绍如何在Python3中使用转义序列实现终端输出的彩色字符串。详细解析了\033[开头和\033[0m结尾的格式规范,涵盖显示方式、前景色及背景色的数值参数含义,并提供完整的Python代码示例,展示高亮、下划线、闪烁及多种颜色的具体应用效果。
本文详解Python中三引号(单引号与双引号)的输入方法及特殊用途。对比普通引号在多行字符串处理上的局限,展示如何利用三引号实现多行注释及保留原始格式的文本输出,帮助开发者高效处理复杂字符串场景。
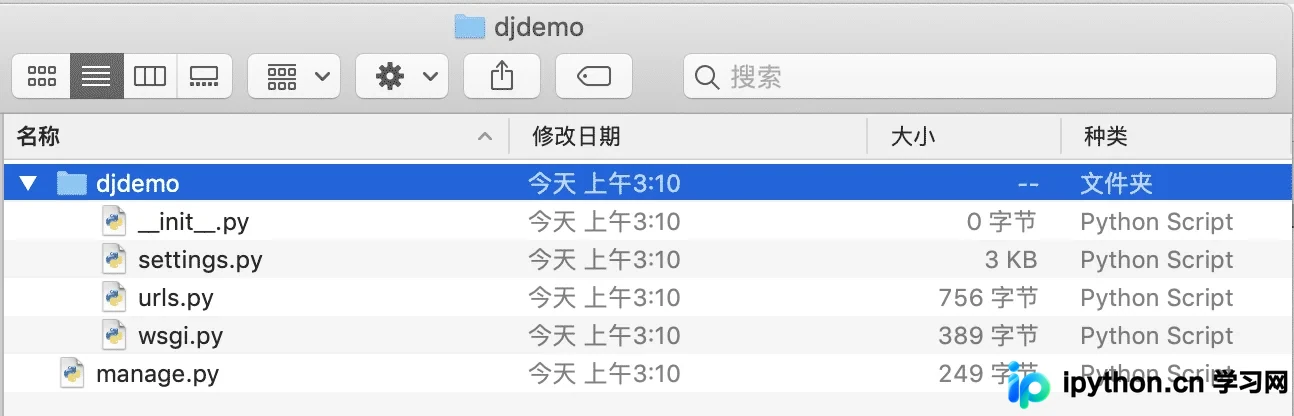
本文详细解析Django项目的创建流程,涵盖虚拟环境配置、项目骨架搭建、应用模块生成及注册、以及本地服务启动验证。通过具体命令与目录结构说明,帮助开发者快速掌握Django基础开发环境搭建与核心文件功能。
本文深入解析Django中F()函数的核心机制与应用场景。通过对比传统内存更新方式,阐述F()函数如何实现数据库层面的原子操作,从而显著提升性能并避免并发竞争问题。同时覆盖跨字段比较、算术运算、日期处理及跨关系查询等高级用法,帮助开发者写出更高效、安全的ORM代码。
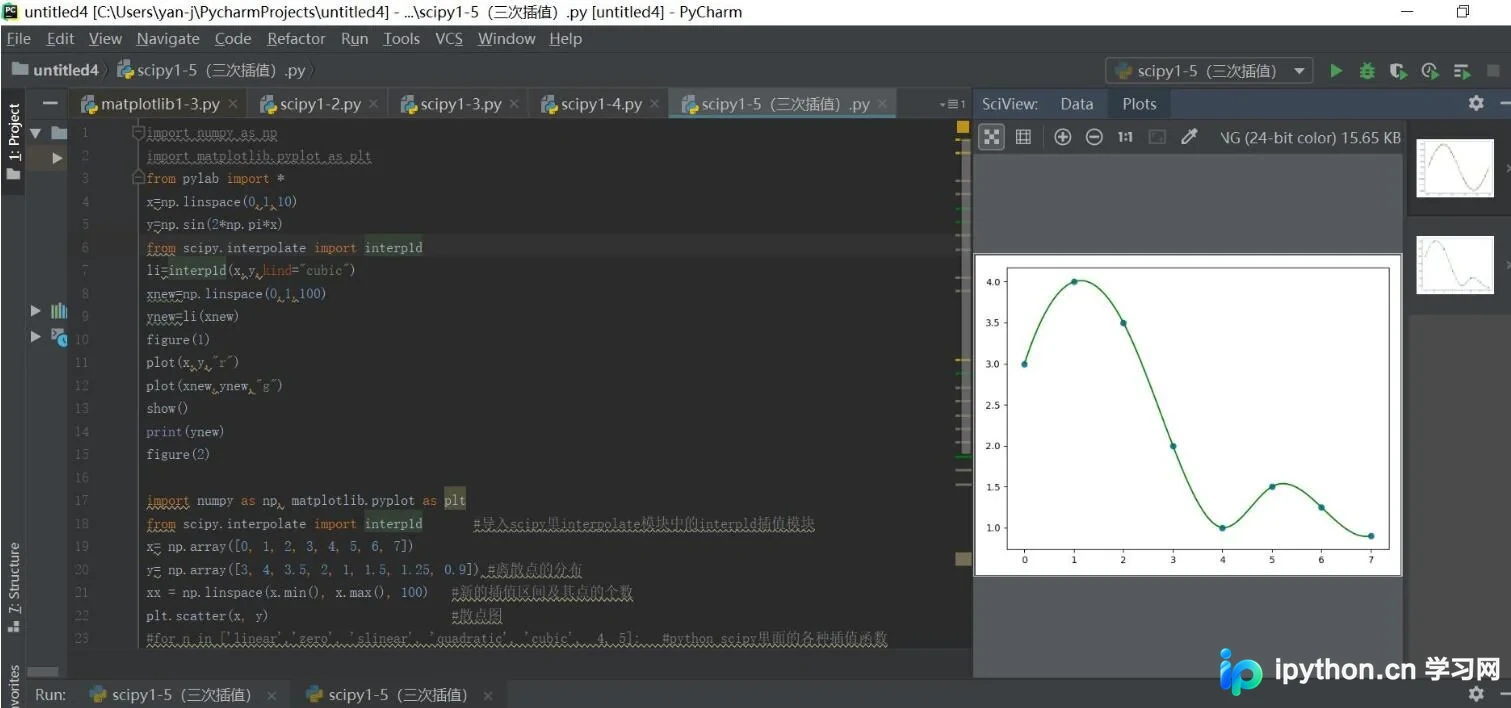
本文介绍Python中scipy库的interpolate模块,重点讲解interp1d函数的用法。通过实例演示如何定义横纵坐标并选择cubic等插值方式,展示从原始数据点到平滑曲线的生成过程。文中列出了nearest、zero、slinear、quadratic及cubic等多种插值类型的区别,适用于需要数据平滑处理的技术场景。
本文详解如何在单向链表中删除指定值的节点。通过引入哨兵节点简化边界处理,并结合双指针技术高效定位目标。提供Python和C++两种语言的完整实现代码,重点解析指针移动逻辑与内存管理细节,帮助开发者掌握链表操作的核心技巧。
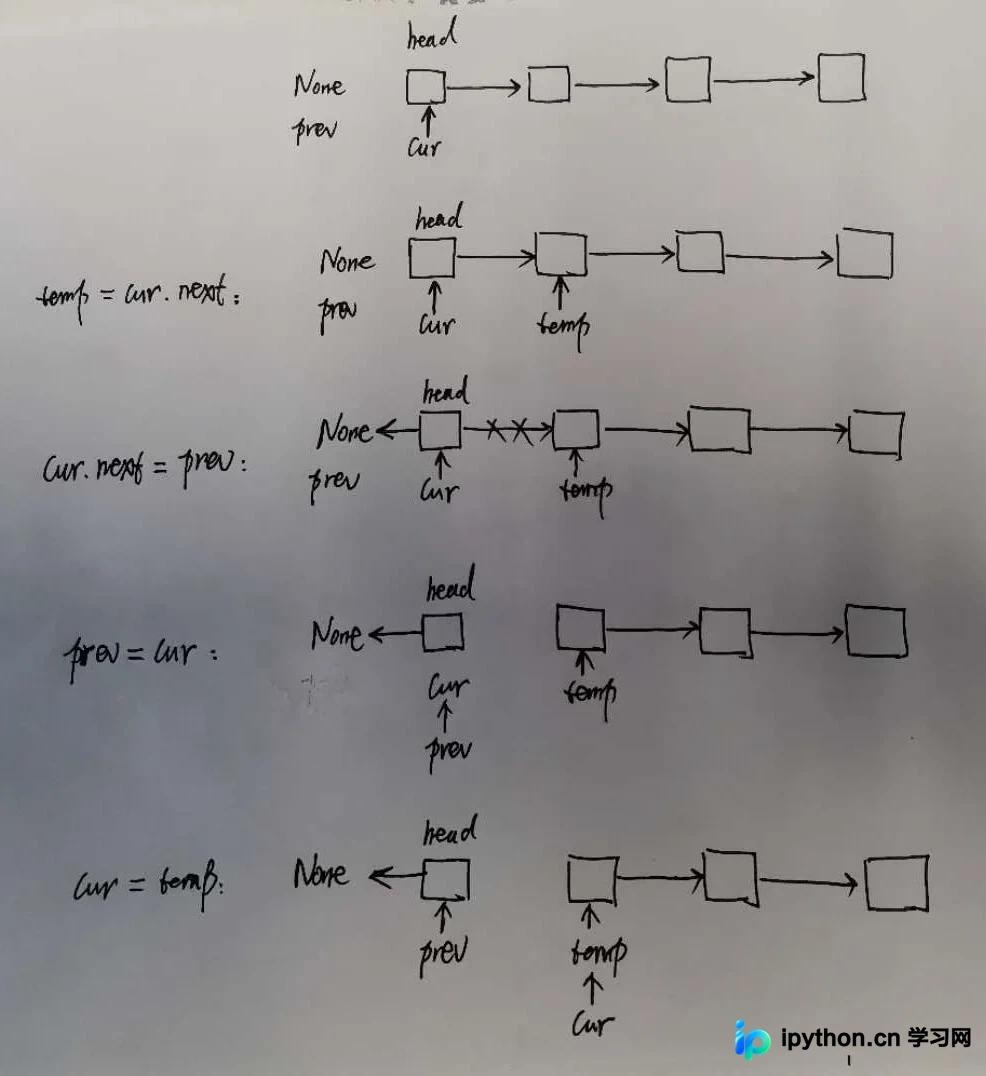
本文详细介绍如何使用Python反转单链表,提供迭代和递归两种核心解法。通过双指针和三指针技巧,确保节点不丢失。包含完整代码示例,帮助开发者掌握链表操作的基础与进阶技巧。