Python实现K-means聚类算法详解:原理、流程与代码
本文详细介绍K-means聚类算法的原理、目标函数及Python实现流程。涵盖初始化质心、迭代更新与收敛判断,提供基于sklearn与手动实现的代码示例,并分析算法优缺点及注意事项。
2026-10-14
6

本文详细介绍K-means聚类算法的原理、目标函数及Python实现流程。涵盖初始化质心、迭代更新与收敛判断,提供基于sklearn与手动实现的代码示例,并分析算法优缺点及注意事项。
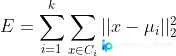
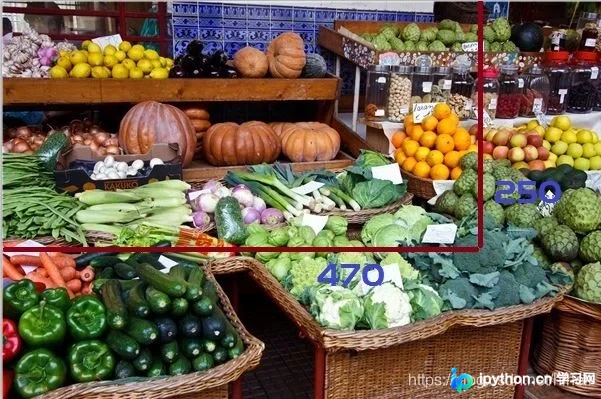
本文详解OpenCV中图像像素的读写技巧,涵盖BGR通道拆分、特定像素点修改及numpy高效操作法。同时解析图像shape、size、dtype等关键属性,通过实例演示彩色与灰度图差异,并解决常见读取错误,助力掌握图像底层处理。
本文深入解析Python中正则表达式的应用,详细介绍re模块的核心函数如compile、match、search、findall及split的用法。通过用户名验证、手机号提取、网页抓取及内容过滤等实际案例,展示如何高效处理字符串匹配与替换,帮助开发者掌握正则表达式在Python中的最佳实践。
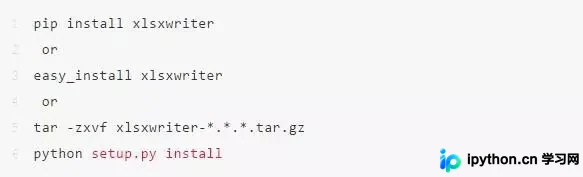
本文详细介绍如何利用Python的xlsxwriter库实现Excel文件的自动化处理。内容涵盖从环境安装到基础数据写入,再到单元格格式设置、多种数据类型(字符串、数字、公式、日期等)的精准控制,以及动态图表的创建。通过具体代码示例,帮助开发者掌握高效生成标准化Excel报表的技术要点,适用于办公自动化场景。
本文详细解析Python无参装饰器的实现过程,从基础概念出发,通过三种方案逐步优化,解决参数传递、返回值保留及代码冗余问题,最终展示标准模板与@语法糖的使用。
本文深入解析Python中常用的数据标准化方法,包括Min-Max归一化、Z-Score标准化以及针对稀疏和离群数据的MaxAbs与RobustScaler。通过具体代码实例展示StandardScaler的使用,并对比不同算法对数据结构及异常点的影响,帮助开发者根据数据特征选择最优标准化策略。
本文深入解析Python环境下的模型集成技术,强调模型多样性对提升预测性能的关键作用。详细对比了简单平均与加权平均两种集成策略,并系统介绍了Bagging(挂袋法)、加权提升法及梯度提升法的核心原理与适用场景,为构建更稳定、准确的机器学习模型提供理论依据与实践指导。
本文详细解析Python列表的核心特点,包括其作为有序可变数据集合的本质,支持方括号定义及逗号分隔语法。列表可存储任意类型数据,支持嵌套与重复值,并通过正序(从0开始)和倒序(从-1开始)索引进行元素访问与操作。
本文总结Python深度学习中的高级架构模式,重点解析残差连接如何解决梯度消失问题,以及深度可分离卷积(SeparableConv2D)在提升训练速度与精度方面的优势。通过Keras代码示例,展示标准化、残差块及轻量级卷积层的实际应用,帮助开发者构建更高效的大规模模型。
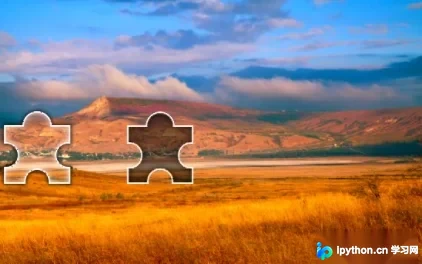
本文详解如何利用OpenCV图像处理与Selenium自动化测试技术解决滑块验证码问题。通过截取背景图与滑块小图,进行灰度处理与二值化定位缺口,并结合随机轨迹模拟人类操作,实现自动通过验证。
本文详细介绍如何利用Python的Turtle库制作七夕比心表白代码。通过定义心形和小人绘制的函数,结合文字添加功能,实现个性化的浪漫表达。文章提供了完整的代码示例和参数修改指南,帮助开发者轻松创建独特的节日惊喜,展现IT人的独特浪漫情怀。
本文详细解析Python中文本文件的创建、读写及路径管理操作。涵盖open函数的多种模式(r/w/a等)、write与read方法的使用细节、多行读写技巧、文件指针定位(seek/tell)以及基于os模块的路径判断与文件夹创建。同时包含文件异常处理的规范写法,帮助开发者掌握稳健的文件处理流程。