Python爬虫中HTTP代理的应用与分类详解
本文介绍Python爬虫使用HTTP代理的必要性及作用,包括提升访问速度、隐藏真实IP以及突破IP限制。同时详细解析了FTP、HTTP、SSL/TLS、SOCKS等常见代理类型的功能与端口,为开发者提供实用的代理配置参考。
2026-10-14
7

本文介绍Python爬虫使用HTTP代理的必要性及作用,包括提升访问速度、隐藏真实IP以及突破IP限制。同时详细解析了FTP、HTTP、SSL/TLS、SOCKS等常见代理类型的功能与端口,为开发者提供实用的代理配置参考。
本文总结了pandas中创建DataFrame的三种主要方式:通过列表或数组、通过字典参数以及直接读取Excel和CSV文件。文章详细讲解了各方法的代码实现与参数设置,并指出实际工作中直接读取数据文件是最高效且常用的做法,适合初学者快速掌握数据框构建技巧。
本文深入解析Python中property属性的两种实现方式:@property装饰器与property类属性。详细对比了旧式类与新式类在访问方式上的差异,并通过圆形面积、分页计算及商品管理等实例,演示了如何安全地封装数据,实现属性的获取、修改与删除功能,帮助开发者选择最适合的代码风格。
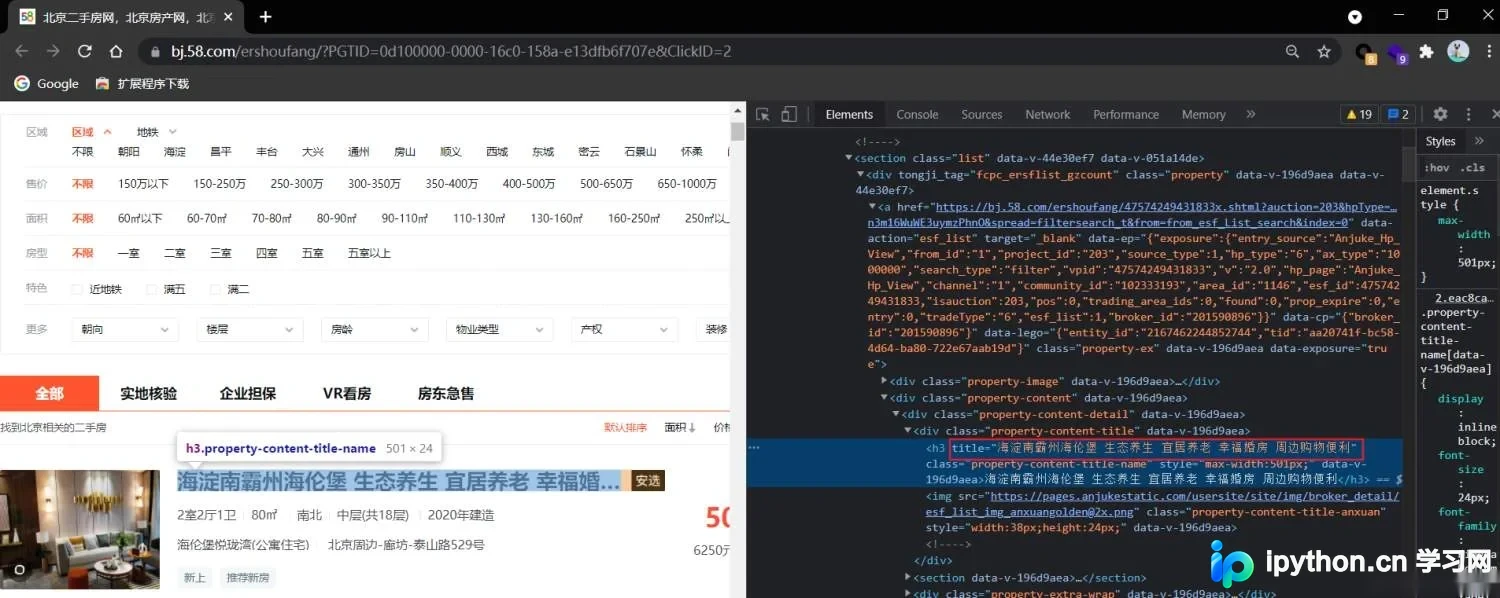
本文详细介绍Python中XPath数据解析的原理与应用。涵盖lxml库的安装、etree对象的实例化方法,以及通过XPath表达式定位标签和提取文本或属性值的技巧。结合58同城二手房案例,演示如何处理浏览器显示与源码结构的差异,提供完整的代码示例与注意事项。
本文通过Python的Tkinter库展示了一个绘制雪人的完整案例。文章提供了详细的源码注释,涵盖从定义基础形状类、帽子、身体到主程序实例化的全过程。旨在帮助初学者熟悉Python的基础画图操作,包括画布创建、坐标定位及图形绘制方法,适合Python入门者参考学习。
本文通过Python的PyQt5库实现哆啦A梦的图形绘制,详细解析了从几何形状构建到界面渲染的全过程。文章提供了包含头、身体、五官等部件的完整代码及逐行注释,帮助开发者深入理解Qt绘图API的使用及面向对象图形编程技巧。
本文深入解析 Python 中对象序列化的两种核心方式:pickle 与 json。pickle 适用于 Python 内部数据交换,支持自定义对象但仅限 Python 环境;json 则提供跨语言标准格式,便于网络传输与存储。文章详细对比两者差异,并通过代码示例演示如何处理自定义类的序列化问题,包括使用 default 参数和 __dict__ 属性等技巧。
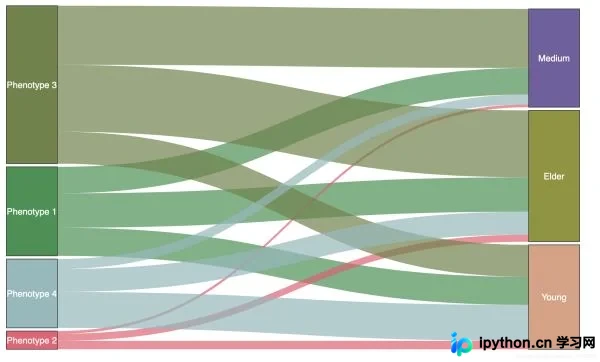
本文详解如何在Python中使用Pyecharts库绘制桑基图并自定义节点颜色。通过配置itemStyle中的color属性,可固定节点显示颜色,避免随机渲染。同时说明line_color设为'source'时连线与节点同色,并强调应使用itemStyle控制颜色,而非已失效的label相关属性。
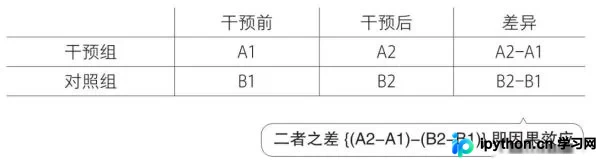
本文详解如何利用Python的statsmodels库进行双重差分模型(DID)计算及P值获取。通过构建时间、分组及交互项,使用OLS多项式拟合方法评估政策干预效果,并解读回归结果中的系数与显著性。
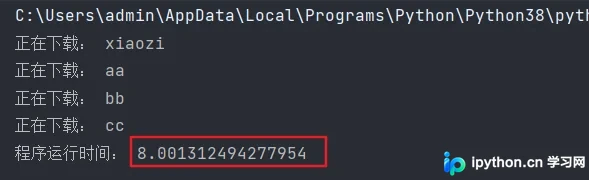
本文详细解析Python异步爬虫中处理多个URL请求时的性能优化方案。通过对比单线程阻塞、多线程及线程池三种方式,展示了如何利用并发机制减少等待时间。重点介绍了线程池在降低系统开销方面的优势,并提供了具体的代码示例与运行结果分析,帮助开发者选择合适的并发策略。
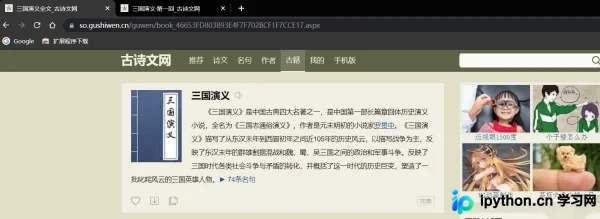
本文详细介绍Python中数据解析的概念,重点讲解BeautifulSoup库的安装与核心用法。通过实例演示如何利用BeautifulSoup定位HTML标签、提取文本内容及属性值,并完整展示爬取三国演义章节及内容的Python代码实现过程。
本文详细介绍Scrapy项目通过scrapyd进行服务器部署的完整流程。涵盖scrapyd的安装、配置文件修改以实现远程访问、scrapyd-client的使用、项目发布及爬虫调度命令。同时介绍Gerapy可视化管理工具的安装与基础配置,帮助开发者实现高效、可视化的爬虫运维管理。