

Python中pandas的dataframe过滤数据方法
在pandas中处理DataFrame时,布尔索引是最常用的行过滤方式。本文系统梳理单列条件、多条件组合及字符串匹配的写法,结合电影数据集演示完整筛选流程,并提示运算优先级与缺失值处理的易错点,帮助快速准确提取目标数据。
2026-10-11
20

在pandas中处理DataFrame时,布尔索引是最常用的行过滤方式。本文系统梳理单列条件、多条件组合及字符串匹配的写法,结合电影数据集演示完整筛选流程,并提示运算优先级与缺失值处理的易错点,帮助快速准确提取目标数据。
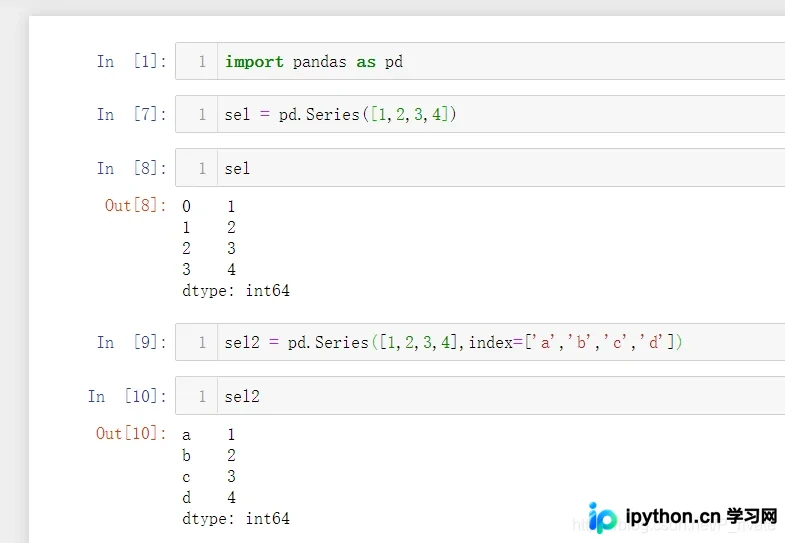
Pandas 的 Series 是用于存储一维序列的带标签数据结构,其底层由索引与值数组组成。本文通过可运行代码演示如何创建 Series、使用索引与切片访问元素、执行基础数学运算与标签对齐,并掌握 unique、value_counts 及 isin 等高效统计筛选方法,助您快速上手结构化数据的常规处理流程。
本文探讨Python代码风格的重要性,以PEP8为基准规范导入顺序与模块结构。通过Django视图示例,演示如何将HTML路径与错误信息封装至类中,利用filter替代try-except优化逻辑,提升代码可读性与维护性。
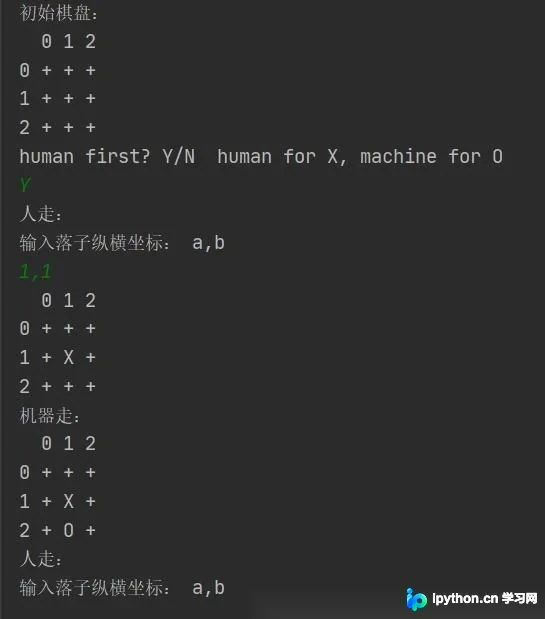
本文介绍如何使用Python实现一个简易的井字棋游戏。代码采用随机落子策略模拟电脑对手,利用递归函数处理无效落子,并通过嵌套循环检测棋盘胜负状态。文章提供完整的Python源码,涵盖初始化、人机交互、胜负判定及平局处理,适合初学者理解基础游戏逻辑与列表操作。
本文详解如何使用Python进行图片文字识别。涵盖Tesseract引擎的安装与系统环境变量配置,解决中文语言包缺失问题,并通过pytesseract与Pillow库实现单图及批量图片的OCR识别,同时分析不同字体与排版对识别准确率的影响。
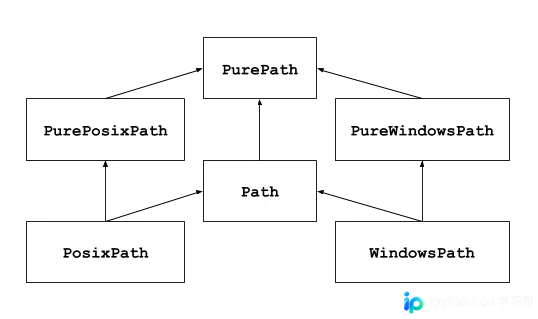
本文深入解析 Python 标准库 pathlib 的核心功能,涵盖路径提取、属性判断及文件遍历等常用操作。通过具体代码示例,展示如何高效处理文件路径,提升代码的可读性与跨平台兼容性。
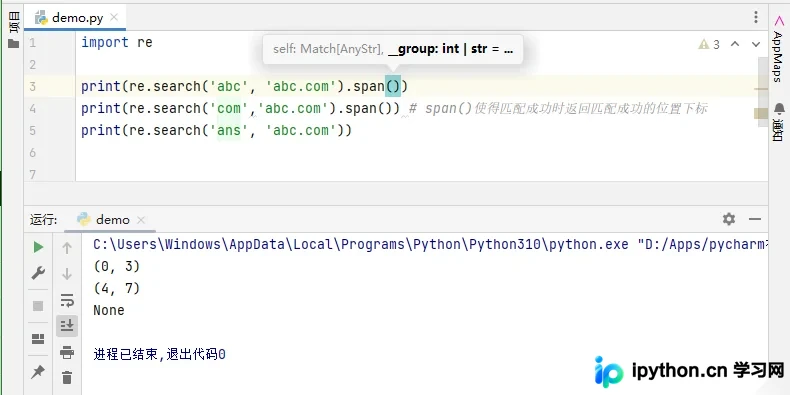
Python 正则表达式在进行文本处理时至关重要。本文详细拆解了 re 模块的核心操作,包括利用 search() 快速定位、findall() 批量提取、sub() 智能替换与 split() 灵活切割。结合动态回调函数与预编译优化策略,帮助开发者编写高可读性且高性能的数据清洗代码。
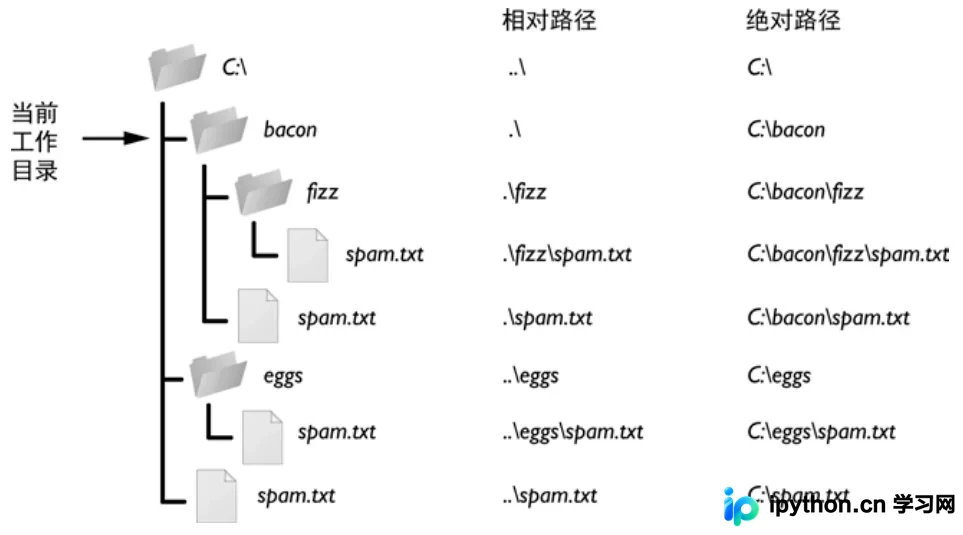
本文详解Python中文件路径的核心概念与常用操作方法。涵盖绝对路径与相对路径的区别、跨平台路径表示规范,以及使用os.path和glob模块进行目录创建、路径拼接拆分与通配符匹配。结合年月日尺度及内部元数据排序的实战代码,帮助开发者高效管理多文件批量处理流程。
本文深入解析Python中的函数嵌套机制。通过定义内部函数,探讨其对外部变量的访问权限与修改限制。重点讲解如何利用nonlocal关键字实现变量修改,以及函数作为返回值时的调用方式(如连续调用out_func()(()))。文章结合代码示例,清晰展示内部函数的作用域边界及闭包的实际应用。
本文介绍如何在Python深度学习项目中利用Albumentations库进行图像增强。重点演示了RandomSizedBBoxSafeCrop变换,确保在随机裁剪和缩放图像时保留所有边界框。通过完整代码示例,展示了如何定义可视化函数、加载COCO格式标注数据,并应用增强管道处理图像与边界框。
本文详细介绍 Python NumPy 库的高级功能,涵盖广播机制的自动维度对齐规则、向量化操作的底层加速原理、布尔与整数数组索引技巧、自定义字段的结构化数组构建方法,以及常用随机抽样函数。配合完整代码示例与结果验证步骤,帮助开发者提升科学计算效率与代码表现力。