

利用Python与Tesseract实现图片文字识别(OCR)

本文详解如何使用Python进行图片文字识别。涵盖Tesseract引擎的安装与系统环境变量配置,解决中文语言包缺失问题,并通过pytesseract与Pillow库实现单图及批量图片的OCR识别,同时分析不同字体与排版对识别准确率的影响。
环境配置与依赖安装
要实现基于Python的图片文字识别,首先需要部署底层的OCR引擎Tesseract。Tesseract(Text Recognition Engine)是一款开源的光学字符识别(OCR)工具,支持多种操作系统。安装过程分为引擎安装与Python依赖库配置两个阶段。
1. 部署Tesseract引擎
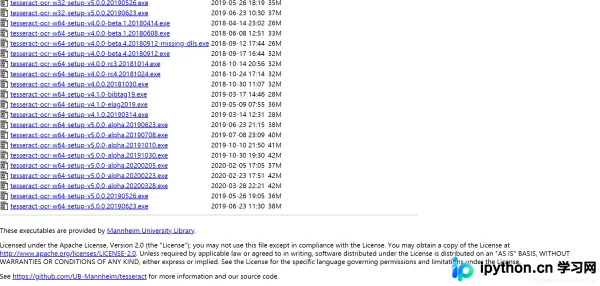
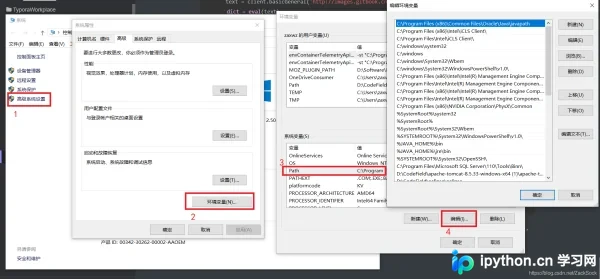
访问Tesseract官方发布页面,根据操作系统架构下载对应的安装包。若系统为32位,请选择带有“w32”标识的版本;若为64位系统,则选择“w64”版本。安装完成后,必须将Tesseract的安装目录添加至系统的环境变量Path中,以便命令行工具能够被全局调用。例如,若将Tesseract安装在 D:\CodeField\Tesseract-OCR 路径下,需确保该路径已正确配置。
2. 配置中文语言包
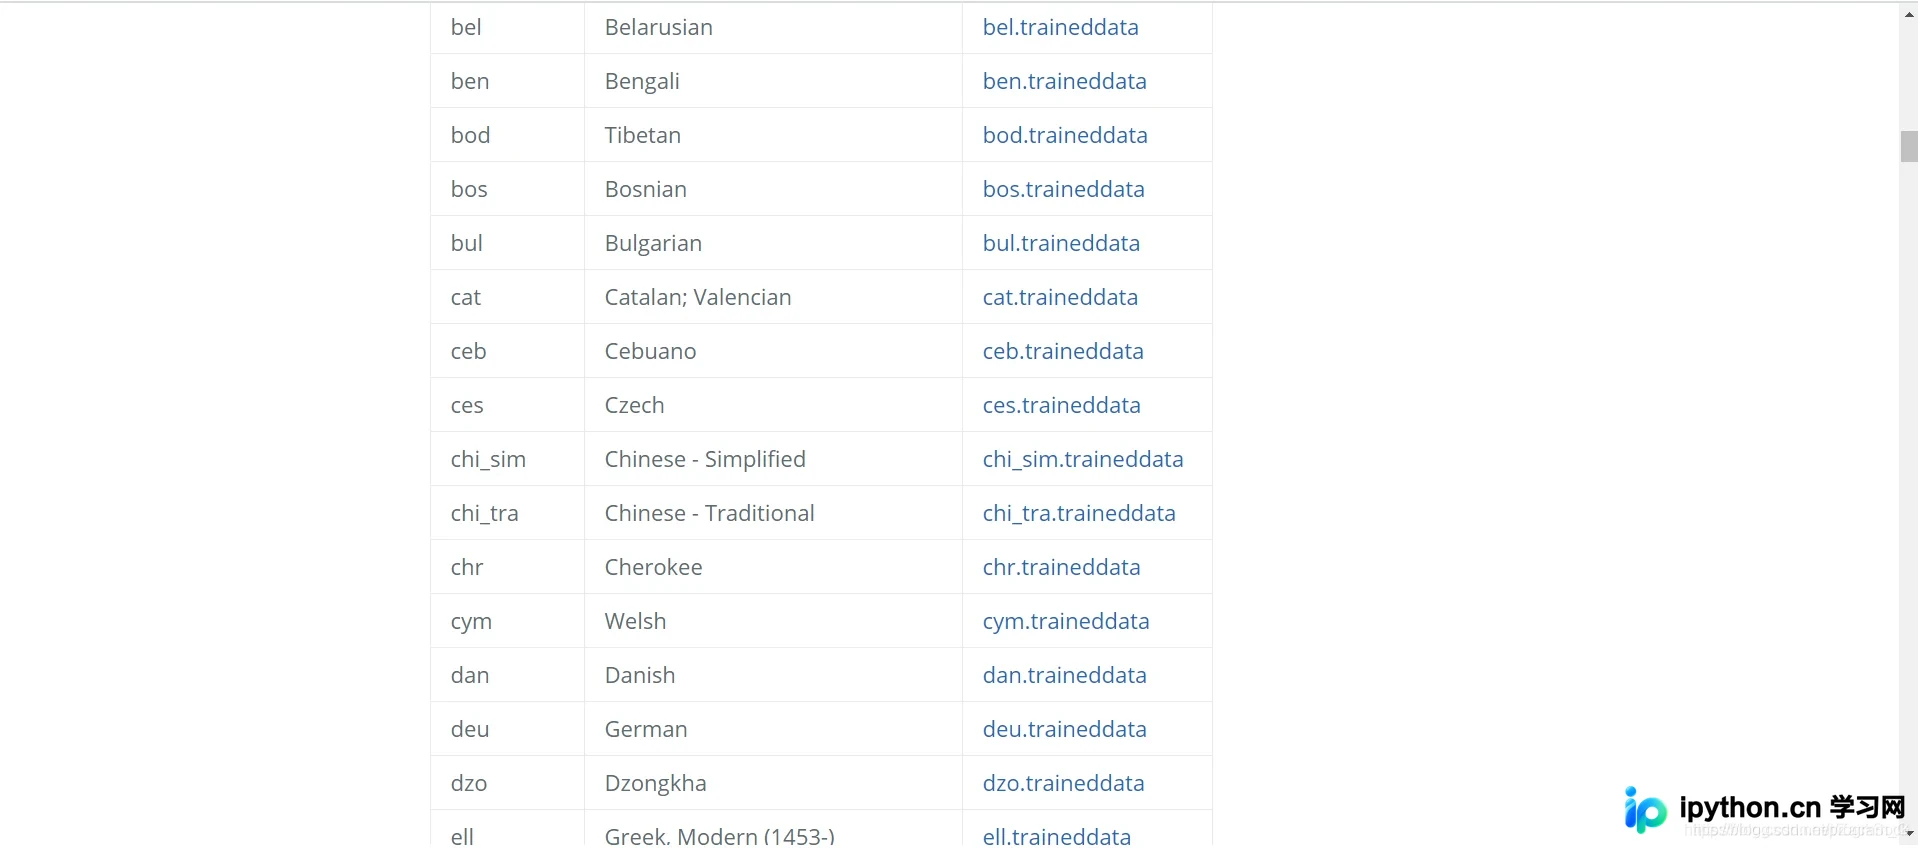
Tesseract默认仅支持英文识别。若需识别中文或其他语言,必须下载并配置相应的语言数据文件(Language Data)。访问Tesseract的GitHub仓库下载页面,获取所需的语言包。针对中文环境,通常需下载 Chinese-Simplified(简体中文)或 Chinese-Traditional(繁体中文)包。下载完成后,将语言包文件放置于Tesseract安装目录下的 tessdata 文件夹内(例如 D:\CodeField\Tesseract-OCR\tessdata)。
3. 安装Python依赖库
在Python环境中,需安装两个核心模块:用于调用Tesseract引擎的 pytesseract 以及用于处理图像文件的 Pillow(即PIL)。可通过以下命令进行安装:
pip install pytesseract
pip install pillow
图片文字识别实现
完成环境配置后,即可通过Python代码调用OCR功能。识别过程主要依赖 pytesseract.image_to_string() 方法,该方法接收图像对象或文件路径,并返回识别出的文本字符串。
英文识别
若图片仅包含英文字符,无需额外配置语言参数,直接识别即可。以下代码演示了如何读取图片并输出识别结果:
import pytesseract
from PIL import Image
# 读取图片
im = Image.open('sentence.jpg')
# 识别文字
string = pytesseract.image_to_string(im)
print(string)
中文识别配置
当图片包含中文时,必须在调用 image_to_string() 时显式指定语言参数 lang='chi_sim'(代表简体中文)。需要注意的是,该参数生效的前提是前文所述的 tessdata 目录中已存在对应的语言包文件。配置语言后,引擎同样可以识别图片中的英文字符。
import pytesseract
from PIL import Image
# 读取图片
im = Image.open('sentence.png')
# 识别文字,并指定语言
string = pytesseract.image_to_string(im, lang='chi_sim')
print(string)
批量图片识别处理
对于大量图片的识别需求,手动逐个处理效率较低。可通过编写脚本批量获取图片路径,生成包含路径列表的文本文件,再交由Tesseract进行批量处理。
1. 生成路径列表文件
首先,遍历指定目录下的所有图片文件,将它们的完整路径写入一个 .txt 文件中。每行记录一个图片路径:
import os
import pytesseract
# 文字图片的路径
path = 'text_img/'
# 获取图片路径列表
imgs = [path + i for i in os.listdir(path)]
# 打开文件
f = open('text.txt', 'w+', encoding='utf-8')
# 将各个图片的路径写入text.txt文件当中
for img in imgs:
    f.write(img + '\n')
# 关闭文件
f.close()
2. 执行批量识别
生成路径文件(如 text.txt)后,直接将该文件路径传入 image_to_string() 方法,并指定语言参数。Tesseract会自动读取文件中的每一行路径进行识别:
import pytesseract
# 识别文字
string = pytesseract.image_to_string('text.txt', lang='chi_sim')
print(string)
识别效果与局限性分析
虽然Tesseract在标准印刷体识别上表现优异,但其识别准确率受多种因素影响:
- 字体类型:宋体、黑体等笔画严谨的印刷体识别准确率最高;而手写体、行楷或风格飘逸的艺术字体,由于笔画连贯且结构多变,识别准确率会显著下降。
- 复杂字符:包含生僻字或结构复杂的汉字,识别效果仍有提升空间。
- 图像质量:图片的倾斜角度过大、分辨率过低或背景复杂,均会导致识别结果出现较大偏差。
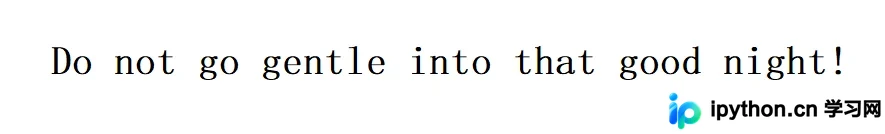
 以上就是利用Python与Tesseract实现图片文字识别的详细内容,更多关于Python OCR技术实战的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









