

Python正则表达式核心操作实战:匹配、提取、替换与分割

Python 正则表达式在进行文本处理时至关重要。本文详细拆解了 re 模块的核心操作,包括利用 search() 快速定位、findall() 批量提取、sub() 智能替换与 split() 灵活切割。结合动态回调函数与预编译优化策略,帮助开发者编写高可读性且高性能的数据清洗代码。
Python 正则表达式核心功能详解
在 Python 中进行文本处理时,re 模块提供了强大的正则表达式支持。通过定义特定的匹配规则,开发者能够高效地完成字符串的验证、关键词提取、内容替换及格式化分割等操作。本文将详细拆解 re 模块中常用的匹配、查找、替换与分割方法,并结合实际案例演示如何编写高效且准确的正则表达式。
第一步:掌握核心函数的差异与应用场景
选择正确的函数是高效处理字符串的前提。re 模块中的几个主要函数虽然都能实现匹配,但行为机制有所不同:
- re.match():仅从字符串的起始位置开始匹配。如果开头不符合正则表达式,立即返回
None。 - re.search():扫描整个字符串,返回第一个成功匹配的对象。常用于快速判断是否存在目标特征。
- re.findall():遍历整个字符串,将所有符合条件的匹配项收集并返回为列表。
第1步:使用 search() 定位首个匹配项
re.search() 是最常用的单条文本验证方式。它的典型返回值是一个匹配对象,调用其 .group() 属性可获取实际匹配到的文本内容。
import re
str1 = 'imooc video=1000'
# \d+ 代表匹配一位或多位连续数字
info = re.search(r'\d+', str1)
print(info.group()) # 输出: '1000'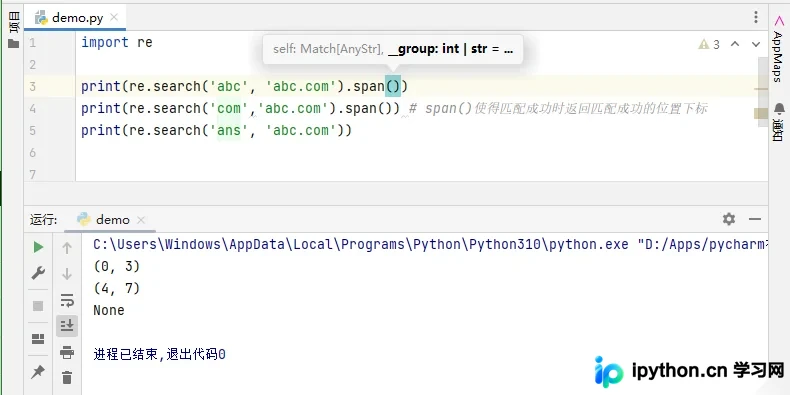
第2步:使用 match() 校验文本起始状态
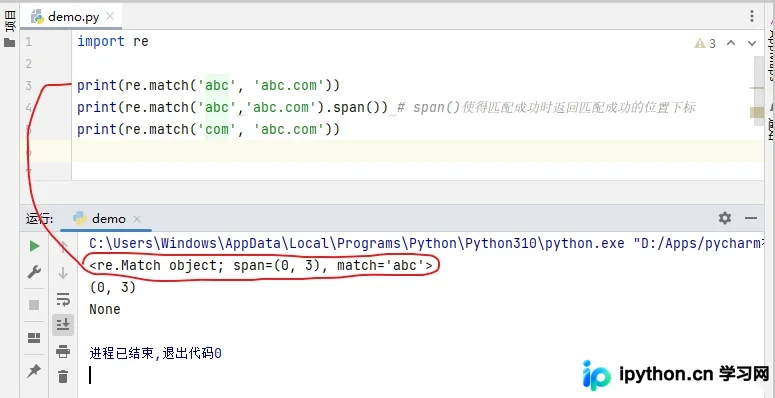
当业务逻辑严格要求匹配字符必须出现在段落头部时,应选用 re.match()。若首部未命中,它将直接终止而非继续向后扫描。
第3步:使用 findall() 批量提取目标信息
当我们需要从长文本中抓取所有符合条件的项目(例如提取一段混合了多种编程语言分数的日志中的分数值),re.findall() 能直接生成列表供后续计算。
str_data = 'java=1000,python=9090'
result_list = re.findall(r'\d+', str_data)
# 将提取出的数字转为整数并求和
total_score = sum([int(x) for x in result_list])
print(total_score) # 输出: 10090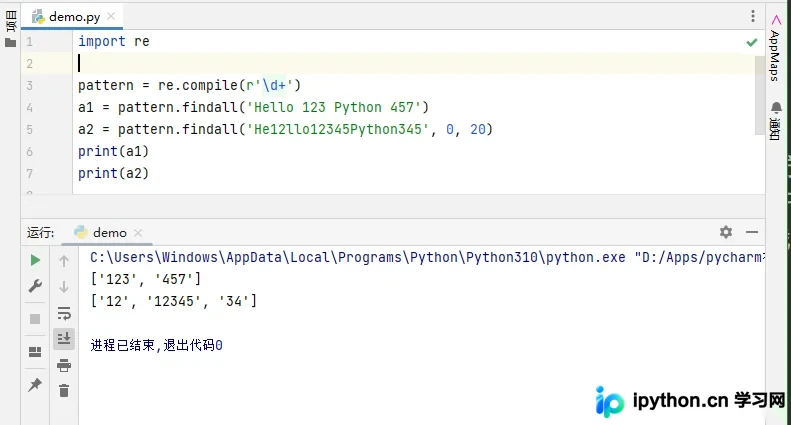
第二步:实施精确的内容替换与拆分
除了查找,正则表达式在处理数据清洗时的核心价值在于修改结构和重塑格式。主要涉及两个高频动作:re.sub() 负责内容重写,re.split() 负责打碎重组。
第4步:应用 sub() 实现条件替换
re.sub(pattern, repl, string) 能够精准定位目标子串并进行替代。不仅支持常量字符串替换,还可以接收一个自定义函数,实现基于原始值的动态变换。
# 简单替换示例
text = "python video =1000"
updated_text = re.sub(r'\d+', 'new_value', text)

# 高级替换示例:让匹配的数字自动 +1
def add_one(match):
    val = int(match.group())
    return str(val + 1)

dynamic_replace = re.sub(r'\d+', add_one, text)
print(dynamic_replace) # 输出: python video =1001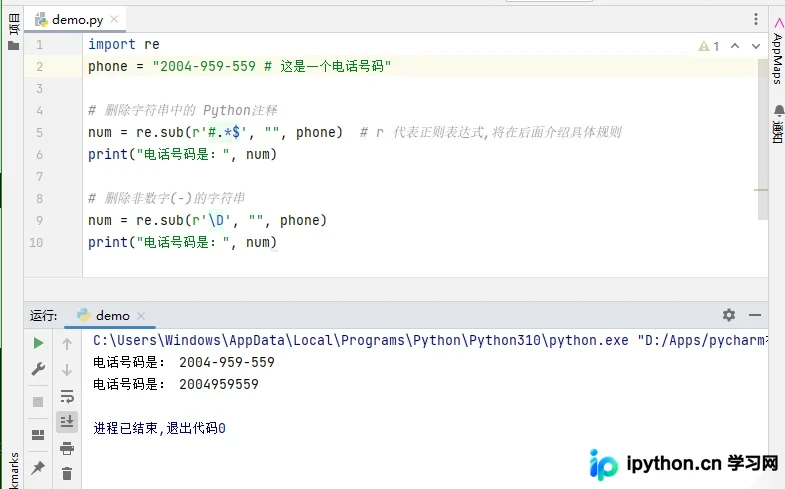
第5步:运用 split() 按规则切断字符串
有时我们不需要知道匹配的具体内容,而是想根据某个标志位将整体拆散。正则允许我们在分隔符处进行切割,返回被剥离后的片段集合。
raw_string = 'imooc:java c++ python c#'
# 同时使用冒号和空格作为切割界限
parts = re.split(r':| ', raw_string)
print(parts) # 输出: ['imooc', 'java', 'c++', 'python', 'c#']
第三步:优化性能与补充基础常识
在处理大量文本或循环多次使用同一套规则时,预编译是提升运行效率的关键手段。同时,了解 Python 原生字符串的基础特性有助于更顺畅地切入正则逻辑。
第6步:引入 compile() 避免重复消耗
对于反复被使用的固定正则表达式字符串,可以使用 re.compile() 将其转化为一个 Pattern 对象。此后对该对象的调用将跳过每一次解析过程,显著缩短系统响应时间。
pattern_obj = re.compile(r'\d+')
matches = pattern_obj.findall('item1 item2')
print(matches)
第7步:了解字符串构建基础
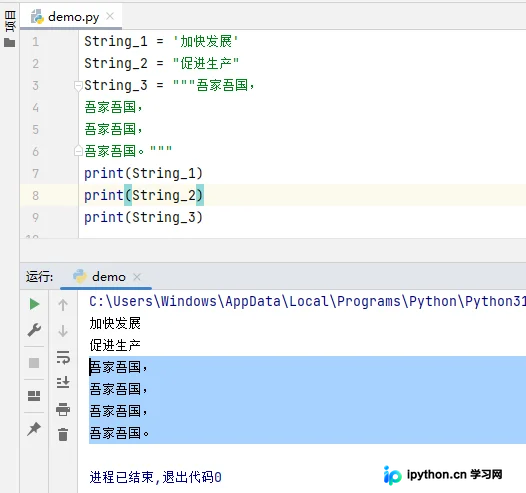
在使用正则之前,需清楚字符串本身是由单引号、双引号甚至三引号定义的。三引号常被用来保存包含换行符的多行模板文本。
正确运用上述正则技巧,可以大幅减少繁杂的条件分支判定代码量,使程序逻辑更加简洁清晰。以上就是Python正则表达式核心操作实战的详细内容,更多关于字符串处理优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









