

利用numpy和pandas处理csv文件中的时间方法
本文介绍在机器学习与深度学习中,如何利用Python的pandas和numpy库处理CSV文件中的时间变量。通过示例代码展示将时间列合并、解析为标准格式,并转换为float或int类型数值的过程,以便进行后续的分析与建模。
2026-10-13
40

本文介绍在机器学习与深度学习中,如何利用Python的pandas和numpy库处理CSV文件中的时间变量。通过示例代码展示将时间列合并、解析为标准格式,并转换为float或int类型数值的过程,以便进行后续的分析与建模。
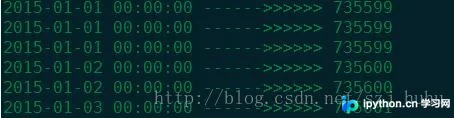
本文详细介绍Python中CSV文件与List列表相互转换的实现方法。通过示例代码展示如何读取CSV文件内容并分割为二维列表,以及如何将列表数据按指定格式写入CSV文件。代码包含异常处理与文件关闭机制,适用于基础数据处理场景。
本文介绍如何使用Python将文件中由制表符分隔的数字行读取并转换为List。通过strip()去除首尾空格,利用split()按制表符切片,再结合map或列表推导式将字符串转为整数,最终构建包含所有行数据的嵌套List结构。
本文介绍在Python中处理如4GB大小的超大文本文件时,如何高效地逐行读取内容并写入目标文件。通过对比直接迭代文件对象与使用readlines()方法的差异,提供具体的代码实现,帮助开发者在避免内存溢出的同时完成文件数据的迁移与处理。
本文介绍在Python中按行读取文件内容时,如何有效去除每行末尾的换行符\n。通过file.readlines()遍历文件,并利用strip()方法清理空白字符,实现数据的整洁处理。
本文介绍如何在Sublime Text中通过安装sublimeREPL插件解决Python3文件编译时input()换行不执行的问题。通过配置快捷键F5,实现一键运行当前文件并支持交互式输入,提升开发效率。
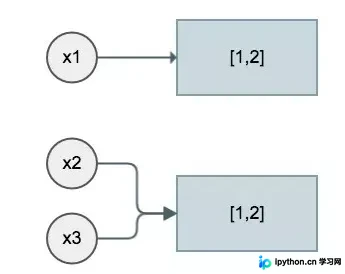
本文深入解析Python中的变量赋值与对象拷贝机制。通过对比is与==运算符,阐明变量仅是对对象的引用而非拷贝。重点讲解copy模块提供的浅拷贝与深拷贝差异:不可变对象拷贝结果一致,而组合对象中浅拷贝仅复制外层容器,深拷贝则递归复制内部元素。结合代码示例说明修改原对象对拷贝结果的影响,帮助开发者避免副作用。
本文介绍如何利用Python标准库collections模块中的ChainMap类,将多个字典或映射逻辑合并为单一结构。ChainMap不物理合并字典,而是维护映射列表,优先返回第一个映射中的键值。示例展示了键查找、修改原始字典对合并结果的影响以及作用域堆叠用法,适用于需要动态组合配置或上下文的场景。
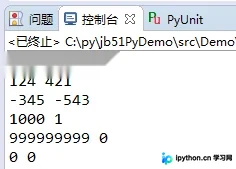
本文介绍Python中实现数字逆序输出的具体方法。代码处理正负数、前导零及溢出情况,通过字符串转换与列表操作完成逻辑。提供完整函数定义及测试用例,帮助开发者理解字符串切片与条件判断在数值处理中的应用。
本文深入解析Python中Numpy多维数组的切片操作,重点讲解冒号与省略号(...)的具体用法。通过二维数组示例,阐明如何按维度独立切片,并详细解释None(newaxis)在改变数组形状中的作用机制。同时对比a[:, :, None]与a[..., None]的输出一致性,帮助读者理解省略号简化多维索引的逻辑,适用于需要处理复杂数组结构的开发场景。
本文介绍在Python IDLE环境中输入多行代码(如if-else结构)的具体操作方法。重点说明如何利用Tab键控制代码缩进,并通过连续两次回车键确认输入结束。该技巧适用于Python命令行模式下的交互式编程,帮助开发者更高效地编写和测试逻辑块代码。
本文详细解析Python中正则表达式的贪婪与非贪婪匹配机制,通过re.findall示例对比\d+与\d+?的差异。同时深入讲解多行匹配场景,说明如何运用re.S使点号匹配换行符,以及利用re.M让^和$符号作用于每一行,帮助开发者精准控制正则匹配行为。