

Python实现基于CSV的数据驱动接口自动化测试
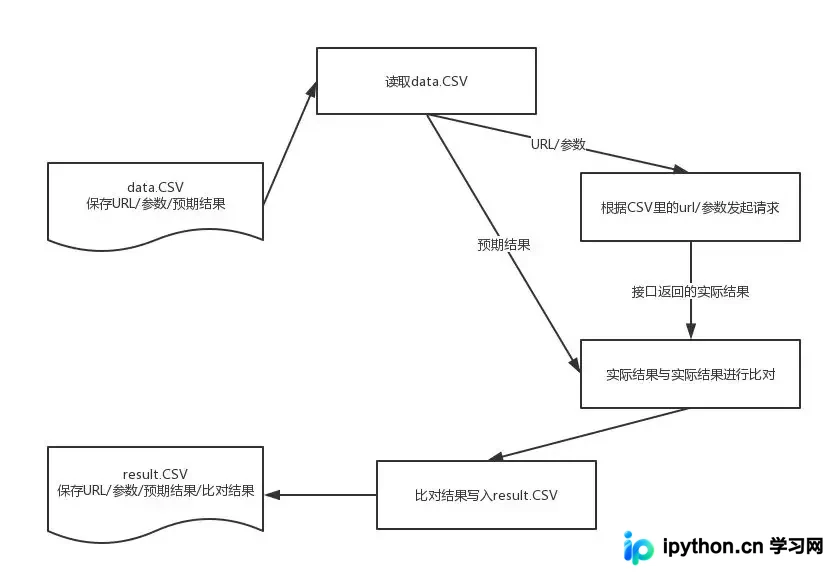
本文介绍如何使用Python结合csv和requests库,构建基于CSV文件的数据驱动接口自动化测试方案。通过预定义测试用例数据,自动发起GET或POST请求并比对响应结果,实现高效、可扩展的接口测试流程,适用于需要批量验证API参数的场景。
2026-10-13
25

本文介绍如何使用Python结合csv和requests库,构建基于CSV文件的数据驱动接口自动化测试方案。通过预定义测试用例数据,自动发起GET或POST请求并比对响应结果,实现高效、可扩展的接口测试流程,适用于需要批量验证API参数的场景。
本文介绍如何解决Pandas中使用to_json()导出中文数据时出现的\uXXXXXX乱码问题。通过设置force_ascii=False参数,可直接在to_json中保留中文。此外,文章还演示了如何将DataFrame转换为Python原生列表,利用json.dumps的ensure_ascii=False参数生成格式化的JSON数组,并提供了完整的封装类源码供参考。

本文详解Python3中urllib与http模块的使用方法。urllib包负责URL处理,包含request、error和parse等子模块,支持通过urlopen打开网页及urlretrieve下载文件。http包提供底层HTTP协议封装,如HTTPConnection用于发送GET/POST请求并获取响应状态码及内容。文章结合代码实例,帮助开发者掌握网络编程基础。
本文介绍在Python中执行Shell命令的两种常见方法:一是通过subprocess模块捕获标准输出和错误流,将执行结果保存为字符串;二是将命令的标准输出和错误重定向至指定日志文件。文中提供了完整的代码示例,展示了如何处理进程状态及资源释放,适用于需要自动化执行系统命令并持久化结果的场景。
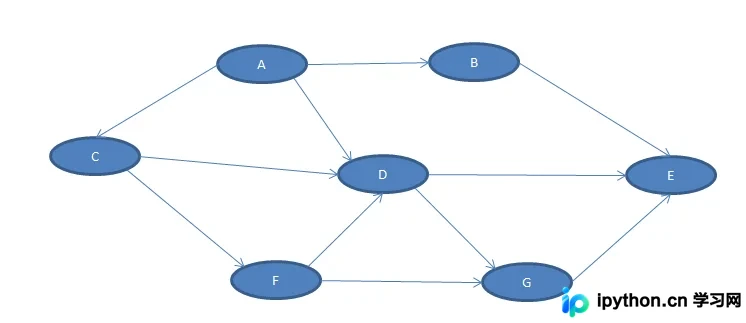
本文通过Python代码实例,详细演示了如何在图数据结构中查找起点到终点的所有路径。利用深度优先搜索(DFS)递归算法遍历节点,避免回路,并输出按路径长度排序的结果。代码包含图的定义、递归搜索逻辑及主程序调用,适合学习Python数据结构与算法的开发者参考。
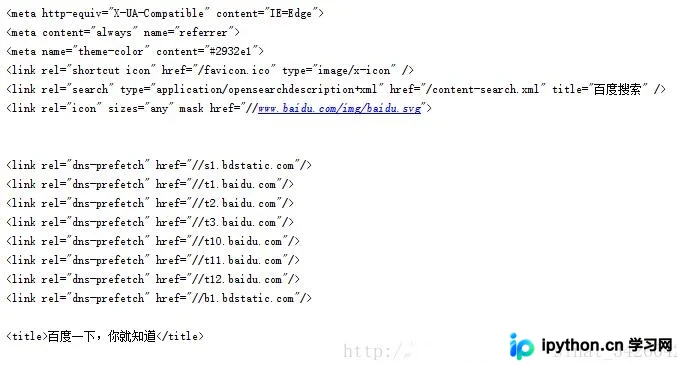
本文分析Python爬虫中中文显示乱码的根本原因,即默认Unicode解析与系统编码格式不匹配。通过示例代码展示如何利用urllib获取网页,将UTF-8内容解码后重新编码为系统默认格式,从而完美解决中文输出乱码问题,适用于百度等常见网页抓取场景。
本文介绍如何使用Python的yagmail库简化邮件发送流程。通过对比传统smtplib的复杂配置,展示yagmail仅需三行代码即可实现邮件发送。重点解析SMTP初始化参数及send方法中的收件人、主题、正文和附件设置,并详细说明邮箱授权码的获取方式,帮助开发者高效完成自动化邮件任务。
本文介绍在 Python 项目中处理 URL 重定向以获取真实地址的方法。通过 requests 库发送请求并提取最终 URL,同时补充了包含最大重试次数限制和状态码检查的完善代码,确保在网络异常时能自动重试,提高获取真实链接的稳定性。
本文介绍Python爬虫在请求包含中文或特殊符号的URL时常见报错问题,通过urllib.parse.quote函数进行安全编码处理,保留可打印字符,解决请求失败问题。
本文介绍在Python爬虫开发中如何处理包含中文的URL。直接使用未处理的中文会导致请求失败,需利用urllib.parse模块中的quote函数对中文部分进行单独编码,避免影响其他特殊字符,确保URL格式正确。

本文深入解析Python中的单继承与多继承机制。通过具体代码示例,展示如何定义派生类、调用父类构造方法及覆写方法。重点说明在多重继承中,Python依据基类在圆括号中的从左至右顺序进行方法查找(MRO),当子类未指定方法时,系统将按此顺序在父类中搜索匹配的方法实现。
本文详解Python3处理JSON及TXT文件时中文乱码的成因与解决。核心在于打开文件时指定encoding='utf-8',并在json.dump中设置ensure_ascii=False,确保中文正常显示而非转为Unicode编码或乱码。