Python中字符串与URL编码互转的实现方法
本文介绍Python中字符串与URL编码相互转换的具体实现。通过urllib模块的quote函数可将中文等字符编码为URL安全格式,利用unquote函数则可将编码还原为原始字符串。该功能常用于爬虫生成带搜索关键词的网址,确保参数传递正确。
2026-10-13
28

本文介绍Python中字符串与URL编码相互转换的具体实现。通过urllib模块的quote函数可将中文等字符编码为URL安全格式,利用unquote函数则可将编码还原为原始字符串。该功能常用于爬虫生成带搜索关键词的网址,确保参数传递正确。
本文详细讲解如何在Python环境中配置Tesseract-OCR及pytesseract库以实现图像文字识别。内容涵盖Pillow、pytesser3、autopy3及Tesseract的安装步骤,重点解决Tesseract路径未加入环境变量导致的报错问题,并提供完整的Python识别代码示例及效果展示。

在Python3环境下,cv2.imwrite无法直接处理包含中文字符的文件路径。本文介绍使用cv2.imencode结合tofile方法作为替代方案,通过视频帧提取示例演示如何正确保存带有中文路径的图片文件,解决编码兼容性问题。
本文介绍Python3中网络请求路径包含中文时引发的UnicodeEncodeError错误。通过示例展示如何利用urllib.parse.quote对中文参数进行编码,从而解决浏览器自动处理而代码需手动编码的问题,确保请求正常发送。
本文介绍在Python环境中使用pytesseract库识别图片文字的方法。详细列出安装Python 2.7或3.4、Pillow、tesseract-ocr及pytesseract的步骤,涵盖Ubuntu环境下的具体命令。通过示例代码展示识别过程,并提示可能出现乱码的情况,供开发者参考。
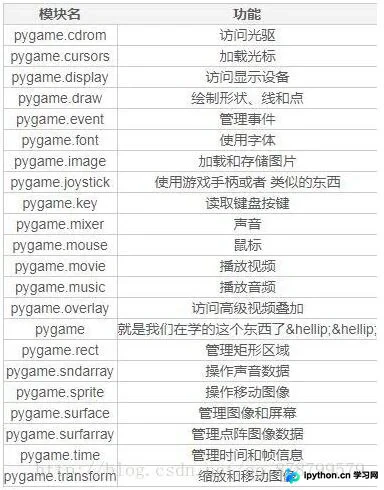
本文介绍如何利用Python的Pygame模块实现文字到图片的转换。通过导入pygame库,初始化环境后设置指定字体、字号及颜色,渲染文字并保存为图片文件。该方法简单实用,适用于需要批量生成文字图片的场景。
本文详解如何在Python中实现统计字符串中出现频率最高的n个单词的函数。通过split分割字符串,利用defaultdict或Counter统计词频,并演示如何按频率降序、字母升序进行双重排序,最终返回指定数量的单词及其出现次数。
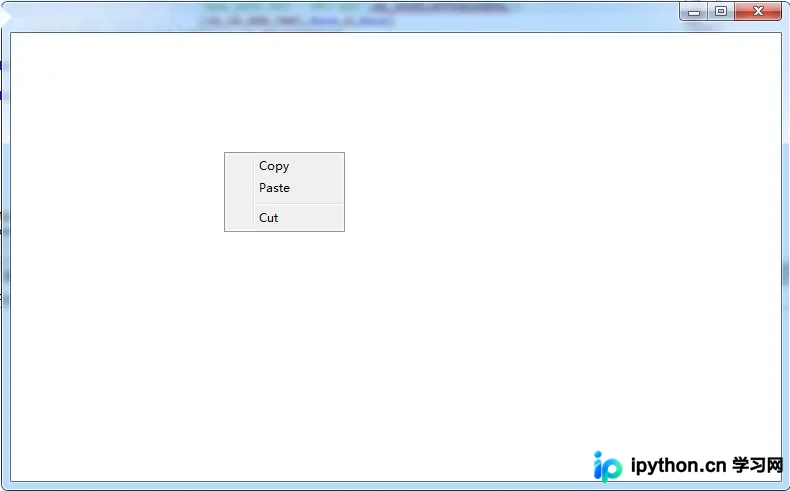
本文通过Python的win32ui模块演示如何创建基于MFC的图形界面窗口及右键弹出菜单。代码展示了窗口创建、消息钩子绑定及菜单项添加的具体实现,并提供了模块安装方法。
本文介绍使用Python将大文件按固定行数分割为多个小文件的实现方法。通过循环读取源文件内容,每处理指定行数后关闭当前文件并创建新文件写入,从而实现批量生成小文件的功能。
本文介绍利用Python的PIL库和NumPy库实现多张图片纵向拼接的方法。通过读取图片并统一宽度,利用NumPy数组追加操作合并图像数据,最终保存为合并后的图片文件。
本文介绍了在Python中使用numpy库删除数组指定行或列的方法。通过np.delete函数,可以灵活地移除数组中的特定行或列,适用于数据清洗和预处理场景。
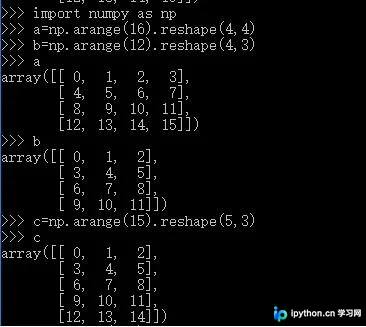
本文介绍NumPy中数组拼接的两种常用方式。第一种通过np.vstack()实现垂直拼接,np.hstack()实现水平拼接;第二种利用np.c_[]按列合并,np.r_[]按行合并。掌握这些方法可高效处理多特征样本数据的合并分析。