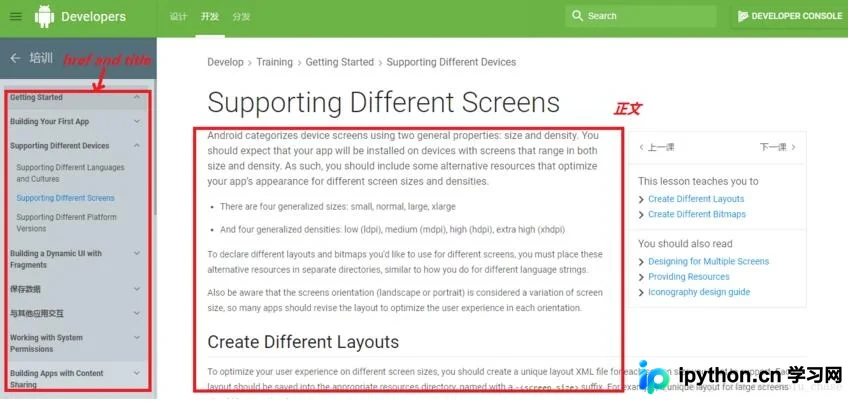
Python爬虫实战:抓取网页并转换为PDF电子书
本文介绍如何利用Python编写爬虫程序,从指定网页提取标题、正文及导航链接,并通过BeautifulSoup解析HTML。结合Requests库获取内容,使用wkhtmltopdf工具将生成的HTML文件转换为PDF格式,实现离线阅读与记忆。
2026-10-13
33

本文介绍如何利用Python编写爬虫程序,从指定网页提取标题、正文及导航链接,并通过BeautifulSoup解析HTML。结合Requests库获取内容,使用wkhtmltopdf工具将生成的HTML文件转换为PDF格式,实现离线阅读与记忆。
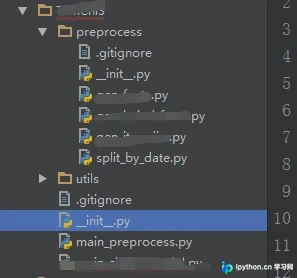
本文总结了在Python中调用不同路径下py文件函数的多种实现方法。针对Python无法自动识别其他文件夹路径的问题,详细解析了五种常见解决方案,包括直接修改sys.path、利用__init__.py构建包、相对导入以及针对特定环境(如Linux)的配置技巧。文章提供了具体的代码示例和目录结构说明,帮助开发者解决跨文件函数调用的路径依赖难题。
本文介绍在 Pandas DataFrame 中,如何根据特定条件筛选行并获取其在原数据框中的位置索引。通过布尔索引结合 index.tolist() 方法,可精准定位符合条件的行索引列表,适用于需要定位数据位置的场景。
本文介绍Python中偏函数的概念及使用。通过functools.partial,可将多参数函数简化为少参数新函数,固定部分默认参数。示例包括使用int()进行进制转换及sorted()忽略大小写排序,展示偏函数在简化调用、降低复杂度方面的实际应用。
本文详解如何利用Python的python-pptx库创建PPT文件。内容涵盖环境安装、基础文字添加、图表插入以及使用预设模板生成报告的方法。通过具体代码示例,展示如何自动化生成包含数据表格和可视化图表的周期性汇报文档,适用于业务数据汇总及项目可视化场景。
本文介绍如何使用Python的PIL库实现按固定长宽比缩放图片。通过计算缩放比例,将图片缩放后居中粘贴至指定尺寸的黑色背景画布中,实现空白区域自动填充黑色。代码包含完整的类封装与调用示例,支持自定义图片路径、目标宽高及背景颜色参数化。
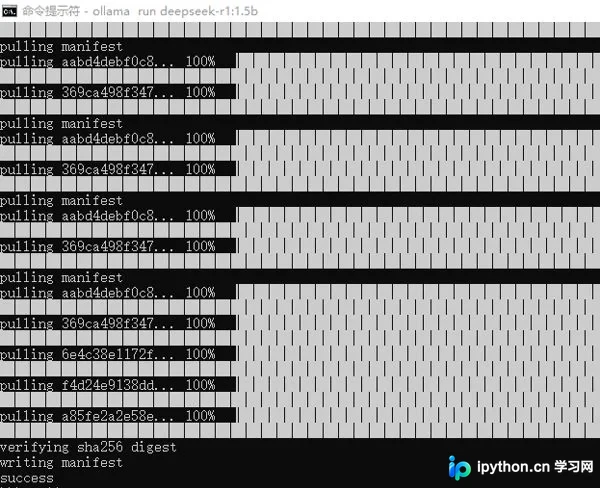
本文详细介绍如何在Windows环境下使用Ollama本地部署DeepSeek大语言模型,并通过Python代码进行调用。内容涵盖Ollama及可视化工具Hollama的安装配置、模型下载运行命令,以及利用Python ollama库实现文本交互的完整代码示例,适合AI初学者及开发者参考。
本文介绍使用Python进行批量图片格式转换的方法,适用于深度学习数据预处理场景。通过调用PIL库,脚本支持将JPG等格式批量转换为PNG或其他格式,并处理文件路径与异常。代码示例展示了如何遍历目录、转换单张图像并输出进度,帮助开发者高效完成数据集格式统一工作。
本文详细介绍 Python 中 Pandas 库 DataFrame 对象的基础操作方法。内容涵盖如何基于列表、数组和字典创建 DataFrame,以及如何执行索引访问、行列求和、元素变换等常用计算。此外,文章还演示了通过 append 方法扩充行与列的具体步骤,并深入解析了使用 join 函数进行内连接、外连接等多种数据合并策略,帮助开发者高效掌握数据处理核心技能。
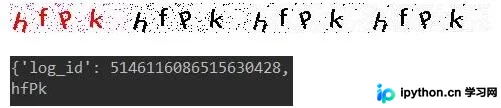
本文介绍利用Python进行验证码识别的完整流程。首先通过PIL库对图像进行灰度转换与二值化处理,去除干扰线及孤立噪点。随后结合百度AI开放平台的通用文字识别接口,获取识别结果并清洗空格与特殊字符,实现自动化验证码解析。
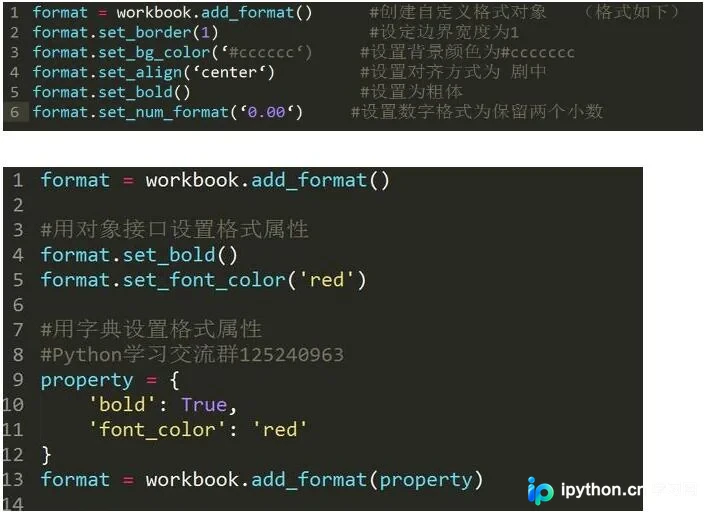
本文介绍如何使用Python的xlsxwriter库处理Excel单元格格式。详细解析了颜色、数字格式、字体、边框、对齐方式及图案等属性,并说明如何将数据转换为相应格式写入xlsx文件,帮助开发者高效实现Excel表格的样式定制。
本文介绍利用Python的itchat库实现微信网页版消息监听的方法。通过注册TEXT等消息类型回调,可实时获取聊天内容。针对微信5.3.1新增的撤回功能,文章探讨了如何通过监听消息变化来捕捉“对方撤回了一条消息”的提示,并提供了相关代码框架及注意事项。