

Python爬虫实现登录并导出CSV数据详解
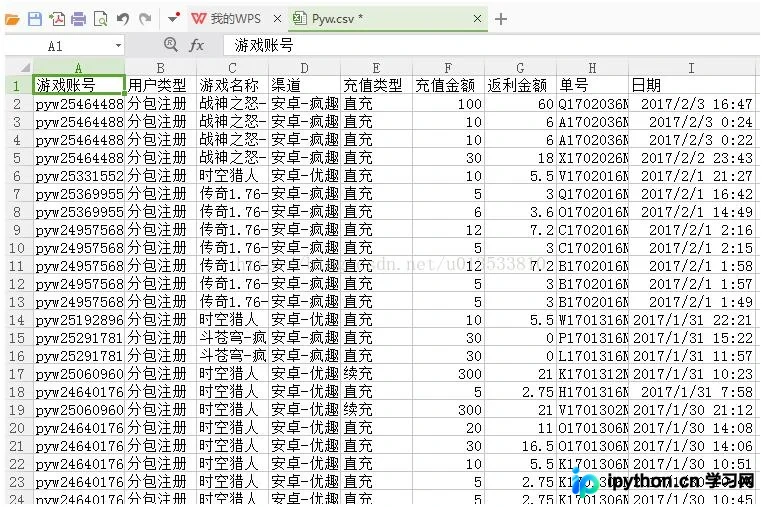
本文介绍使用Python编写简单爬虫,通过模拟登录获取HTML页面,利用正则表达式解析目标数据行,并将结果逐行写入CSV文件的全过程。包含核心逻辑说明、完整代码示例及导出结果展示,适用于需要批量抓取网页数据并保存为表格格式的场景。
2026-10-13
30

本文介绍使用Python编写简单爬虫,通过模拟登录获取HTML页面,利用正则表达式解析目标数据行,并将结果逐行写入CSV文件的全过程。包含核心逻辑说明、完整代码示例及导出结果展示,适用于需要批量抓取网页数据并保存为表格格式的场景。
本文详细介绍Python中实现从右向左字符串替换的两种方法。针对Python缺乏内置rreplace函数的情况,提供了基于循环查找的11行代码实现以及利用rsplit和join的一行核心代码实现。文章包含完整的参数说明、返回值定义及多个测试用例对比,帮助开发者灵活处理字符串替换需求。
本文介绍使用Python Selenium与xlwings库实现有赞订单自动发货的方法。通过读取Excel中的客户姓名与物流单号,Selenium自动登录有赞后台,搜索订单并填入单号完成发货操作,提升电商运营效率。
本文详细讲解Python通过pyodbc库连接数据库的方法,涵盖驱动安装、64位ODBC配置及常见报错解决。通过完整代码示例演示连接、查询、参数化SQL、插入修改及提交事务等核心操作,帮助开发者高效实现数据库交互。
本文深入解析Django项目中favicon.ico的处理方案。默认情况下,浏览器请求/favicon.ico会引发404错误。文章对比了重定向、模板指定地址两种常见方法,并重点推荐通过配置URL路由直接调用静态文件服务的最优雅方案,从根本上解决请求问题且无需额外HTTP重定向,提升网站加载效率与用户体验。
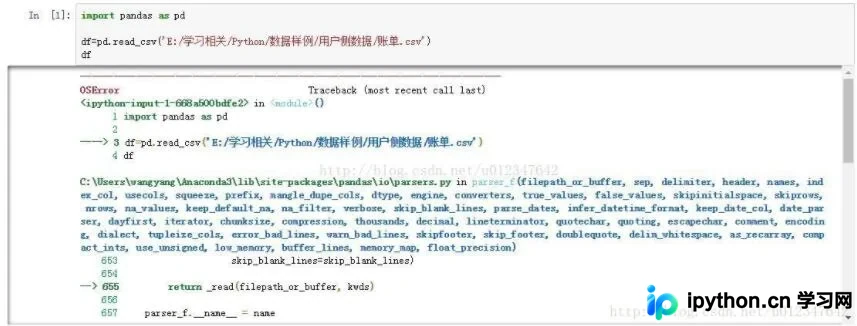
在使用pandas读取文件名含中文的csv文件时,常因默认C引擎兼容性问题触发OSError。通过将read_csv函数的engine参数显式设置为'python',可解决中文标题读取错误,尽管速度略慢但功能更完备。
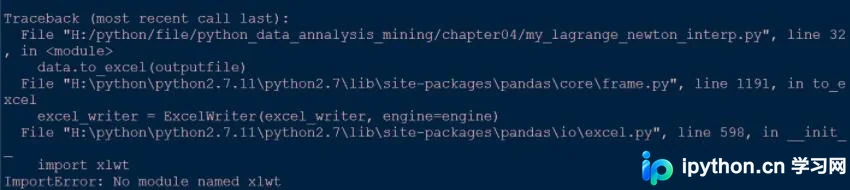
本文针对Python使用pandas库将DataFrame写入Excel时遇到的两个常见错误进行解析。首先介绍如何通过pip安装缺失的xlwt依赖库;其次重点解决因Windows路径中单斜杠导致的to_excel报错,指出需将路径中的单斜杠替换为双斜杠以正确处理转义字符,确保文件成功保存。
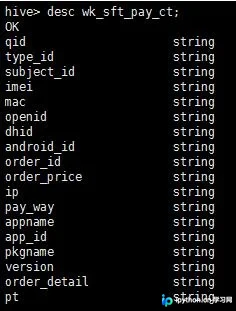
本文详细介绍如何利用Python将本地TXT文件中的数据清洗并导入Hive表。核心步骤包括:分析源数据与目标Hive表结构的差异,通过字段筛选与重排序实现结构对齐,处理JSON字段及空值,最后创建对应Hive表并使用LOAD DATA命令完成数据加载。
本文介绍如何使用pandas的read_table函数读取CSV文件。通过对比指定sep=','与不指定分隔符两种情况,分析read_table在默认行为下的数据解析差异。结果显示,明确指定分隔符可正确生成DataFrame结构,而省略sep参数可能导致列名合并及数据解析异常,建议在实际操作中显式声明分隔符以确保数据准确性。
在使用Pandas的read_csv函数时,若文件路径或文件名包含中文字符,直接导入会触发报错。本文介绍通过Python内置open函数先打开文件对象,再将其传递给read_csv的方法,从而成功读取含中文路径的数据文件。
本文详细解析了朴素贝叶斯分类器的数学原理及Python实现方法。从贝叶斯定理出发,推导先验概率、后验概率与似然度的关系,并介绍算法流程。通过具体示例演示如何计算条件概率,最后提供完整的Python类封装代码及Matlab实现对比,帮助开发者掌握该算法的核心逻辑与应用。
本文介绍如何使用Python的Numpy库高效读取CSV文件,并将数据转换为数组或列表格式。同时详细讲解了利用np.delete函数对Numpy数组进行行和列删除的具体语法与参数设置,包括axis参数的作用,帮助开发者快速掌握基础数据处理技巧。