

Python解决中文字符串比较为False的问题:UTF-8与UTF-8-SIG编码差异
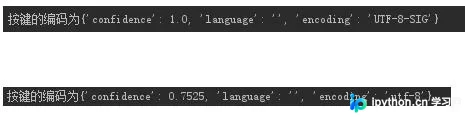
本文分析Python中两个看似相等的中文字符串比较返回False的原因。通过chardet库检测发现,差异源于文件编码格式不同:一个为UTF-8-SIG(带BOM),另一个为UTF-8。解决该方法是将文件保存为UTF-8无BOM格式,从而确保字符串编码一致,使比较结果正确返回True。
2026-10-13
21

本文分析Python中两个看似相等的中文字符串比较返回False的原因。通过chardet库检测发现,差异源于文件编码格式不同:一个为UTF-8-SIG(带BOM),另一个为UTF-8。解决该方法是将文件保存为UTF-8无BOM格式,从而确保字符串编码一致,使比较结果正确返回True。
本文介绍Python中csv模块的使用,重点解决写入CSV文件时自动产生多余空行的问题。通过指定newline=''参数,可有效避免空行,确保数据格式正确。
本文详细介绍如何使用Python的urllib2库实现网易邮箱的模拟登录。通过配置代理IP、处理CookieJar、构造POST请求及解析响应HTML,完成身份验证并获取登录后的页面内容。代码包含完整的请求头设置与URL跳转处理,适用于Python 2环境下的自动化登录场景。
本文介绍如何在Python的for循环中同时迭代字典的key和value。通过dict对象的items()方法可将字典转换为包含元组的列表进行遍历,而iteritems()则直接在迭代过程中生成元组,避免额外内存开销,适合处理大型字典。
本文介绍在Python中如何在保持字典Value不变的前提下替换Key值。通过示例展示将旧Key映射到新Key的过程,核心利用字典的pop()方法结合赋值操作实现。该方法简洁高效,适用于需要调整字典键名但保留原有数据内容的场景。
本文介绍如何在Python中实现字典按Key值大小进行倒序取值。通过获取字典所有Key并排序后反转,遍历反转后的Key列表即可按倒序获取对应值。
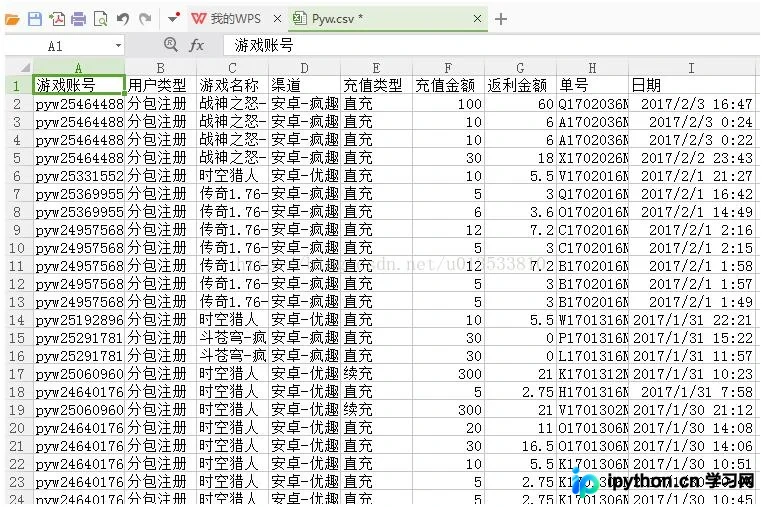
本文介绍使用Python编写简单爬虫,通过模拟登录获取HTML页面,利用正则表达式解析目标数据行,并将结果逐行写入CSV文件的全过程。包含核心逻辑说明、完整代码示例及导出结果展示,适用于需要批量抓取网页数据并保存为表格格式的场景。
本文详细介绍Python中实现从右向左字符串替换的两种方法。针对Python缺乏内置rreplace函数的情况,提供了基于循环查找的11行代码实现以及利用rsplit和join的一行核心代码实现。文章包含完整的参数说明、返回值定义及多个测试用例对比,帮助开发者灵活处理字符串替换需求。
本文介绍使用Python Selenium与xlwings库实现有赞订单自动发货的方法。通过读取Excel中的客户姓名与物流单号,Selenium自动登录有赞后台,搜索订单并填入单号完成发货操作,提升电商运营效率。
本文详细讲解Python通过pyodbc库连接数据库的方法,涵盖驱动安装、64位ODBC配置及常见报错解决。通过完整代码示例演示连接、查询、参数化SQL、插入修改及提交事务等核心操作,帮助开发者高效实现数据库交互。
本文深入解析Django项目中favicon.ico的处理方案。默认情况下,浏览器请求/favicon.ico会引发404错误。文章对比了重定向、模板指定地址两种常见方法,并重点推荐通过配置URL路由直接调用静态文件服务的最优雅方案,从根本上解决请求问题且无需额外HTTP重定向,提升网站加载效率与用户体验。
在使用pandas读取文件名含中文的csv文件时,常因默认C引擎兼容性问题触发OSError。通过将read_csv函数的engine参数显式设置为'python',可解决中文标题读取错误,尽管速度略慢但功能更完备。