

Python机器学习scikit-learn决策树算法详解:分类、回归与多输出实现
本文详解Python中scikit-learn库的决策树实现。涵盖决策树原理、分类器DecisionTreeClassifier与回归器DecisionTreeRegressor的使用,包括模型训练、预测及可视化导出。重点解析多输出问题的处理策略,通过虹膜数据集等实例展示代码应用,帮助开发者掌握从基础分类到复杂多输出回归的完整技术路径。
2026-10-13
17

本文详解Python中scikit-learn库的决策树实现。涵盖决策树原理、分类器DecisionTreeClassifier与回归器DecisionTreeRegressor的使用,包括模型训练、预测及可视化导出。重点解析多输出问题的处理策略,通过虹膜数据集等实例展示代码应用,帮助开发者掌握从基础分类到复杂多输出回归的完整技术路径。
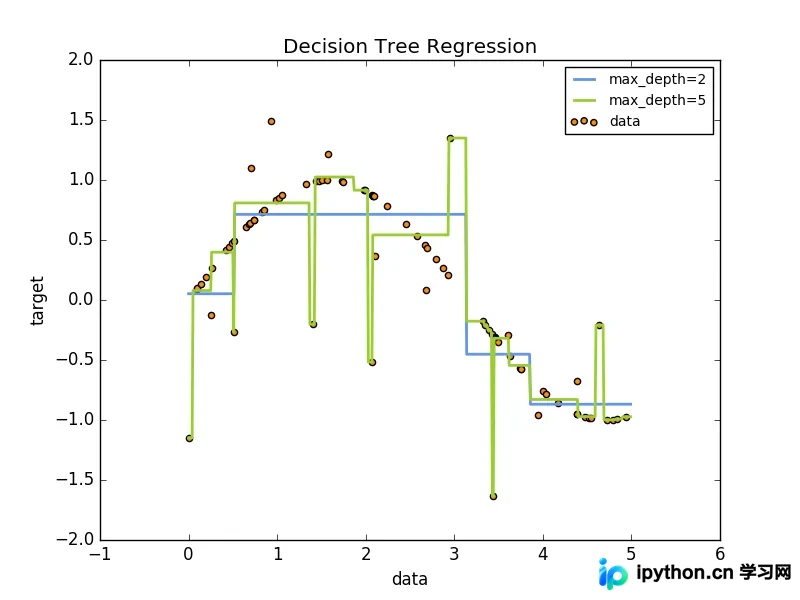
本文介绍了一个基于Python的12306火车票抢票系统。该系统利用urllib和cookiejar进行网页请求与状态保持,通过正则表达式解析城市代码文件,并定时查询余票信息。当检测到有票时,通过SMTP发送邮件通知用户。代码展示了完整的请求流程、城市数据解析及邮件发送逻辑,为开发类似自动化工具提供参考。
本文介绍在Python3环境下使用PyQt5库,如何在主窗口状态栏中嵌入并显示进度条。详细讲解两种布局方式:将进度条置于状态栏右端(使用addPermanentWidget)和左端(自定义QStatusBar对象并调整拉伸因子)。包含完整代码示例及界面效果说明,帮助开发者快速实现状态栏信息展示功能。
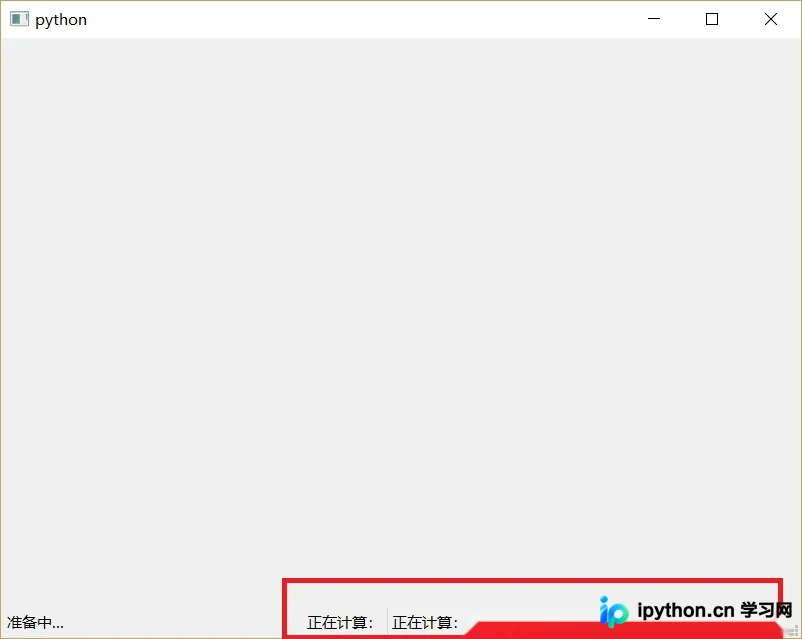
本文介绍如何利用Python的numpy库中的linspace函数生成等间隔数组。详细解析了start、stop、num、endpoint、retstep及dtype等关键参数的用法,并通过多个代码示例展示了不同参数组合下的输出结果,包括是否包含终点、是否返回步长以及数据类型转换的具体表现。
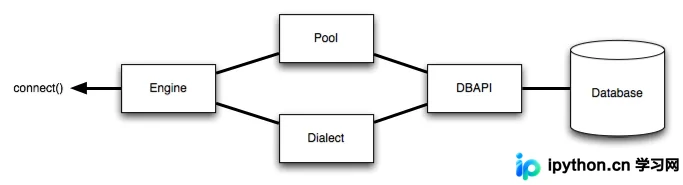
本文深入解析 SQLAlchemy 中 Engine 的核心作用,阐述其如何通过连接池(Pool)和方言(Dialect)驱动数据库交互。重点介绍 create_engine 的初始化流程、延迟连接机制,以及 echo、pool_size、pool_recycle 和 pool_pre_ping 等关键参数的配置方法,帮助开发者优化数据库连接效率与稳定性。
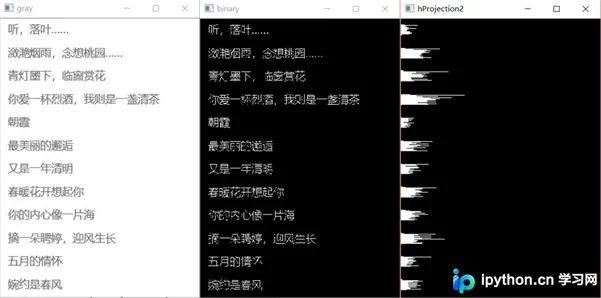
本文介绍利用Python和OpenCV库,通过水平与垂直投影法实现图像中文字的自动分割。首先对图像进行二值化处理,随后统计像素分布以确定行列边界,进而提取单个字符坐标。文中提供了完整的代码示例,并分析了中文复杂结构下的分割局限性及优化方向。
本文详细介绍Django中信号(signals)的使用机制。涵盖pre_save、post_save等五大类内置信号及其参数详解,演示通过connect和@receiver装饰器两种注册方式。重点讲解自定义信号的创建、注册及send与send_robust方法在异常处理上的区别,帮助开发者实现应用解耦。
本文深入解析Python SQLAlchemy中ORM映射的两种实现方式。首先介绍传统的mapper函数映射机制,通过定义Table、类及mapper关联实现对象与数据表对应;随后重点讲解Declarative声明式系统,展示如何继承Base类简化映射配置。通过对比两种方式的代码结构,帮助开发者理解ORM底层原理并选择合适方案。
本文介绍利用pandas库中的drop_duplicates方法提取重复数据的技巧。通过分别执行keep=False和keep='first'两种去重操作,获取完全去重与保留首条记录的差异结果,进而通过合并与再次去重找出所有重复项。
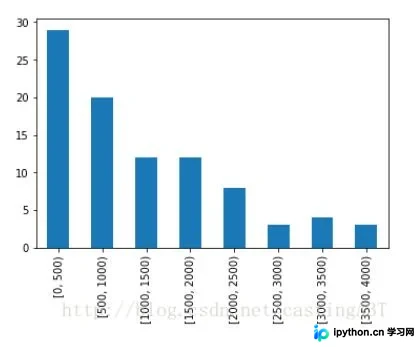
本文通过具体代码示例,演示如何利用pandas库对销售数据进行区间划分(分箱)并计算各区间频率。主要涉及pd.cut函数的区间设置、value_counts统计频数,以及通过DataFrame操作计算频率百分比与累计频率,最终结合matplotlib生成条形图可视化结果。
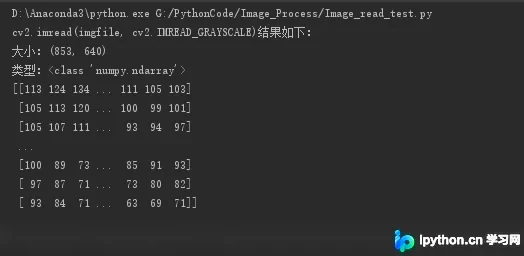
本文总结了Python3中读取图片并转换为灰度图的四种常用方法,包括OpenCV直接读取、OpenCV转换、PIL.Image模块以及TensorFlow处理。通过代码示例和运行结果对比,分析了各方法在实现细节和输出结果上的差异,建议在实际项目中保持处理链路的一致性以避免潜在Bug。
本文详细介绍Pandas中用于数据分析的累积计算(cum系列)与滚动计算(rolling系列)函数。cum系列作为DataFrame或Series的方法,用于生成前n项的累计和、积、最大值等;rolling系列则通过指定窗口大小k,对数据进行滑动窗口统计,如计算滚动均值、方差等。文章提供了具体的代码示例和输出结果,帮助开发者掌握这两种常用统计技巧。