

Python SQLAlchemy Engine 核心机制与配置详解

本文深入解析 SQLAlchemy 中 Engine 的核心作用,阐述其如何通过连接池(Pool)和方言(Dialect)驱动数据库交互。重点介绍 create_engine 的初始化流程、延迟连接机制,以及 echo、pool_size、pool_recycle 和 pool_pre_ping 等关键参数的配置方法,帮助开发者优化数据库连接效率与稳定性。
Engine 核心机制与连接池原理
首先参考官方提供的示意图,该图展示了 SQLAlchemy 内部的基本架构关系。
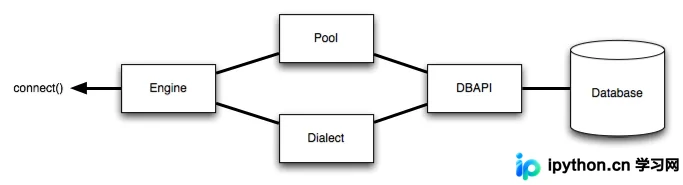
Engine 在中文语境下可理解为“引擎”,正如汽车依靠引擎提供动力,SQLAlchemy 也依赖 Engine 来驱动整个数据库操作过程。Engine 内部维护着一个连接池(Pool)对象以及方言(Dialect)配置。所谓方言,是指针对不同数据库类型(如 MySQL、Oracle、PostgreSQL 等)所采用的特定通信协议和语法解析方式。关于方言的具体细节,可参考专门的数据库方言介绍文章。
连接池机制至关重要。若每次执行 SQL 查询都重新建立数据库连接,性能损耗巨大。通过预先初始化一批连接并放入连接池,使用完毕后归还供其他请求复用,能显著提升查询效率。
Engine 初始化与参数配置详解
Engine 的初始化过程
Engine 的创建十分简便,只需调用工厂函数 create_engine 即可生成实例。
from sqlalchemy import create_engine

engine = create_engine('mysql://user:password@localhost:3306/test?charset=utf8mb4')
在构建 Engine 对象时,连接池和方言配置也随之生成,但此时并不会立即与数据库建立物理连接。只有当调用 Engine.connect() 或 Engine.execute(sql) 执行具体 SQL 请求时,才会真正建立连接。这种机制被称为“延迟初始化”,即在实际需要时才建立连接,从而节省资源。
需要注意的是,如果在创建引擎时数据库密码包含特殊字符,必须对其进行编码处理,否则可能导致连接失败。
>>> import urllib.parse
>>> urllib.parse.quote_plus("kx%jj5/g")
'kx%25jj5%2Fg'
其他数据库方言的 Engine 初始化方式,可查阅官方文档获取详细信息。
create_engine 函数支持多个可选参数,以下介绍几个核心参数及其作用。
engine = create_engine('mysql://user:password@localhost:3306/test?charset=utf8mb4',
   echo=False
   pool_size=100,
   pool_recycle=3600,
   pool_pre_ping=True)
echo 参数:当设置为 True 时,会将生成的 SQL 语句打印到控制台。虽然也可以通过配置 logger 来控制输出,但此处不作深入讨论。
pool_size 参数:用于设定连接池的大小,默认值为 5。若设置为 0,则表示连接数无限制。
pool_recycle 参数:MySQL 默认在连接空闲 8 小时后会自动断开,导致出现“MySQL has gone away”错误。设置 pool_recycle 后,SQLAlchemy 会在指定时间(秒)后自动回收并重建连接。例如,设置为 3600 表示连接在 1 小时后会被自动回收。
pool_pre_ping 参数:这是 SQLAlchemy 1.2 版本新增的功能。当值为 True 时,每次从连接池获取连接前,都会向数据库发送类似“select 1”的测试查询,以验证服务器是否正常运行。若检测到连接断开,该连接及池中的其他连接将被统一回收,确保连接的可用性。
参考链接如下:
- https://docs.sqlalchemy.org/en/14/core/engines.html#database-urls
- https://stackoverflow.com/questions/34322471/sqlalchemy-engine-connection-and-session-difference
- https://docs.sqlalchemy.org/en/13/core/pooling.html#dealing-with-disconnects
以上内容涵盖了 SQLAlchemy Engine 的主要配置与原理,希望对读者有所帮助,欢迎继续支持本站获取更多技术分享。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









