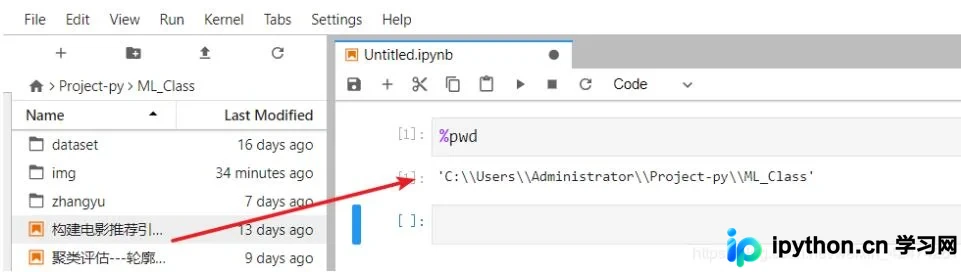
Jupyter Lab文件导出与下载实用指南
本文介绍Jupyter Lab中文件导出的两种常用方式。首先通过%pwd命令定位实际工作目录,理解其与磁盘文件的同步关系。接着详解直接复制文件以及利用浏览器右键菜单中的“在新标签页打开”或“复制下载链接”功能实现下载的操作步骤,帮助开发者高效管理Notebook文件。
2026-10-13
14

本文介绍Jupyter Lab中文件导出的两种常用方式。首先通过%pwd命令定位实际工作目录,理解其与磁盘文件的同步关系。接着详解直接复制文件以及利用浏览器右键菜单中的“在新标签页打开”或“复制下载链接”功能实现下载的操作步骤,帮助开发者高效管理Notebook文件。
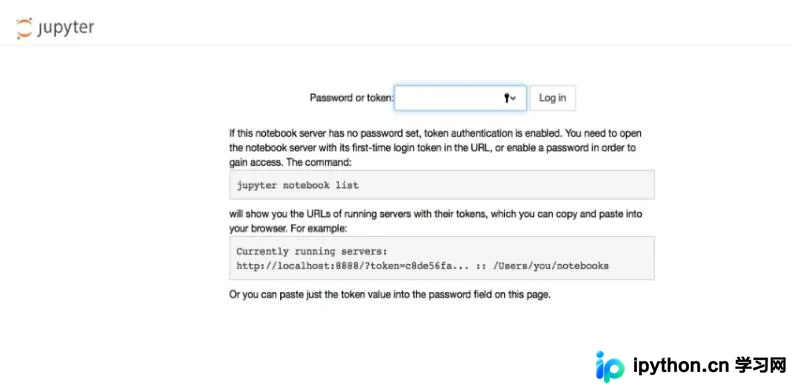
本文介绍解决Jupyter Notebook启动时要求输入密码的方法,通过运行jupyter notebook list获取Token值填入即可。同时补充Python编程中常见的NameError: name '_name_' is not defined错误,指出该变量应为双下划线的__name__,提醒开发者注意书写规范。
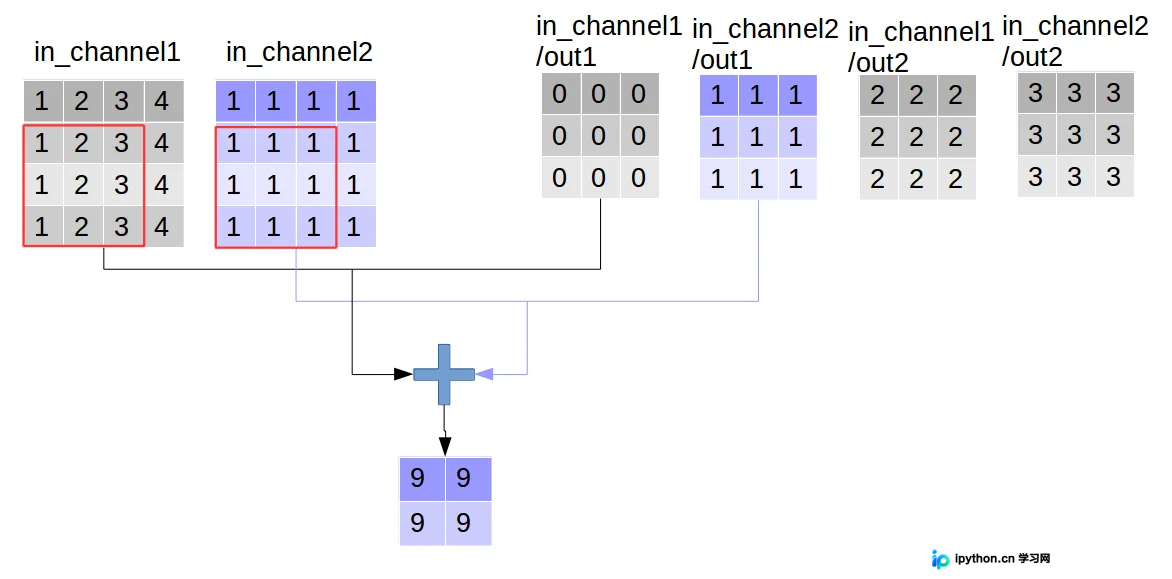
本文深入解析TensorFlow中tf.nn.depthwise_conv2d函数的实现原理。详细阐述其五个核心参数:input、filter、strides、padding和rate,并对比普通卷积与深度卷积在通道处理上的差异。通过构建自定义输入图像与卷积核的完整代码示例,直观展示深度卷积的计算过程与输出结果,帮助开发者理解并应用该技术在模型轻量化中的优势。
本文深入解析Python中的assert断言机制。介绍assert的基本语法、可选参数用法,通过代码示例展示断言失败时如何抛出AssertionError。同时说明如何通过-O参数关闭断言,帮助开发者掌握这一简单的异常处理工具。
本文介绍在Jupyter Notebook环境中使用argparse库时,parser.parse_args()因识别到Jupyter内部参数而报错的解决方案。通过将参数列表设为空数组args=[],可成功解析自定义命令行参数。
在Python Spyder环境中使用Pandas查看DataFrame时,常因列数或行数过多导致数据显示省略号。本文介绍利用pd.set_option函数调整display.max_columns和display.max_rows参数,完整展示所有数据列与行,解决Spyder下的显示截断问题。
在TensorFlow调试过程中,直接print无法获取Tensor数值。本文详解如何利用tf.Session和tf.InteractiveSession两种机制,通过sess.run()或Tensor.eval()正确输出张量值,并对比不同初始化方式下的代码实现。
本文详细解析如何在Python项目中创建和管理虚拟环境,重点介绍使用virtualenv和virtualenvwrapper-win进行环境隔离的方法。内容涵盖从安装依赖包、创建及切换虚拟环境,到在PyCharm中配置自定义环境,以及最终执行alembic init初始化数据库迁移工具的完整操作流程,帮助开发者规范项目环境配置。

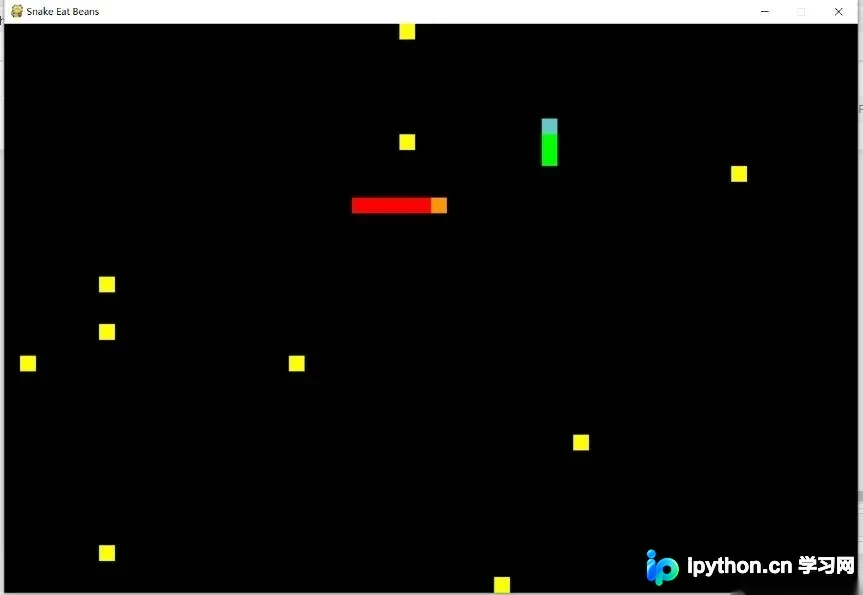
本文详细介绍如何使用Python和Pygame库开发一款支持双人对战的贪吃蛇游戏。文章从基础单人对战版本出发,逐步重构代码,引入蛇类与豆子类,实现双人独立控制、自定义颜色、蛇头高亮显示及多豆子随机生成等功能。通过面向对象的设计思路,展示了如何简化主循环逻辑并处理碰撞检测,最终提供完整可运行的代码示例,适合Python初学者进行游戏开发实践。
本文详细介绍Python中利用numpy库进行数组拼接的两种主要方式:np.append和np.concatenate。通过具体代码示例,解析一维及多维数组在指定axis维度下的拼接行为,重点说明concatenate在处理高维数据时如何通过axis参数控制元素添加方向,帮助开发者掌握高效的数据处理技巧。
本文详细介绍Python中稀疏矩阵的创建与参数保存方法。通过scipy.sparse.coo_matrix构建稀疏矩阵,利用todense转换为密集矩阵,并演示如何使用numpy.save和np.savez保存单个或多个数组及稀疏矩阵。最后讲解如何加载.npz文件并提取参数名称与值,适用于模型训练中的参数持久化场景。
本文介绍利用Python结合Selenium与Web接口技术,实现无账号、无IP限制地批量获取全国企业基本信息的方法。通过对比Selenium登录验证、Requests Cookie请求等方案的局限性,最终确定仅依赖IP代理即可有效获取可公开展示的企业数据,为数据分析提供基础素材。