Python数据预处理小工具开发:基于PySimpleGUI的GUI实现与自动化处理
本文详细介绍如何使用Python结合PySimpleGUI和Pandas库开发一款数据预处理小工具。通过构建图形用户界面,实现Excel文件的读取与预览,并自动化处理重复值、缺失值及异常值。文章涵盖界面布局设计、核心代码解析、数据处理逻辑及使用PyInstaller打包成可执行文件的全过程,旨在提供一键完成数据清洗的实用方案。
2026-10-14
9

本文详细介绍如何使用Python结合PySimpleGUI和Pandas库开发一款数据预处理小工具。通过构建图形用户界面,实现Excel文件的读取与预览,并自动化处理重复值、缺失值及异常值。文章涵盖界面布局设计、核心代码解析、数据处理逻辑及使用PyInstaller打包成可执行文件的全过程,旨在提供一键完成数据清洗的实用方案。
本文详解Python中raise语句的语法与作用,分析异常触发与传递流程。通过内置异常、自定义异常及异常链携带信息的三个实战示例,展示如何精准抛出和处理错误,提升代码稳定性与调试效率。
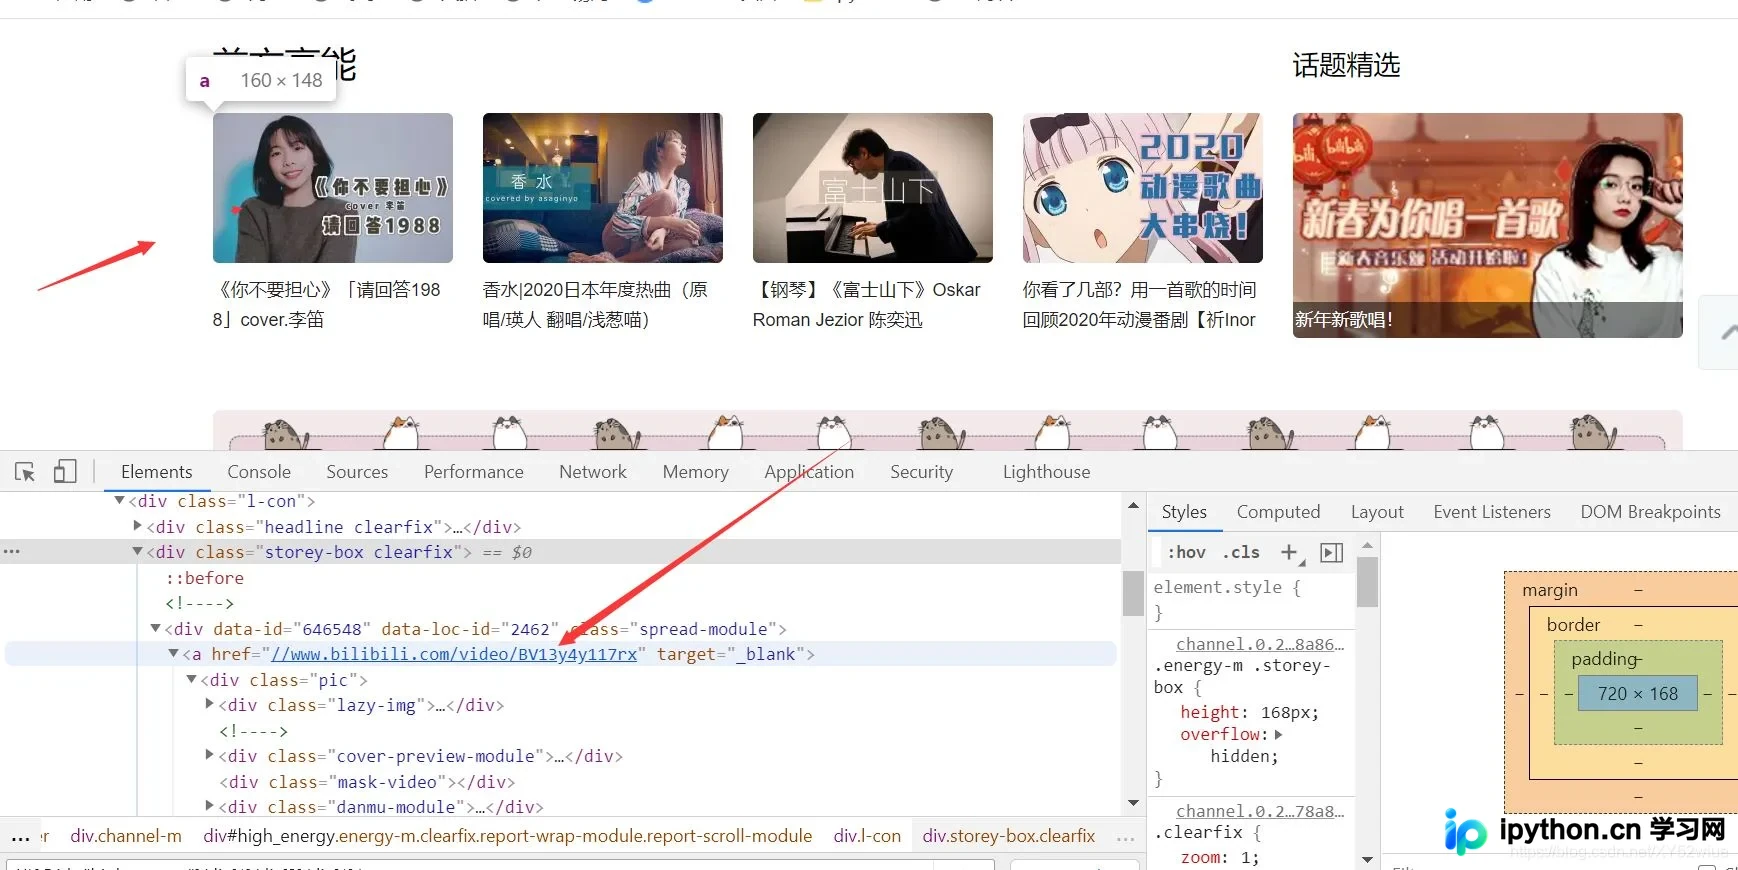
本文通过B站爬虫案例,指出Selenium中使用XPath直接获取属性(如./a/@href)会报错,正确做法是先定位元素节点再调用get_attribute()方法。文章提供了完整的Python代码示例,展示了如何在无头浏览器环境下解析网页数据并提取链接与标题。
本文介绍在Python爬虫开发中,如何获取HTTP重定向后的最终URL。通过urllib库的urlopen方法和requests库的get方法,分别展示了两种获取重定向地址的代码实现。重点解析了如何从响应对象中提取最终跳转后的网址,并提供了包含User-Agent请求头设置的示例,帮助开发者解决爬虫追踪真实链接的问题。
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。
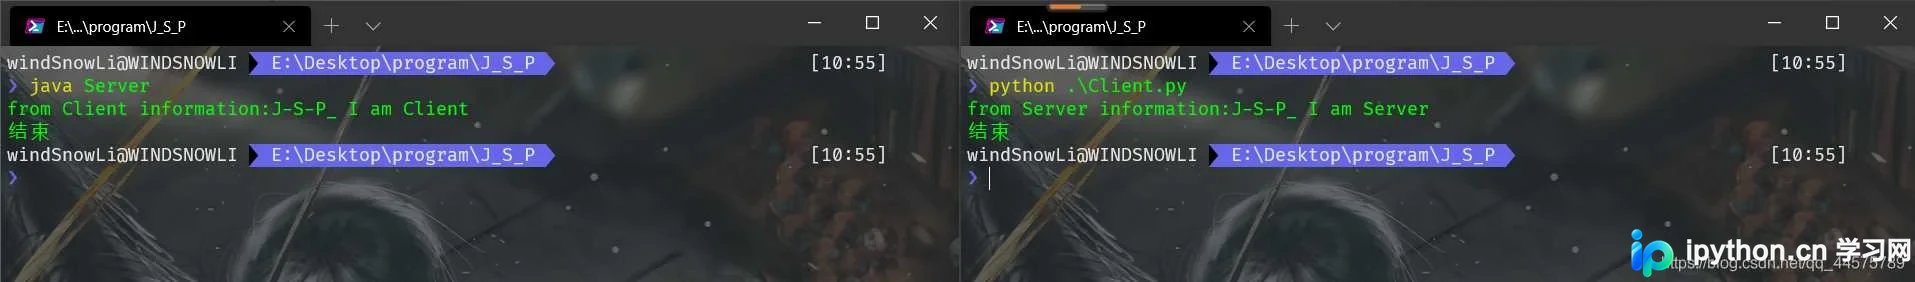
本文详细演示了Python客户端与Java服务端通过Socket进行单线程通信的完整实现。涵盖Java服务端监听端口2580、接收数据并返回响应的代码,以及Python客户端连接、发送消息并接收结果的示例。通过具体代码片段,帮助开发者快速掌握跨语言Socket通信的基本流程与关键参数设置。
本文详解Python jieba库的三种核心分词模式:精确模式、全模式及搜索引擎模式,并通过代码实例展示jieba.cut()、jieba.lcut()及jieba.cut_for_search()的具体用法与输出差异。此外,文章还介绍了利用jieba.posseg模块进行词性标注及动词提取的实操方法,帮助开发者掌握中文文本处理的关键技术。
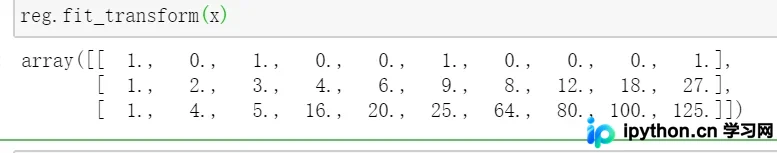
本文详细解析了Python中sklearn库PolynomialFeatures生成多项式特征的逻辑,并通过自定义函数实现相同功能。文章对比了sklearn输出与手动实现结果,验证了两者的一致性,并探讨了处理多维数组时的实现思路。
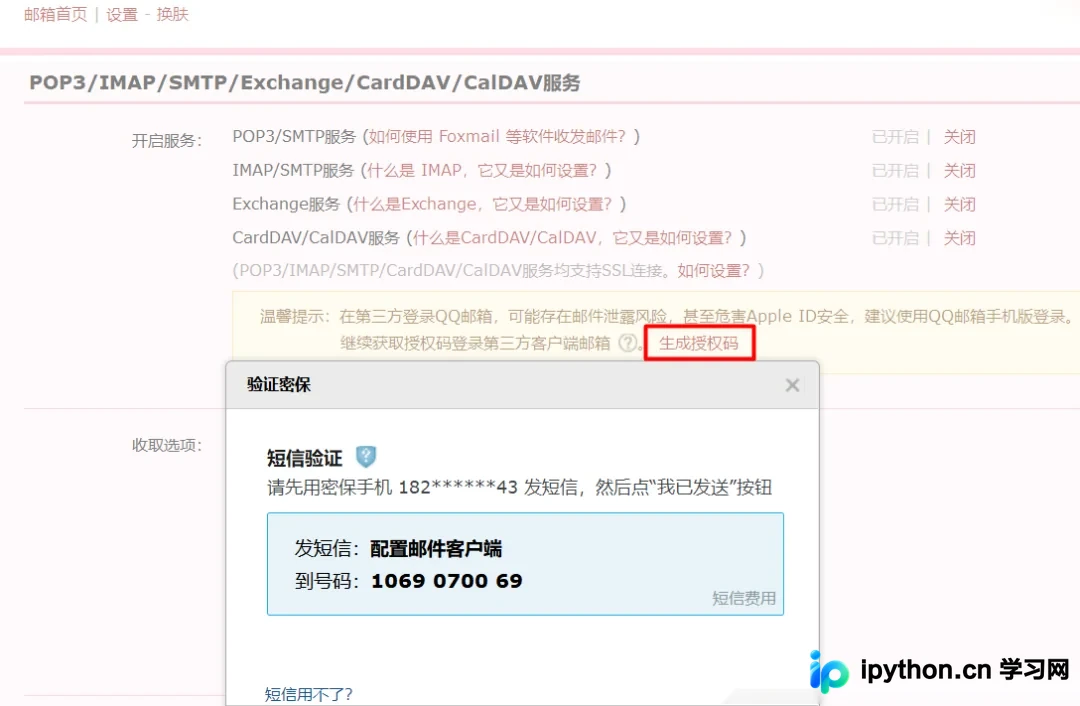
本文详解Python中利用smtplib和email模块实现邮件自动化的完整流程。涵盖纯文本、HTML及带附件邮件的构建方法,包括MIMEText与MIMEMultipart的使用。以QQ邮箱为例,演示开启SMTP、生成授权码及发送代码,并介绍基于磁盘监控的自动化场景,帮助开发者快速掌握邮件发送技术。
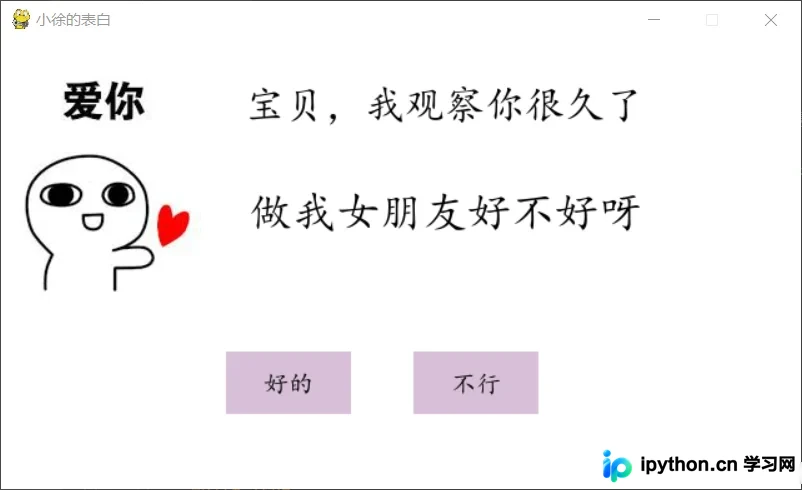
本文介绍使用Python和Pygame库开发的一款交互式表白程序。该程序通过图形界面实现点击交互,当用户尝试关闭或拒绝时,窗口无法退出并展示预设优点信息。文章提供了完整的代码结构说明及字体、图片素材的依赖配置指南,适合Python初学者了解GUI事件循环与窗口控制机制。
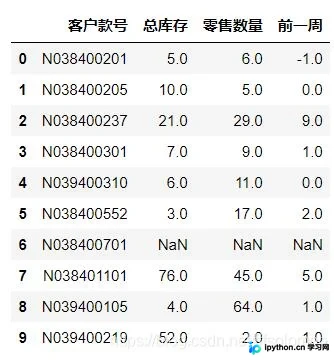
本文详细介绍如何使用Python的xlsxwriter库,通过循环逻辑将客户款号、库存等数据按特定格式写入Excel,并自动关联插入对应图片。文章涵盖xls与xlsx格式库的区别、常见操作类库对比,以及xls/xlsx的具体读写代码示例,帮助开发者高效处理Excel自动化任务。