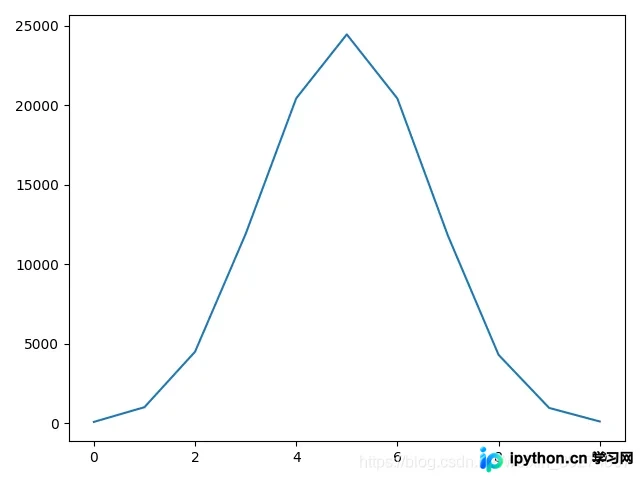
Python生成0到1随机数及抛硬币模拟实现
本文介绍Python中利用random模块的random()函数生成[0,1)区间随机数的方法,并通过模拟抛硬币实验展示其实际应用。代码包含统计正反面次数及绘制概率分布图,帮助理解随机数在概率模拟中的使用。
2026-10-16
9

本文介绍Python中利用random模块的random()函数生成[0,1)区间随机数的方法,并通过模拟抛硬币实验展示其实际应用。代码包含统计正反面次数及绘制概率分布图,帮助理解随机数在概率模拟中的使用。
本文详细介绍如何在PyCharm中通过pymysql库连接MySQL数据库。内容涵盖Ubuntu服务端开启远程连接、配置用户权限,以及客户端使用pymysql建立连接、执行SQL语句、提交事务及关闭连接的完整流程,并提供基于学生成绩数据库的Python代码示例。
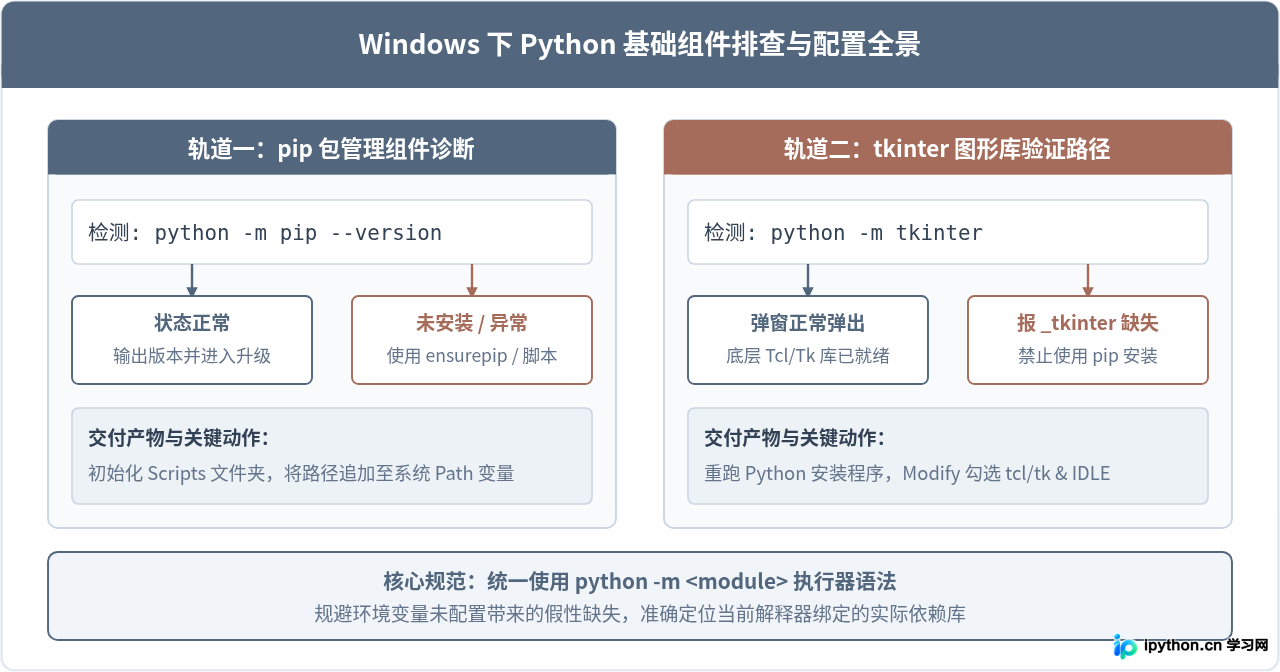
详细介绍在Windows操作系统下安装与修复Python包管理器pip、排查环境变量Path,以及正确验证与补全图形库tkinter可用性的具体操作步骤与排错方法。
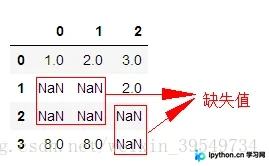
本文详细介绍Pandas中fillna()函数处理缺失值的多种方法。涵盖inplace参数对原对象的影响、method参数(ffill/bfill)的前后填充逻辑,以及limit和axis参数的控制技巧。通过常数填充、字典映射及具体代码示例,帮助开发者高效完成数据清洗任务。
本文详细介绍Pandas中计算相关性系数的corr()方法。涵盖相关性的定义、正负相关判断及系数范围[-1,1]。重点解析method参数的三种选项:pearson(线性)、kendall(分类/无序)和spearman(非线性),并通过一元二次方程示例对比各系数在非线性数据下的表现差异,强调相关性与因果性的区别。
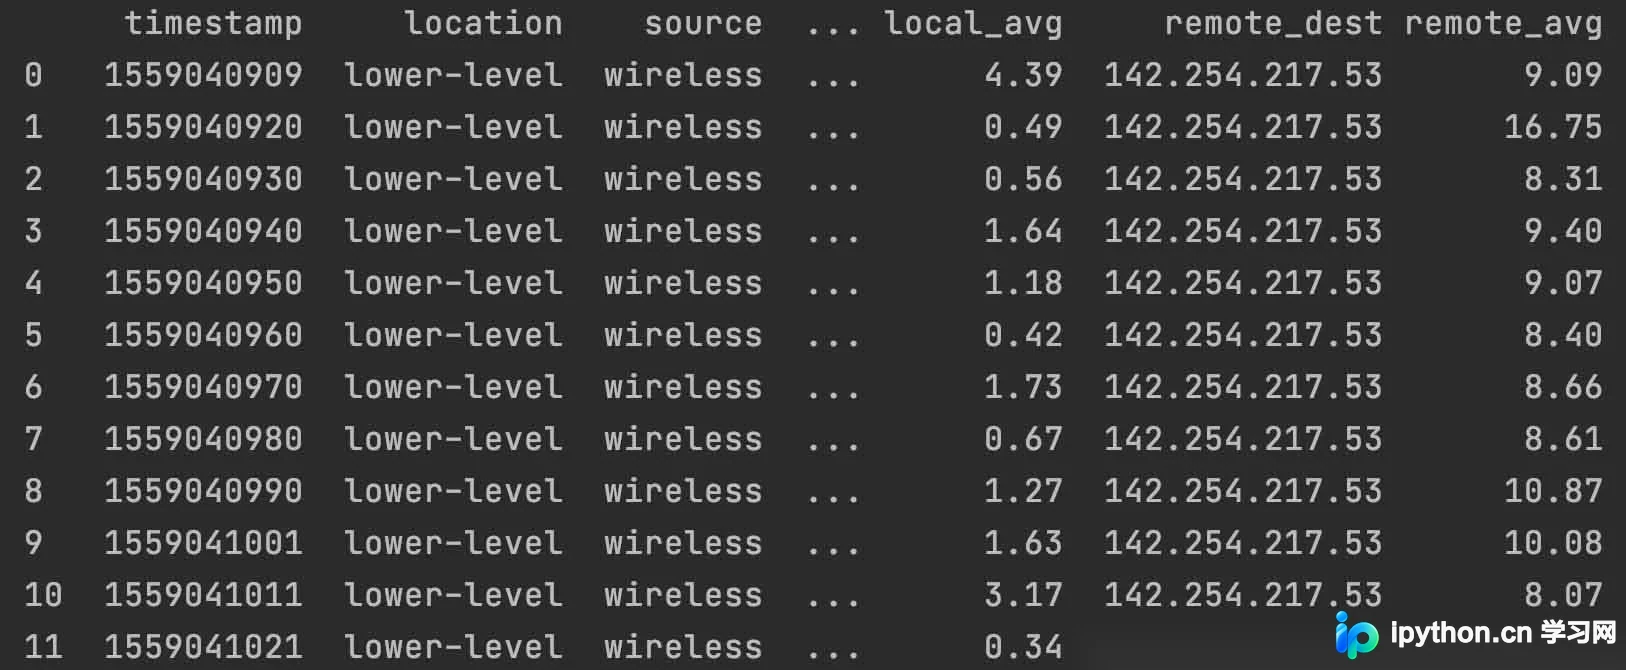
本文详解在pandas中将整数类型的时间戳转换为datetime格式的正确步骤。指出直接转换导致的1970年错误,并演示先转为字符串再使用to_datetime()的修正方案。同时介绍DatetimeIndex、date_range生成时间序列,以及利用dt属性提取时间分量和Timedelta计算时间差的高级用法。
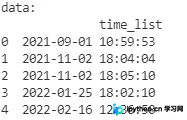
本文详解pandas库中to_datetime()函数的核心用法,重点讲解如何将CSV数据中的Unix时间戳(timestamp)通过指定unit='s'参数转换为标准的datetime格式,并附带代码示例与运行结果分析,帮助开发者高效处理时间序列数据。
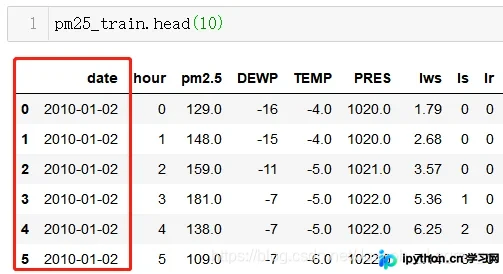
本文介绍如何在pandas中提取Timestamp对象的日期部分,以及处理非数值日期属性的方法。通过调用.date()获取纯日期,或将字符串类型的日期列拆分为年、月、日单独列,以便直接输入机器学习模型进行数据挖掘。
本文介绍Python中正则表达式的基础概念,包括原子、元字符及模式修正符。重点讲解如何实现字符串的重叠匹配,并详细解析re模块中search、match、compile、findall及sub等常用函数的用法与参数,帮助开发者高效进行文本提取与清洗。
本文深入解析Python中闭包与Lambda表达式常见的作用域陷阱。由于Python采用LEGB查找规则且闭包具有迟绑定特性,循环变量在内部函数调用时才被查询,导致所有函数返回相同结果。文章通过生成器、列表推导及filter迭代器三个典型案例,详细演示了问题成因,并提供了将闭包作用域转换为局部作用域的有效修复方案。
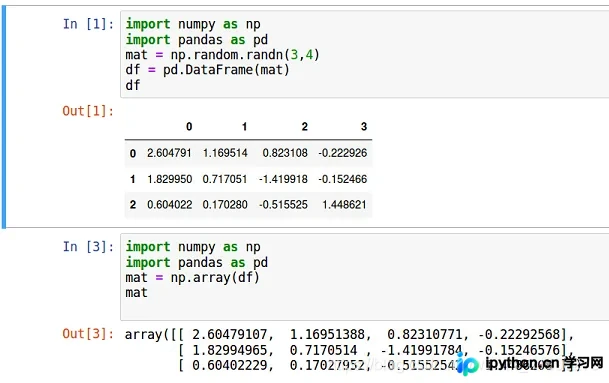
本文介绍Python中NumPy数组与Pandas DataFrame之间的相互转换方法。内容包括将NumPy数组转换为DataFrame,以及将DataFrame转换为NumPy数组的三种常用方式:values方法、as_matrix()方法和np.array()函数,帮助开发者在数据分析时灵活处理两种数据结构。
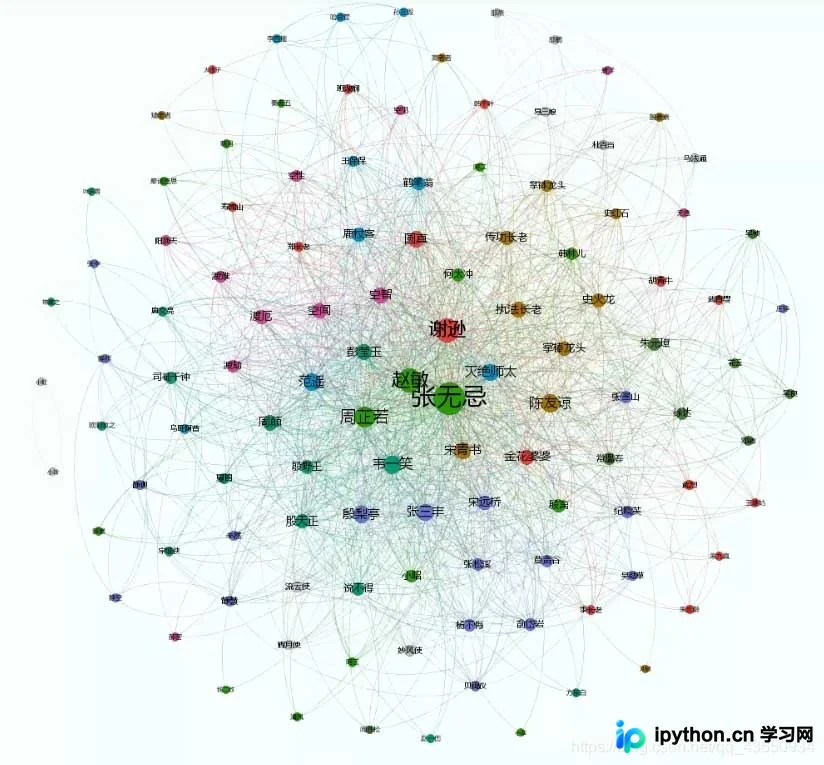
本文详细解析Python中如何构建共现矩阵并进行可视化。通过jieba分词提取关键词,利用二维数组统计词对共同出现次数,生成对称矩阵。文章提供了完整的Python代码实现,包括矩阵构建、清洗及占比计算,帮助开发者理解词组亲密度分析原理。