Python批量生成SQL Insert语句的两种实现方式
本文介绍使用Python批量生成数据库Insert语句的两种常用方法。第一种通过字符串直接拼接构建SQL,第二种利用列表存储字段值并在生成后替换括号符号。文章提供了完整的代码示例及注意事项,帮助开发者高效处理大量数据插入场景。
2026-10-14
8

本文介绍使用Python批量生成数据库Insert语句的两种常用方法。第一种通过字符串直接拼接构建SQL,第二种利用列表存储字段值并在生成后替换括号符号。文章提供了完整的代码示例及注意事项,帮助开发者高效处理大量数据插入场景。
本文详细介绍如何使用Python脚本结合crypt模块对Linux系统进行密码破解测试。通过解析/etc/shadow文件中的加密格式,提取盐值(salt)与哈希算法ID,利用字典文件进行暴力匹配。文章涵盖Python字符串split()方法的深入应用及代码实现细节,旨在帮助安全研究人员理解口令验证机制。
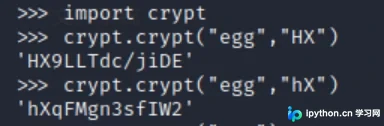
本文详细解析了Flask官方推荐的目录结构,包括蓝图(Blueprint)的注册与应用工厂模式。接着介绍了如何集成Flask-SQLAlchemy进行数据库操作,利用Flask-Script实现命令行启动与自定义脚本,并通过Flask-Migrate完成数据库迁移。涵盖从项目搭建到数据库管理的完整流程,适合Flask初学者参考。
本文详细介绍基于Python Flask框架实现用户密码修改与免密登录的具体方案。内容涵盖数据库操作、后端路由处理、前端HTML表单交互以及JavaScript异步请求。重点解析如何通过Flask设置Cookie实现15天免密登录,包括手机号与密码的持久化存储逻辑及会话管理。
Python开发中pip下载速度慢且易出错是常见问题。本文介绍如何将pip源替换为清华、阿里云等国内镜像以大幅提升速度。内容涵盖临时使用-i参数指定源,以及在Linux和Windows系统中通过配置文件永久修改默认源的方法,帮助开发者提高安装成功率。
本文详细介绍在 pandas 中如何高效处理 DataFrame 数据。涵盖按列、索引及特定行列的选取方法,包括 loc、iloc 等核心属性;讲解基于单一或多条件的行记录筛选技巧;演示将分类变量如性别进行数值替换的两种常用方式;最后提供删除特定条件行的操作示例,帮助开发者快速掌握数据预处理关键步骤。
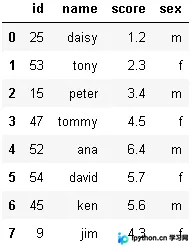
本文解析Python中列表append()方法返回None的原因。由于append是原地修改列表,不返回新对象,直接赋值会导致变量变为None。文章提供了错误代码示例与修正方案,强调应直接调用append而不接收返回值,从而正确获取更新后的列表内容。
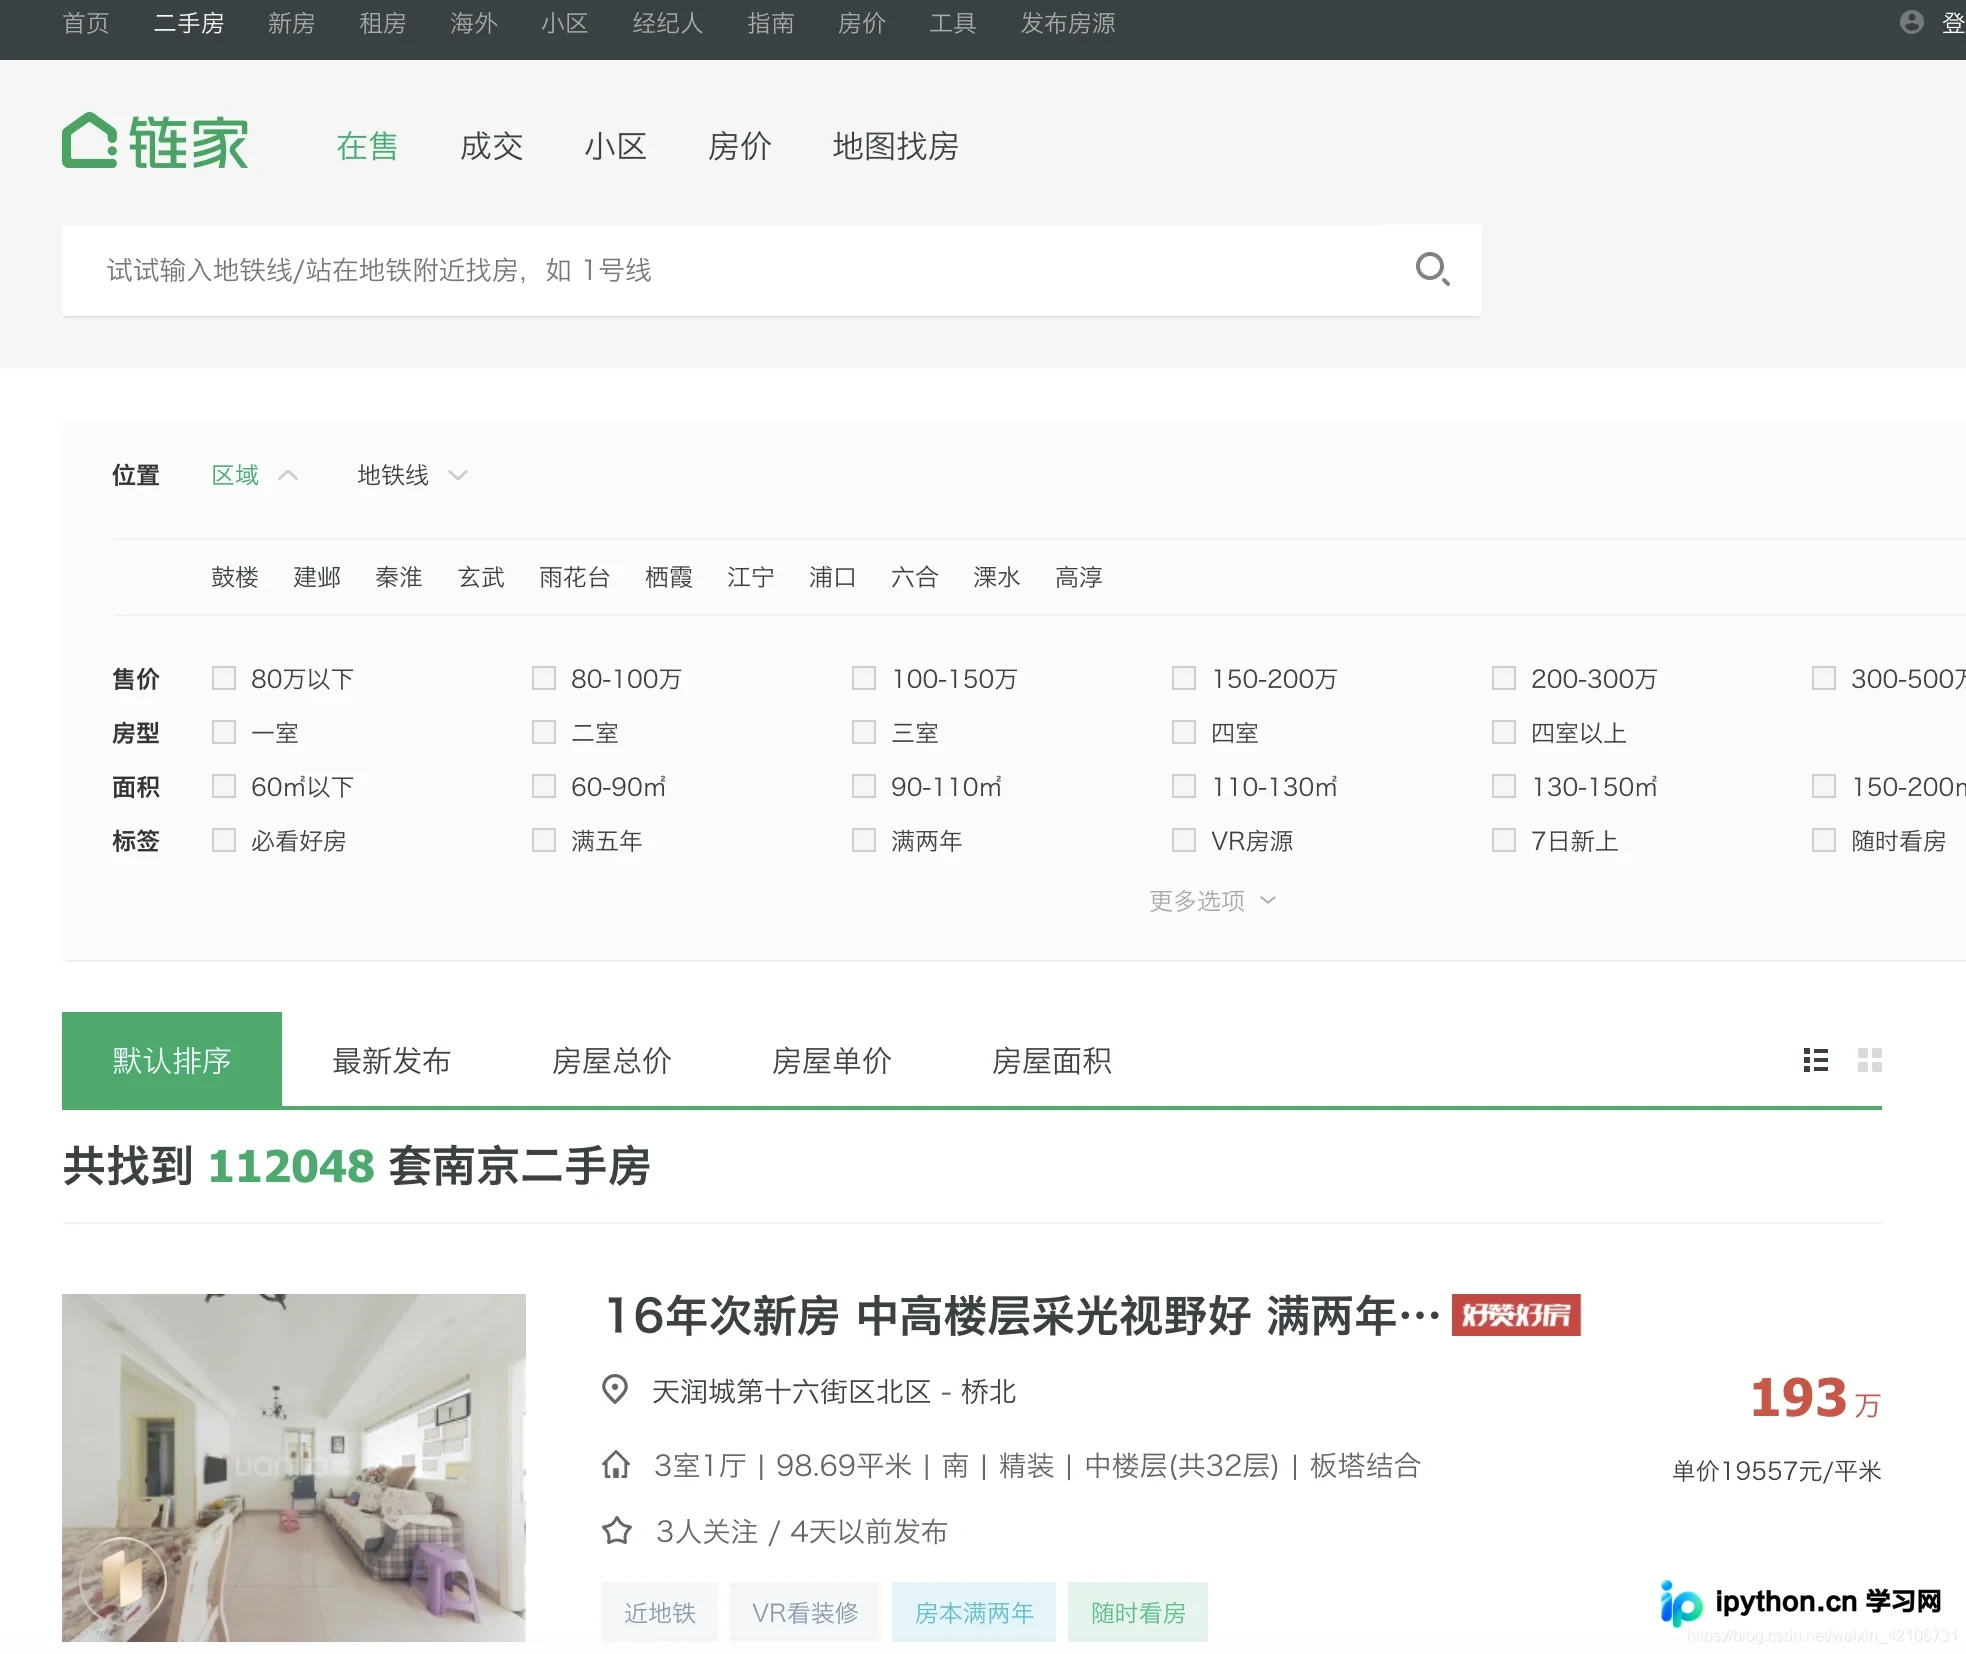
本文详细介绍使用Python爬取链家二手房数据的完整流程。通过Requests获取页面HTML,利用BeautifulSoup解析DOM结构,提取标题、户型、面积、朝向、装修、位置及价格等关键信息。文章涵盖数据定位、HTML获取及解析代码示例,帮助开发者掌握基础爬虫技巧。
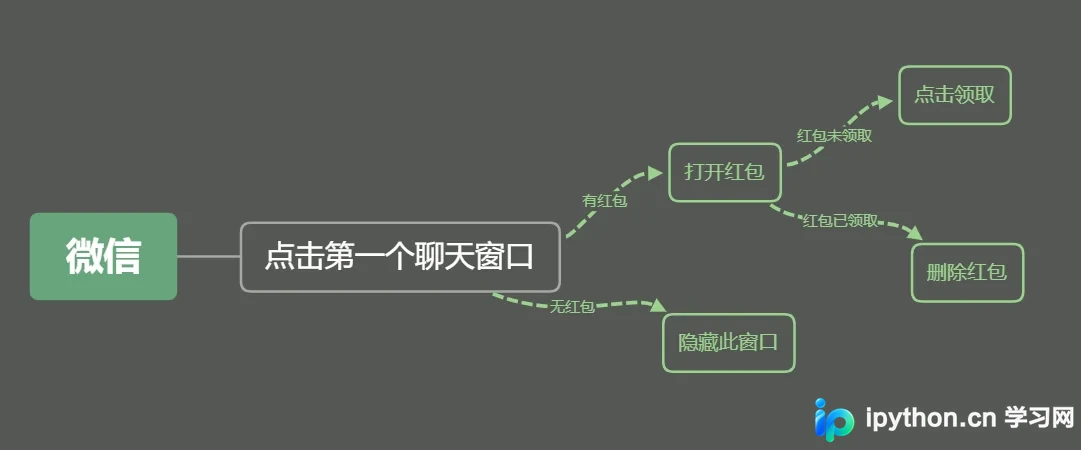
本文介绍如何利用Python和Appium框架实现微信红包的自动领取功能。通过配置Android设备参数,结合元素定位与长按操作,自动识别并领取红包,同时处理公众号消息干扰。文章提供了完整的代码示例和关键步骤解析,帮助开发者快速掌握自动化抢红包的实现方法。
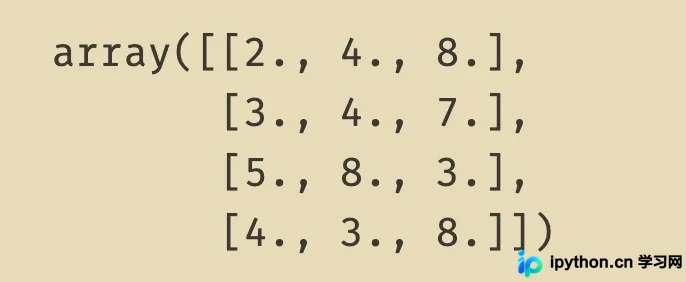
本文介绍如何利用 scikit-learn 0.22 版本新增的 KNNImputer 类,通过 KNN 算法原理对数据集中的缺失值进行高效插补。文章通过简单示例和 Kaggle 皮马印第安人糖尿病数据集的实际案例,详细演示了从导入库、处理零值缺失、设置邻居数到最终填充的全过程,并指出该方法仅支持数值型特征。
本文详细介绍Pandas中DataFrame转换为字典的多种方法。重点解析to_dict()函数的orient参数,包括dict、list、series、split、records和index六种模式的具体输出格式与适用场景,帮助开发者根据需求选择最合适的转换方式。
本文详细解析Python Pandas中duplicated()与drop_duplicates()函数的核心区别。通过生成测试数据,演示如何判断行重复及删除重复值。重点说明duplicated()返回重复出现的行(仅显示n-1条),而drop_duplicates()直接返回去重后的完整数据框,默认保留第一条记录。