Python实现小明种苹果算法:环形列表处理的简洁方案
本文深入解析Python解决“小明种苹果”问题的多种实现方式,重点探讨环形数组中连续三棵树掉落情况的统计方法。通过对比索引取余、列表拼接及直接遍历等策略,提供一种从列表尾部开始读取的简洁代码方案,并附带其他常见解法供参考,旨在帮助开发者更高效地处理此类边界条件复杂的算法题。
2026-10-14
8

本文深入解析Python解决“小明种苹果”问题的多种实现方式,重点探讨环形数组中连续三棵树掉落情况的统计方法。通过对比索引取余、列表拼接及直接遍历等策略,提供一种从列表尾部开始读取的简洁代码方案,并附带其他常见解法供参考,旨在帮助开发者更高效地处理此类边界条件复杂的算法题。
本文针对500万行级别的大规模数据,系统对比了Pandas中iloc、at、apply及Series直接处理的速度差异。实测显示,iloc耗时约5小时,at优化至10分钟,而转为Series处理仅需37秒。此外,文章通过数值实验深入剖析了loc、at、iloc、iat及直接访问values数组在读取与修改场景下的性能表现,指出直接获取二维数组再定位是最高效方案,并提供了相应的代码实现与优化建议。
本文详细解析Python函数定义与调用中*和**运算符的作用。在定义时,*将多余位置参数打包为元组,**将关键字参数打包为字典;在调用时,*用于解压序列类型数据,**用于解压字典并匹配关键字。通过代码示例展示正确用法及常见报错场景。
本文深入解析Python中asyncio异步编程的核心原理。从协程的概念出发,对比多线程与协程的优劣,介绍greenlet、gevent及asyncio的发展脉络。重点讲解async/await关键字的使用、事件循环机制、Task对象管理以及IO密集型场景下的性能优化策略,帮助开发者掌握高效的并发编程技巧。
本文介绍使用Python批量提取指定文件夹内同类型文件的实现方法。通过实例代码展示如何遍历文件夹、判断文件后缀并复制到目标路径,帮助读者快速掌握文件批量处理技巧。
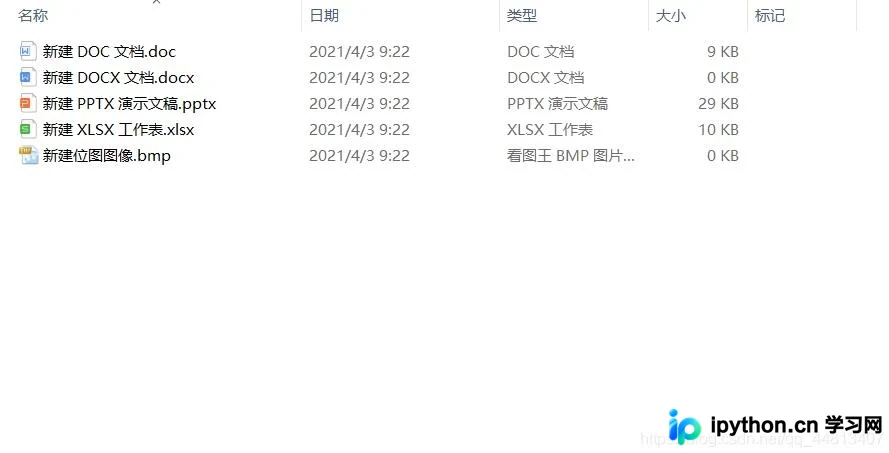
本文介绍如何利用Python的xlrd和xlwt模块合并多个Excel文件中的多个Sheet。核心思路是将不同文件的相同Sheet内容视为列合并,再将不同Sheet内容视为行合并。通过遍历列表一次性写入数据,避免追加写入限制,最终生成包含所有源文件内容的单一Excel文件。
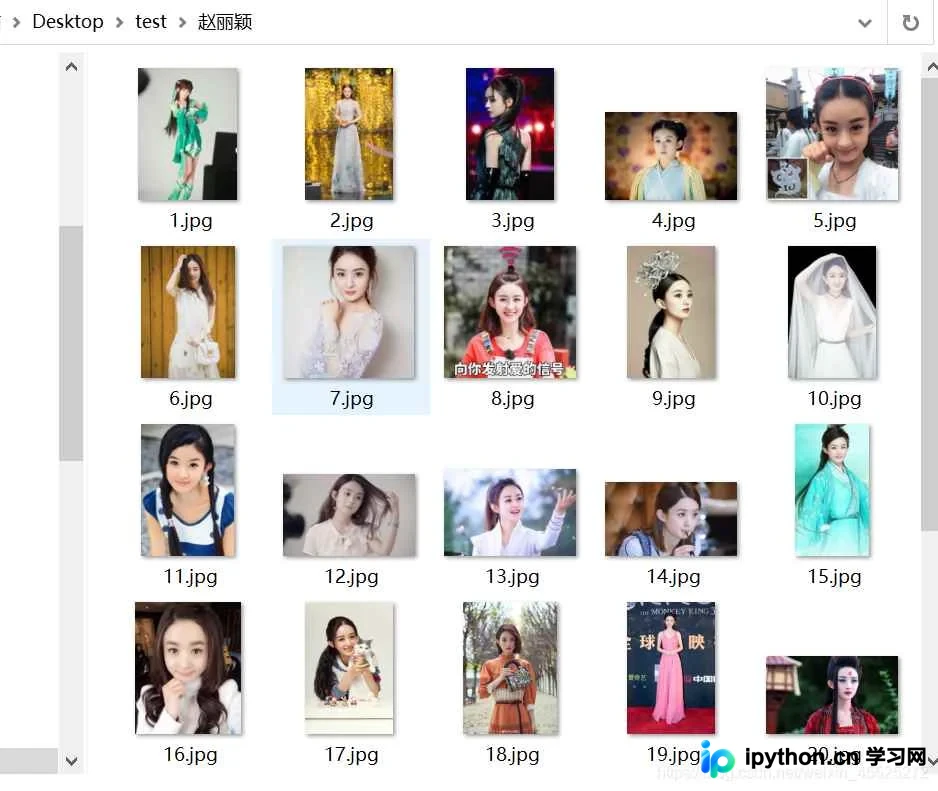
本文介绍如何使用Python编写爬虫程序,从百度图片批量下载指定关键词的图片。核心功能是根据关键词列表自动创建对应的独立文件夹,并将下载的图片按顺序编号保存至各自目录中。文章提供了完整的代码示例及参数配置说明,包括如何设置请求头、控制爬取页数以及处理图片保存路径,帮助用户实现高效的图片分类抓取与存储。
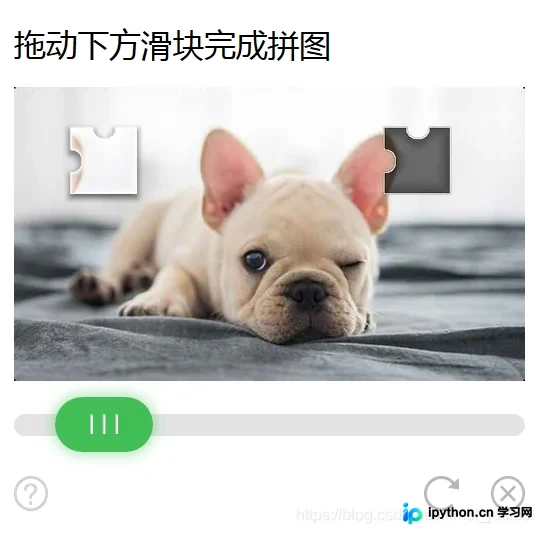
本文详解如何利用Python和OpenCV库识别滑块验证码中的缺口位置。通过读取背景与缺口图片,使用Canny算子提取边缘并转换为RGB格式,再借助matchTemplate函数进行模板匹配,最终定位最大相关系数点以获取缺口X轴坐标。文章提供完整代码封装,适用于爬虫开发中的验证码破解场景。
本文详细介绍如何结合Tushare、PyCharm和Excel进行股票数据分析。通过PyCharm安装numpy、tushare和matplotlib库,使用Tushare接口获取指定股票的历史交易数据,并导出至Excel。为解决PyCharm写入Excel时覆盖其他Sheet的问题,文章提出建立双文件同步策略,利用Excel公式实现数据自动关联,最终支持K线、MACD等技术指标分析。
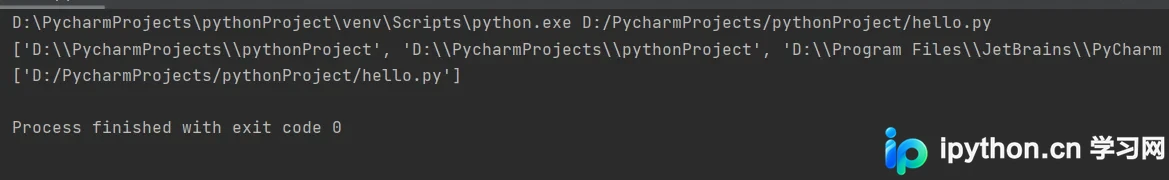
本文详解Python模块导入规范,对比import与from...import语句的优劣,指出直接调用属性可能带来的可读性问题。深入解析sys.path列表机制,演示如何通过append和insert方法动态添加搜索路径,实现多级目录下的模块导入,确保代码规范与可维护性。
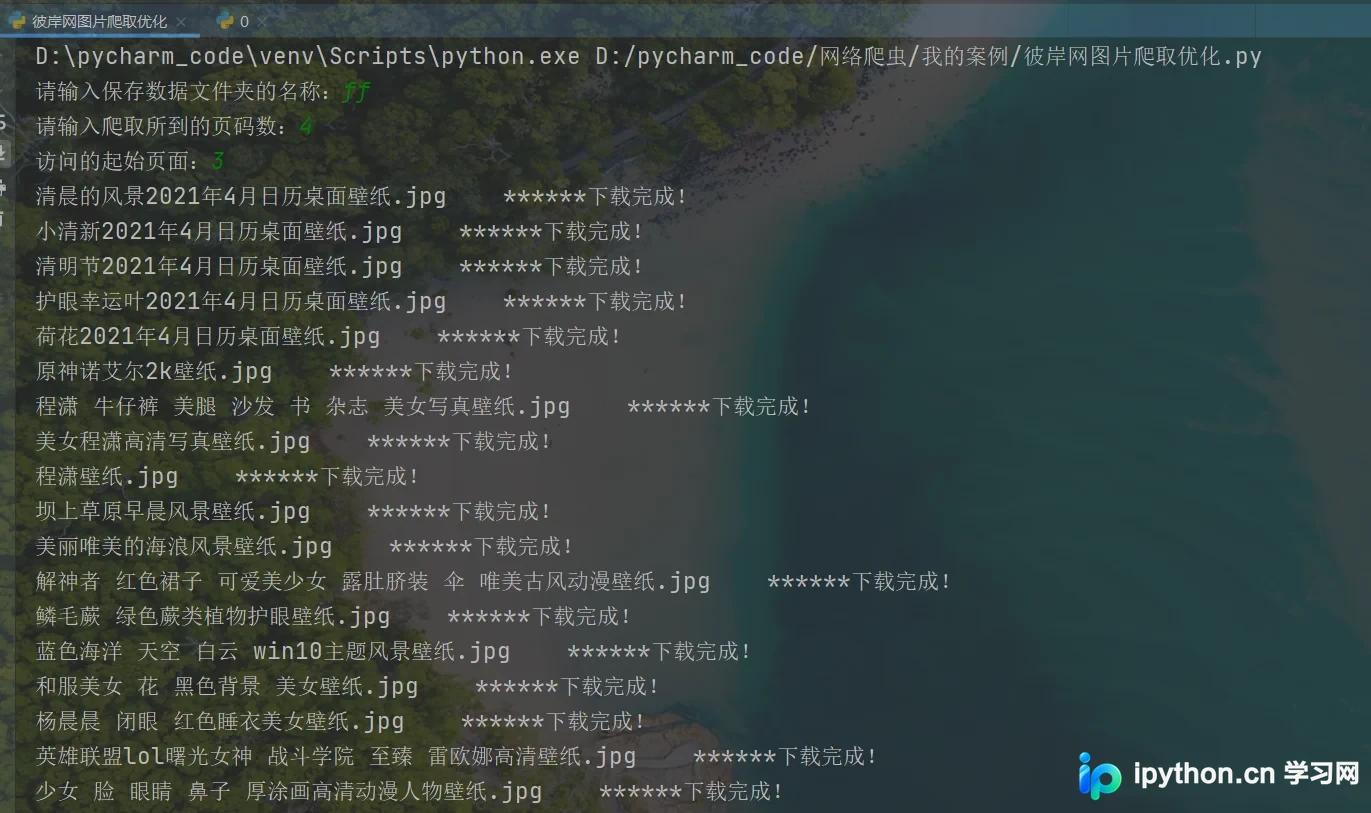
本文以彼岸桌面网站为例,详细演示如何使用 Python 编写爬虫程序批量下载高清无损壁纸。内容涵盖环境配置、HTML 解析、文件夹创建及图片保存等核心步骤,并附带完整可运行代码与结果展示,适合初学者学习网络数据采集基础。
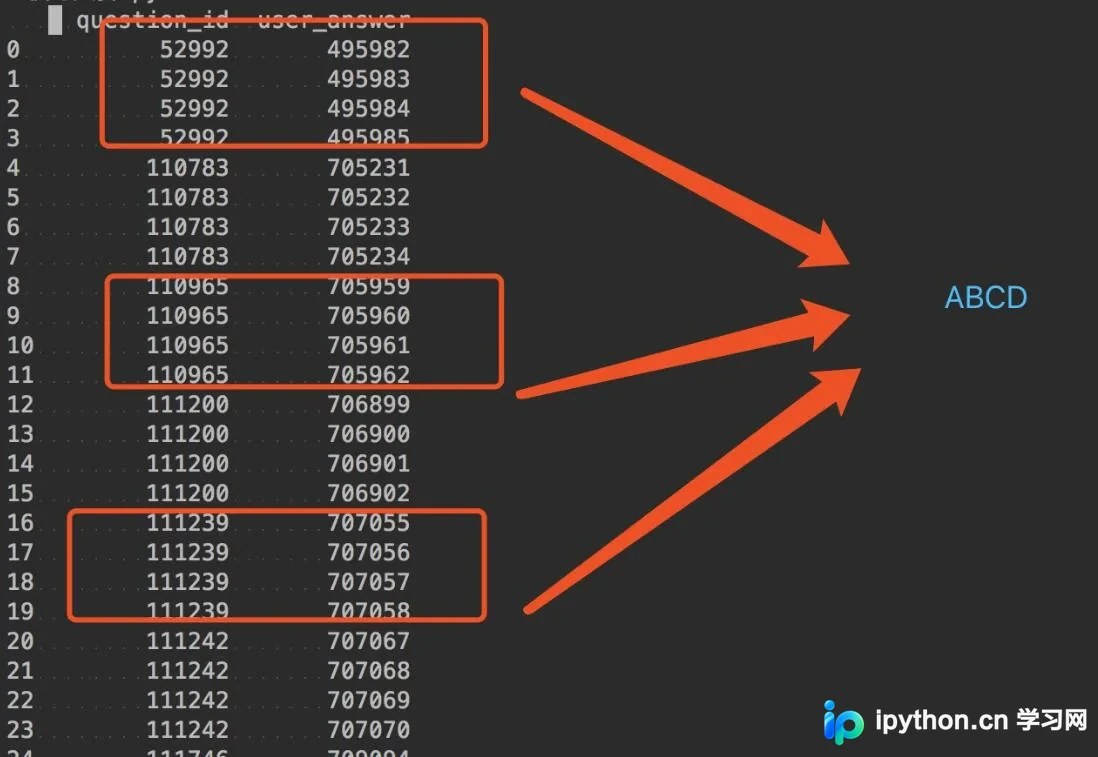
本文介绍如何利用pandas实现分组后提取第N行数据,并通过示例将question_id对应的user_answer转换为ABCD选项。同时详细解析nlargest()函数的用法,包括获取最大前几行、处理重复值及分组求和等场景,帮助读者掌握高效的数据筛选技巧。