怎么将Python爬取的所有网页保存为本地可离线浏览的HTML结构
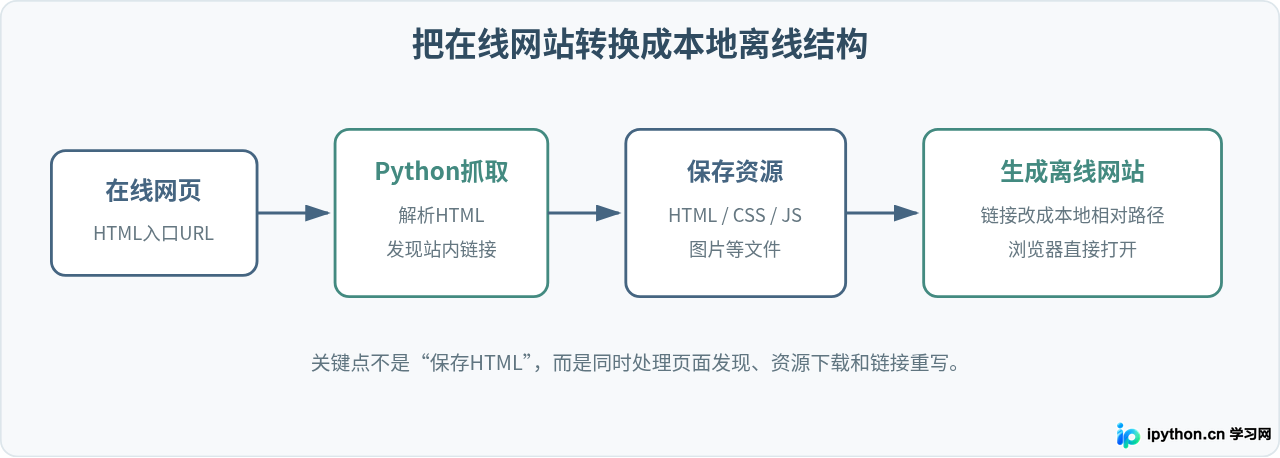
讲解如何使用Python批量爬取网站页面,将HTML、CSS、JavaScript和图片等资源保存到本地,并重写网页链接,形成可以离线浏览的完整HTML目录结构。
2026-09-18
9

讲解如何使用Python批量爬取网站页面,将HTML、CSS、JavaScript和图片等资源保存到本地,并重写网页链接,形成可以离线浏览的完整HTML目录结构。
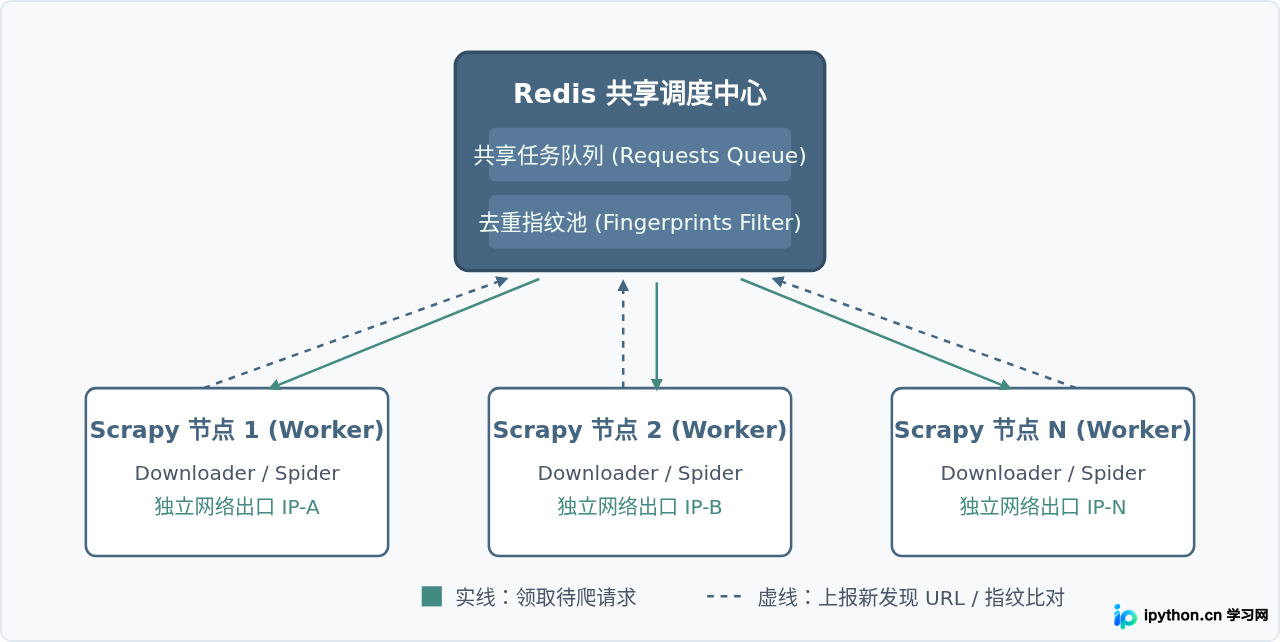
本教程详细讲解如何使用Python Scrapy与Redis构建高可用、大规模的分布式网络爬虫项目,涵盖架构原理、环境搭建、代码编写、节点部署及监控运维。
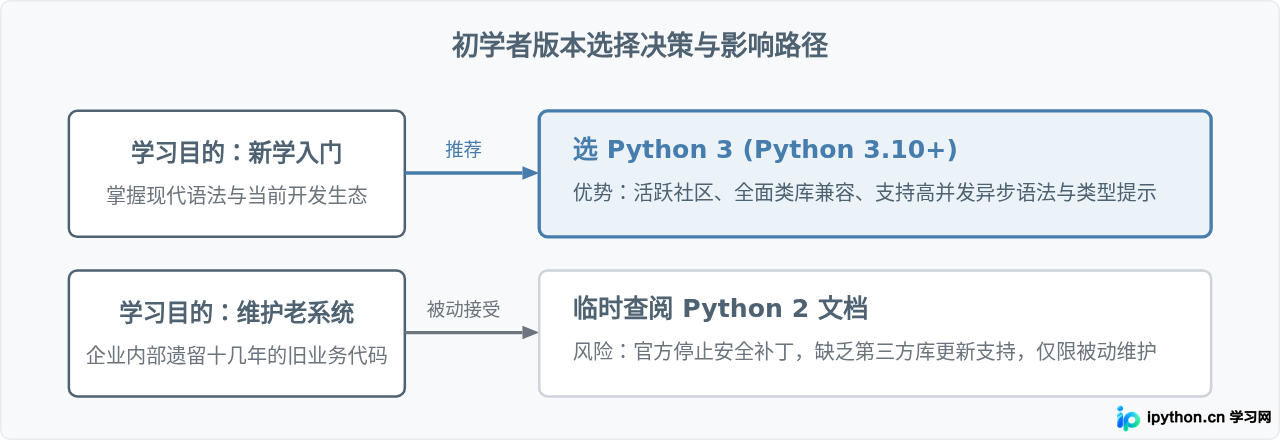
全面对比Python 2与Python 3的核心语法、底层机制差异,并为初学者提供清晰明确的版本选择依据与环境上手指南。
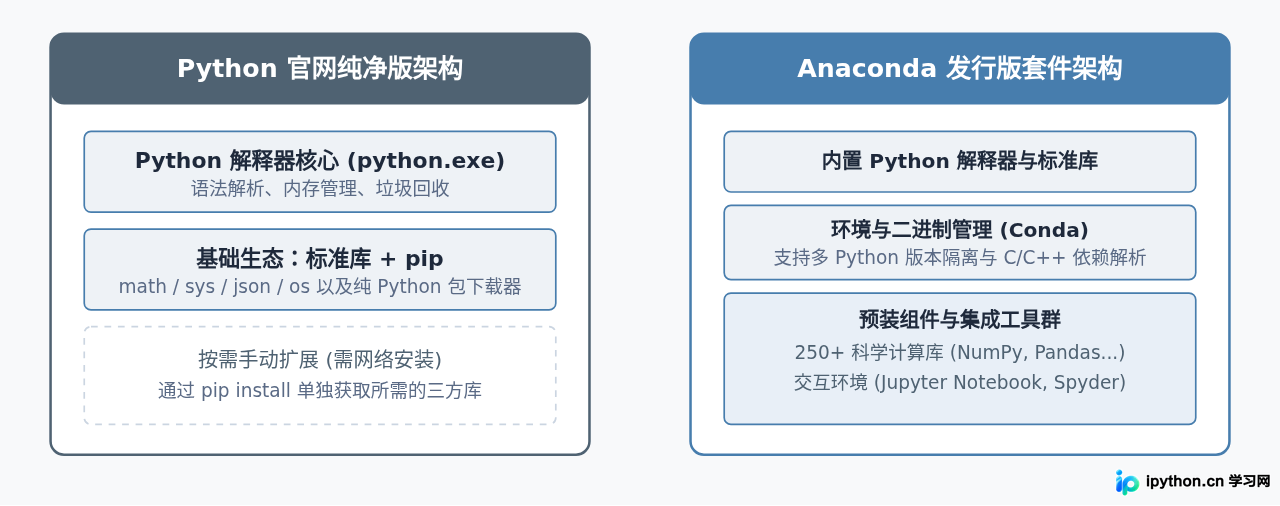
全面对比Python官方纯净版与Anaconda发行版的区别,从核心构成、包管理机制到磁盘占用,并为不同学习路线的新手提供具体的选择标准与安装验证步骤。
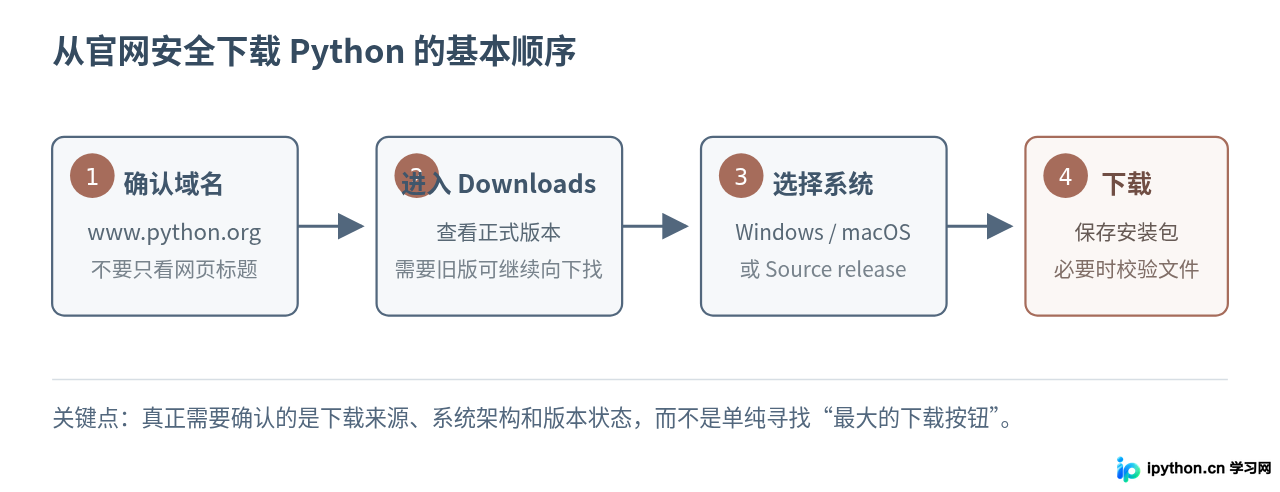
介绍Python官方下载地址,以及Windows、macOS和源码安装包的正确选择方法,并讲解如何通过官网域名、SHA-256和Sigstore确认Python安装包来源与完整性。
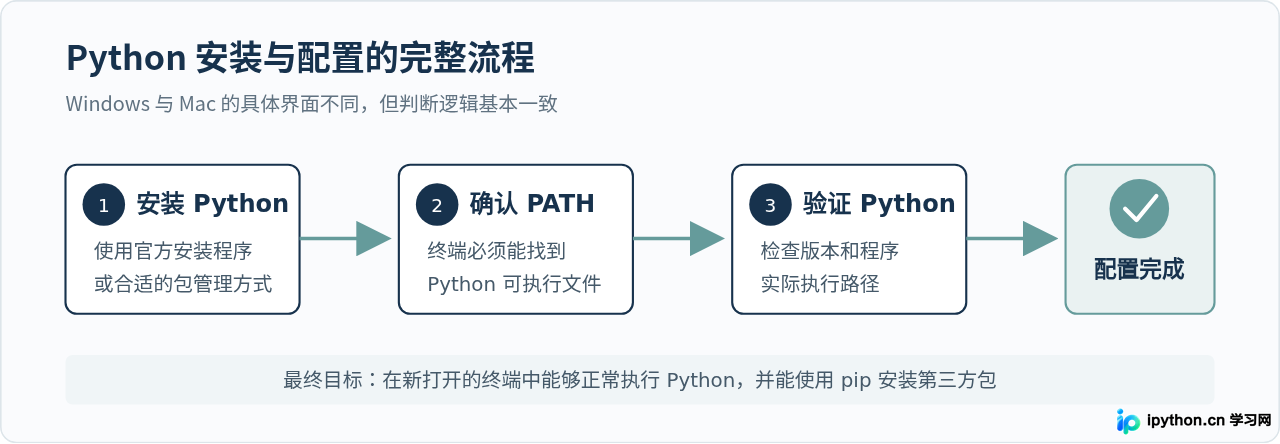
介绍新手如何在Windows和Mac上安装Python并配置环境变量,包括安装选项、PATH设置、python与pip命令验证,以及常见的命令找不到和多版本问题。
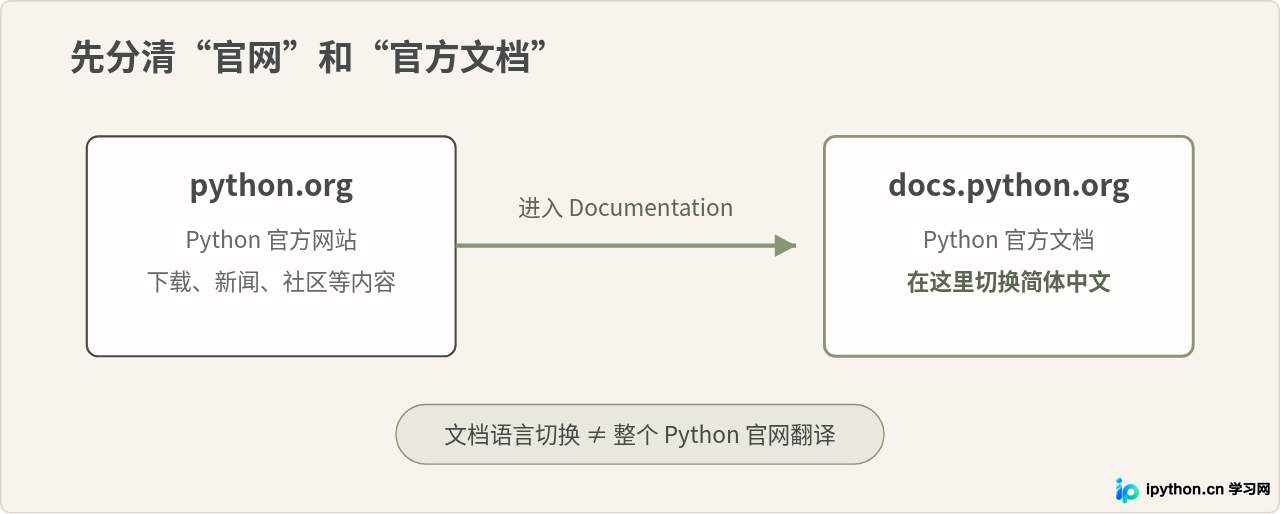
介绍如何从Python英文官方文档切换到简体中文文档,包括语言选择器操作、直接修改zh-cn网址的方法、版本切换区别以及中文页面仍出现英文内容时的处理方法。
介绍Python爬虫可以承接的数据采集、监测、整理和自动化副业,说明公开数据、个人信息、登录数据、版权内容及反爬机制之间的边界,并给出接单前的合规判断流程和风险控制方法。
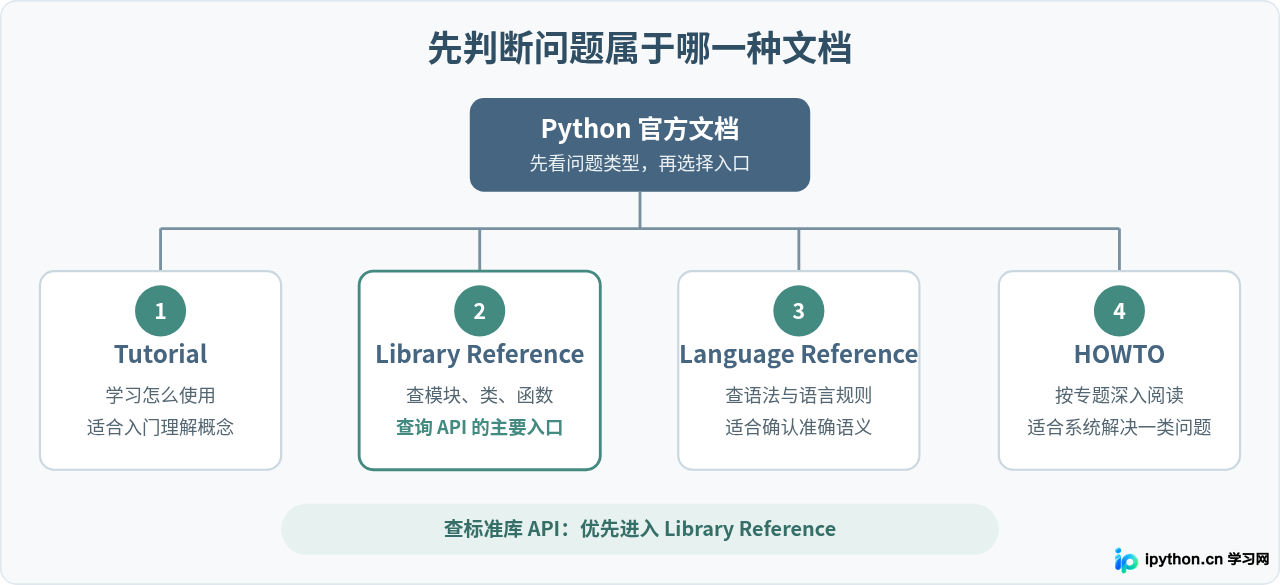
讲解Python官网文档的实用查阅方法,包括如何定位标准库、快速搜索模块和API、阅读函数签名与参数说明、查找示例、版本差异以及常用检索技巧。
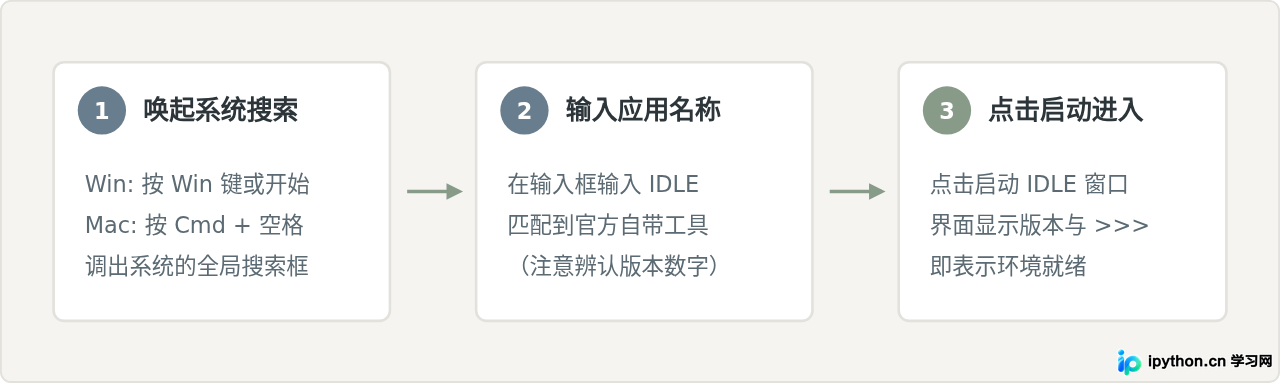
详细讲解Python安装完成后如何打开并使用自带的IDLE编辑器与系统命令行交互环境,包含操作步骤、验证方法及两者的核心差异对比。
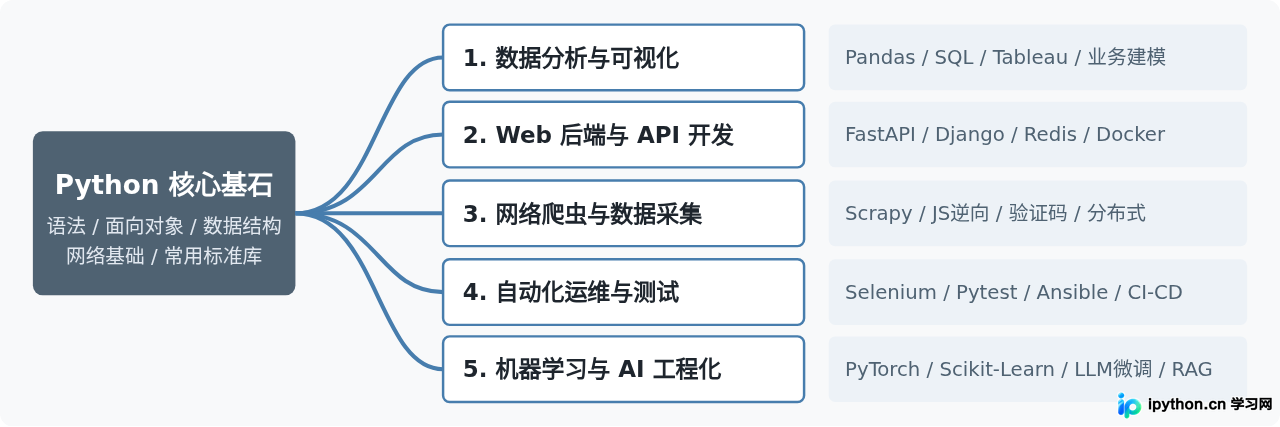
全面解析学完Python后的5大核心就业方向、各岗位技能要求、日常工作场景与主流薪资范围,帮助学习者根据自身条件合理选择职业路径。