

Python官网文档查阅技巧:怎么快速检索标准库与API

查 Python 官网文档时,效率高低往往不取决于读了多少页面,而是能不能快速判断“应该去哪一类文档找”。已经知道模块名,就直接进入标准库参考;知道函数或类名,就搜索完整名称;只知道自己要完成什么任务,则先用关键词找到可能的模块,再进入具体 API 页面核对参数、返回值和版本说明。
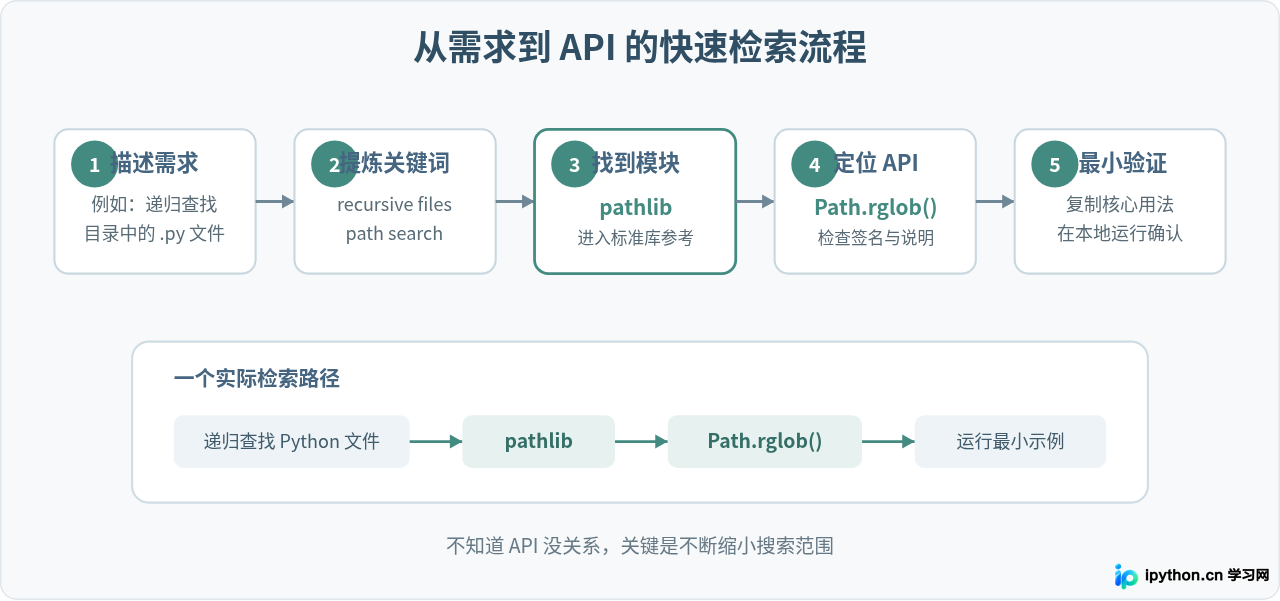
实际使用中,可以把查文档压缩成一条固定路径:确认 Python 版本 → 确定模块或功能关键词 → 定位标准库页面 → 找到具体 API → 阅读签名和参数 → 用最小代码验证。掌握这套方法后,不必从文档首页一层层翻目录。
一、先分清 Python 官网几类文档
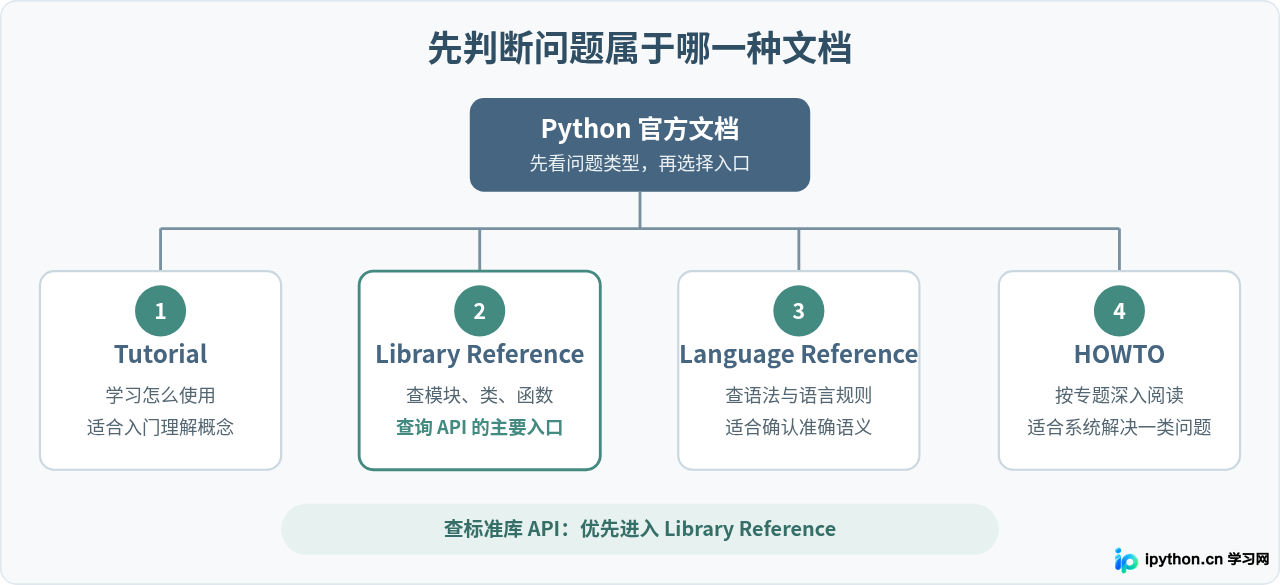
Python 官方文档入口是 docs.python.org/3/。进入文档后会看到教程、标准库、语言参考、HOWTO 等不同内容。它们解决的问题并不一样。
| 文档类型 | 主要解决什么问题 | 典型使用场景 |
|---|---|---|
| Python Tutorial | 学习 Python 的基本使用方式 | 第一次理解列表、函数、类、异常等概念 |
| Library Reference | 查询标准库模块、类、函数和参数 | 查询 pathlib、json、datetime 等 API |
| Language Reference | 解释 Python 语法和语言本身的规则 | 确认表达式、作用域、数据模型、语句的准确语义 |
| HOWTO | 围绕某一具体主题进行较完整的说明 | 正则表达式、日志、描述符等专题学习 |
| Installing Python Modules | 说明 Python 包和模块安装相关知识 | 处理第三方包安装问题 |
如果目标是“这个函数有哪些参数”“这个类怎么创建”“某个标准库模块提供哪些方法”,通常应该直接看 Library Reference,也就是标准库参考,而不是从 Tutorial 开始搜索。
二、查文档前先确认正在使用的 Python 版本
同一个模块在不同 Python 版本中,可能增加参数、增加方法,或者调整部分行为。因此查 API 之前,最好先确认项目运行的 Python 版本。
在终端执行:
python --version某些环境中需要使用:
python3 --version示例输出:
Python 3.x.x这里的 3.x.x 只是示例。应该以自己终端实际返回的版本为准。
官网文档存在不同版本。查到某项 API 后,如果发现自己的程序提示“没有这个参数”或者“没有这个属性”,第一件事就应该检查:当前看的文档版本是不是和运行环境一致。
三、已经知道模块名:直接查标准库参考
这是最简单也最常见的情况。例如已经知道需要处理 JSON,想确认 json.dumps() 有哪些参数,就不需要搜索“Python怎么把字典转JSON”,直接围绕模块名和 API 名查询即可。
标准库页面通常采用这样的组织关系:
模块
├── 模块介绍
├── 函数
├── 类
│   ├── 构造方法
│   ├── 属性
│   └── 方法
├── 常量
└── 使用说明
以 json 为例,可以直接访问标准库中的 JSON 页面,然后在浏览器中使用 Command + F(macOS)或者 Ctrl + F(Windows/Linux),输入:
json.dumps这样比在长页面中向下滚动快得多。
类似地,如果需要操作路径:
pathlib Path需要日期时间:
datetime datetime需要随机数:
random randint关键词尽量包含模块名 + 类名或函数名,比单独搜索 open、find、read 这类通用单词更准确。
四、不知道模块名:从“功能关键词”反推标准库
实际开发中,更常见的情况是知道自己想做什么,却不知道对应哪个模块。例如:
- 遍历目录里的所有
.txt文件; - 解析 JSON;
- 创建临时文件;
- 生成 UUID;
- 执行子进程;
- 读取 CSV 文件。
这时不要一开始就在大量 API 页面里翻。可以先把需求压缩成几个明确的英文技术关键词,再寻找可能的标准库模块。
例如要“递归查找目录中的 Python 文件”,可以围绕:
Python docs recursive file search pathlib当发现 pathlib 后,再把搜索范围缩小:
pathlib Path.rglob查询过程由“我要做什么”变成“哪个模块负责”,再变成“具体哪个 API”。这比一直围绕自然语言问题搜索更容易进入官方文档。
五、一个完整示例:怎么查 Path.rglob()
假设需求是:
查找某个目录以及所有子目录中的 Python 文件。
已经知道 pathlib 适合处理路径,但不确定具体使用哪个方法,可以按下面的顺序查询。
1. 进入 pathlib 标准库页面
可以从 Python 标准库目录进入,也可以直接搜索:
Python docs pathlib判断搜索结果时,优先确认域名是否属于:
docs.python.org2. 在页面内搜索关键词
进入 pathlib 文档后,按下浏览器页面搜索快捷键,输入:
rglob比从头阅读整个 pathlib 页面更直接。
3. 阅读 API 描述
找到 Path.rglob() 后,不要看到函数名符合需求就立即复制代码。至少确认三件事:
- 它属于哪个类;
- 调用时需要传入什么参数;
- 它返回的是什么类型或什么形式的结果。
4. 写一个最小示例验证理解
例如可以建立这样的测试代码:
from pathlib import Path

root = Path("./project")

for file_path in root.rglob("*.py"):
print(file_path)这个例子只验证一个问题:rglob() 是否能够按照模式递归查找文件。先把核心 API 验证清楚,再放入复杂项目,排查问题会容易很多。
如果运行目录中存在类似:
project/
├── main.py
├── utils.py
└── tools/
    └── build.py
示例输出可能类似:
project/main.py
project/utils.py
project/tools/build.py
输出顺序可能受目录内容和环境影响,因此这里重点看是否找到了符合条件的文件,而不是依赖示例中的固定顺序。
六、看到 API 页面后,应该重点读哪些内容
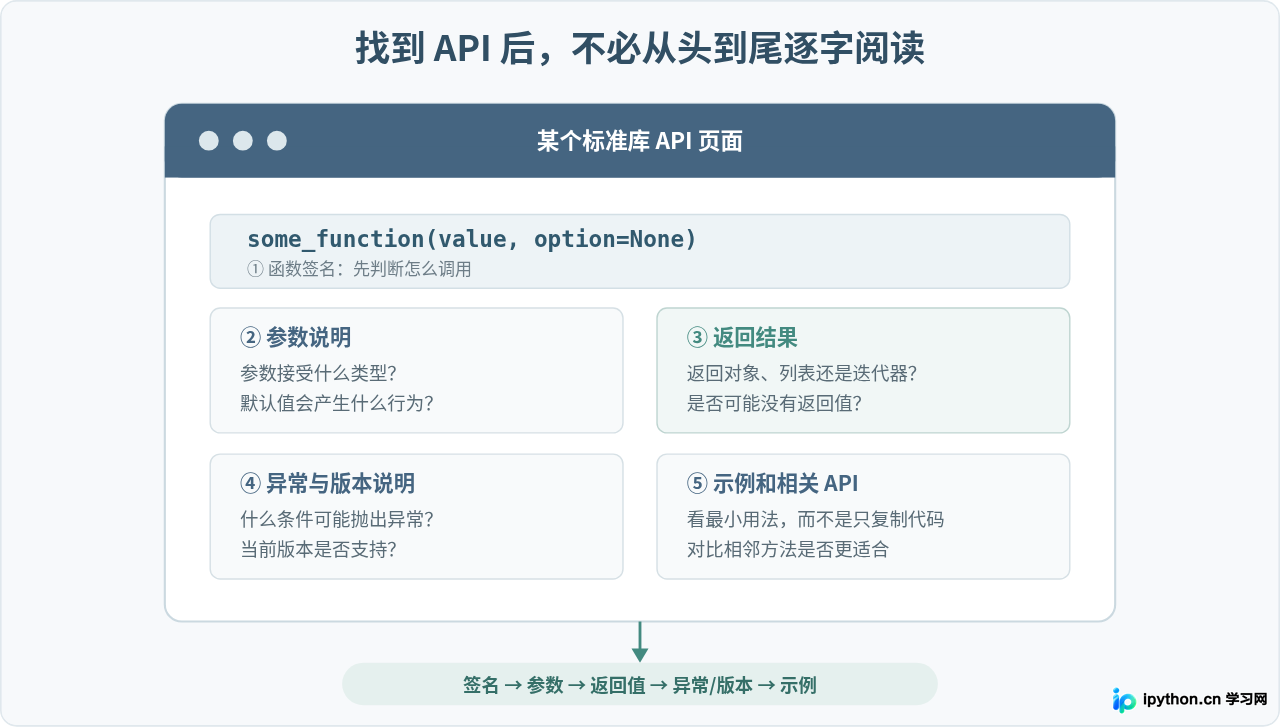
很多人查文档慢,并不是找不到页面,而是进入页面以后不知道看哪里。一个 API 的文档通常不需要每个字都读,建议按照下面的优先级检查。
1. 先看函数或方法签名
函数签名能最快告诉你:
- 有哪些参数;
- 哪些参数有默认值;
- 哪些参数是可选的;
- 是否存在仅限关键字传递的参数;
- 它属于函数、类还是某个对象的方法。
例如看到类似结构:
some_function(value, option=None)至少可以判断 value 是需要关注的主要参数,而 option 存在默认值。
具体含义仍应继续读下面的参数说明,不要仅凭参数名字猜测。
2. 看参数到底接受什么
比如一个参数叫 path,并不一定只接受字符串;某些 API 也可能接受路径对象。一个参数叫 data,也不能凭名字判断它支持哪些数据类型。
官方文档的价值就在这里:它给的是接口约定,而不仅是一个“能够跑起来”的代码片段。
3. 确认返回值
尤其要区分下面这些情况:
- 直接返回列表;
- 返回迭代器;
- 返回新的对象;
- 原地修改对象而没有你预期的返回数据;
- 执行操作后通过异常报告失败。
如果没有确认返回值,代码中很容易出现“明明函数调用成功,为什么变量是 None”之类的问题。
4. 注意异常、版本变化和弃用信息
当页面中出现版本新增、版本变化或者弃用说明时,需要特别留意,因为它们直接影响代码能否在目标 Python 环境中运行。
七、优先搜索完整 API 名称,而不是模糊问题
当已经知道 API 名称以后,搜索应该尽可能精确。
例如想查询 JSON 序列化参数,与其搜索:
Python JSON怎么转字符串不如直接搜索:
json.dumps Python docs如果只希望看 Python 官网,还可以使用搜索引擎常见的站点限定语法:
site:docs.python.org json.dumps查询 datetime.strptime():
site:docs.python.org datetime.strptime查询 subprocess.run():
site:docs.python.org subprocess.run这种方法的优势是可以绕过大量博客、问答页和第三方教程,直接进入官方定义。
如果搜索结果很多,可以继续加入更具体的关键词。例如:
site:docs.python.org pathlib Path.glob pattern原则很简单:掌握的信息越多,搜索词就越接近完整 API 名称。
八、在长文档中使用页面内搜索
标准库的一些页面内容很多,一个模块可能包含几十个函数、类和方法。进入正确页面以后继续使用网页搜索引擎,反而可能让搜索范围再次扩大。
此时更适合直接使用浏览器的页面内查找:
- macOS:
Command + F - Windows/Linux:通常使用
Ctrl + F
搜索时优先输入:
- 完整函数名,如
json.loads; - 方法名,如
read_text; - 关键参数名,如
encoding; - 异常名,如
JSONDecodeError。
例如已经进入 pathlib 文档,但想知道如何读取文本文件,可以直接搜索:
read_text这通常比从 Path 类的第一项方法开始向下翻快得多。
九、善用模块目录和总索引
如果连模块名都想不起来,Python 文档中的模块索引和总索引会很有用。
模块索引适合回答:
“Python 标准库里是不是有一个叫 tempfile 的模块?”
总索引则更适合从名称反查函数、类、术语和方法。
例如你只记得某个 API 名称里有 Temporary,却不记得属于什么模块,索引比从标准库目录一页页查更有效率。
这种方式特别适合已经使用过某个 API,但一时忘记完整路径的情况。
十、标准库、内置函数和对象方法不要混在一起找
查询时还有一个常见问题:把所有 Python 功能都当成“某个标准库模块中的函数”。实际上它们可能属于不同位置。
例如:
| 代码 | 类型 | 更适合在哪里查 |
|---|---|---|
len() |
内置函数 | Built-in Functions |
str.split() |
字符串对象的方法 | Text Sequence Type / str |
list.append() |
列表对象的方法 | Sequence Types / list 相关说明 |
json.loads() |
标准库模块函数 | json 标准库页面 |
Path.read_text() |
标准库类的方法 | pathlib / Path |
例如 len() 不需要:
import len因为它是 Python 内置函数。
而 json.loads() 属于标准库模块,需要:
import json

data = json.loads('{"name": "Python"}')
print(data)
分清 API 属于哪一种类型,可以大幅缩小查找范围。
十一、看到示例代码时,不要跳过参数说明
官方文档中的示例很有价值,但示例的作用通常是说明典型用法,不代表覆盖所有边界条件。
例如看到:
json.dumps(data)并不能据此推断 json.dumps() 只有一个参数。真正开发时,你可能还关心中文输出、缩进、排序或自定义编码行为。这时应该回到函数签名和参数说明,而不是不断寻找更多博客示例。
查 API 时可以把:
示例代码看成“这个 API 怎么开始使用”,把:
函数签名 + 参数说明看成“这个 API 实际允许你怎么使用”。
两者作用不同。
十二、遇到看不懂的参数,继续追踪关联类型
官方文档经常会引用其他概念。例如某个函数参数要求的是“file object”“path-like object”“iterable”或者其他协议类型。
如果不知道这些词意味着什么,不要直接猜。可以继续点击相关术语或搜索对应概念。
比如文档表示参数接受一个 path-like object,那么你真正需要理解的问题可能已经从:
这个函数怎么用?变成:
Python 中什么对象属于 path-like object?这样继续追踪,能解决很多“字符串明明能传,为什么 Path 对象也能传”的疑问。
十三、文档太抽象时,用 help() 在本地快速确认
官网文档应该作为主要依据,但在写代码过程中,有时只需要立即确认对象有哪些方法、函数签名是什么。这时可以配合 Python 自带的 help()。
例如:
import json

help(json.dumps)
或者:
from pathlib import Path

help(Path.read_text)
help() 的优势是可以直接针对当前 Python 环境查看帮助内容。如果官网页面和本地行为看起来不一致,也可以借此检查是不是版本差异。
不过 help() 更适合快速确认,不适合完全替代官网文档。涉及较完整的参数解释、相关 API、版本变化和专题说明时,官网页面通常更方便。
十四、用 dir() 找“这个对象到底有什么方法”
如果已经拿到一个对象,但不确定它有哪些属性或方法,可以使用 dir() 辅助定位。
例如:
from pathlib import Path

p = Path(".")
print(dir(p))
示例输出会包含大量名称,例如:
...
'exists'
'glob'
'is_dir'
'is_file'
'iterdir'
'read_text'
'rglob'
'write_text'
...
这时候如果看到一个可能有用的 read_text,就可以继续查:
Path.read_text Python docsdir() 适合发现名称,官方文档负责确认具体语义。不要仅根据方法名猜测行为。
十五、不要把第三方库文档当成 Python 标准库文档
Python 项目中使用的库不一定属于 Python 标准库。例如一个包需要通过项目依赖另外安装,那么通常应该查看这个项目自己的官方文档,而不是在 Python 标准库目录里找。
判断时可以先问自己:
这个功能是否需要额外安装包?
如果代码中依赖:
pip install some-package那么通常应该查对应项目的官方文档。
而像下面这些模块属于 Python 自带标准库的一部分:
json
pathlib
datetime
random
subprocess
sqlite3
csv
re
logging
它们通常可以直接从 Python 标准库参考中查询。
十六、遇到报错时,应该怎么结合官方文档排查
如果代码已经报错,查询方式也应该变化。此时应该从“我要找什么 API”转成“哪个调用条件不符合文档要求”。
例如:
TypeError: ...不要只把完整报错复制到搜索引擎中。先回到对应 API 页面检查:
- 传入参数数量是否正确;
- 参数类型是否符合要求;
- 是不是把关键字参数写错;
- 当前 Python 版本是否支持该参数;
- 调用的是类方法、实例方法还是普通函数。
如果是:
AttributeError则重点确认:
- 这个方法是否真的属于当前对象;
- 方法名称有没有拼写错误;
- 该方法是不是较新 Python 版本才加入;
- 变量实际类型是不是自己认为的类型。
很多问题都可以通过“报错位置 → 对应 API → 对照文档调用约定”直接定位,不必搜索大量相似报错案例。
十七、建立一套固定的文档检索习惯
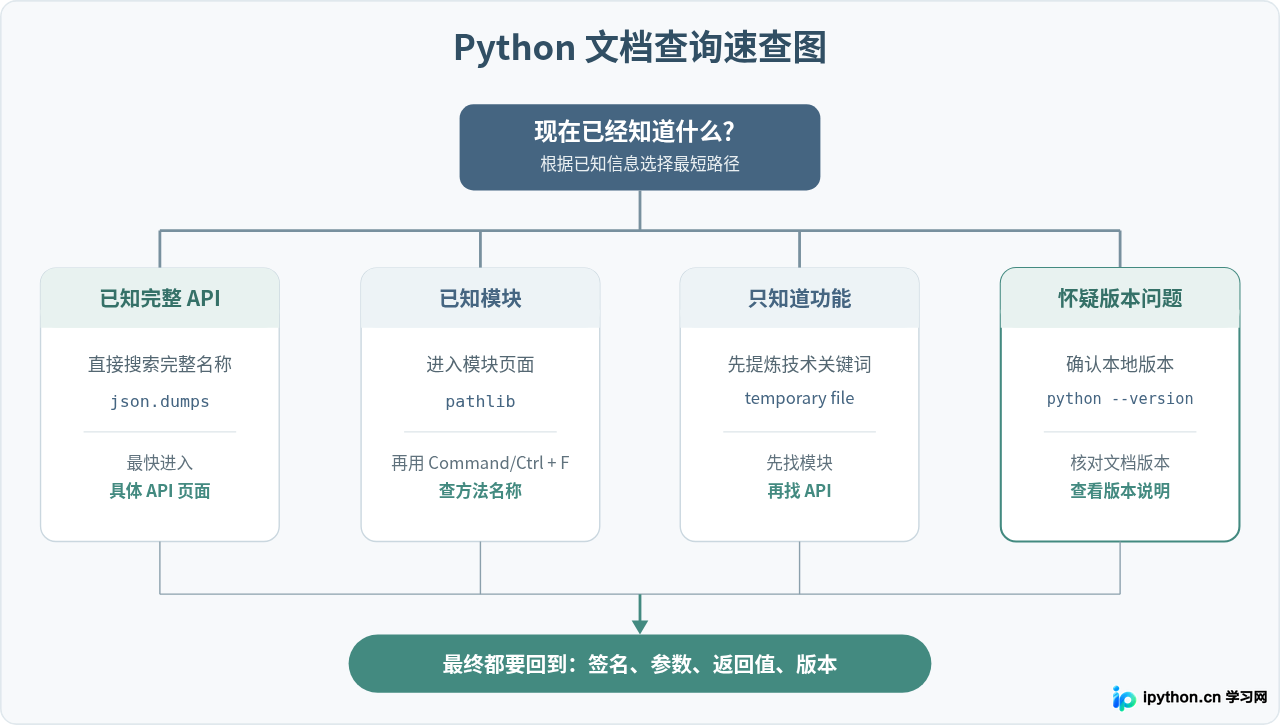
如果经常写 Python,可以把下面几种搜索方式固定下来。
场景一:知道完整 API 名称
site:docs.python.org json.dumps场景二:知道模块,不知道方法
Python docs pathlib recursive files进入模块页面以后,再用页面内搜索缩小范围。
场景三:只知道需求
Python standard library temporary file先找到可能的 tempfile 模块,再查具体 API。
场景四:只记得方法名称
site:docs.python.org "read_text"场景五:怀疑版本不兼容
确认本地:
python --version然后核对当前阅读的 Python 文档版本,以及 API 页面中的版本变化说明。
十八、一个更高效的实际查阅流程
把前面的技巧组合起来,一次完整的文档查询可以控制在很清晰的几个动作中。
假设现在要解决:
“Python 如何读取一个 UTF-8 文本文件?”
可以这样处理。
第 1 步:先判断是否知道相关对象
如果已经知道 pathlib.Path,直接围绕:
Path read text Python docs搜索。
第 2 步:进入官方 pathlib 页面
确认结果来自 docs.python.org,然后在页面内搜索:
read_text第 3 步:阅读方法签名和 encoding 参数
重点确定编码参数应该在哪里传递,而不是只看一个没有指定编码的示例。
第 4 步:建立最小验证代码
from pathlib import Path

file_path = Path("example.txt")

content = file_path.read_text(encoding="utf-8")
print(content)
这段代码只验证读取 UTF-8 文本这个核心需求。
第 5 步:再扩展到项目代码
确认 API 行为后,再加入路径判断、异常处理、业务逻辑等内容,而不是第一次测试就写成几十行代码。
这种习惯最大的价值不是少打几个字,而是把“搜索问题”和“调试代码”分开。你可以明确知道:现在是在确认 API,还是在处理自己的业务逻辑。
十九、几个容易降低查文档效率的做法
只搜索中文自然语言问题
中文搜索当然可以使用,但如果已经知道模块或函数名称,继续搜索“Python怎么……”通常会得到大量二手解释。
已经知道 json.loads() 时,直接查这个名称更快。
只看代码示例,不看接口说明
示例能够告诉你一种用法,却不一定告诉你全部参数和限制。出现编码、默认值、异常处理、版本兼容问题时,必须回到 API 定义。
忽略文档版本
网上找到一个合法的 API,不代表当前运行环境一定支持。尤其当代码提示未知参数或不存在的方法时,要优先排除版本差异。
在错误的文档分类里长时间查找
查 json.dumps() 的参数,却一直在 Tutorial 中寻找;或者想弄清 Python 对象模型的规则,却只看标准库列表,都会浪费时间。
先判断是“怎么学”“怎么调用”还是“语言规则是什么”,查询会快很多。
二十、把官网文档当成API说明书,而不是教材从头读
查标准库时,没有必要每次都把一个模块的完整页面读完。更实际的方式是带着明确问题进入文档。
例如要使用 json.dumps(),需要确认的是:
- 输入什么对象;
- 需要哪个参数;
- 返回什么;
- 中文、格式化等需求怎么配置;
- 当前 Python 版本是否支持目标用法。
这些问题确认以后就可以开始写代码。等需要新的功能,再回到文档继续查。
可以记住这样一套最短流程:
不知道模块时,先用功能关键词找到模块;知道模块后进入标准库参考;知道 API 名称后直接搜索完整名称;进入页面先看签名、参数和返回值;遇到不兼容时检查 Python 与文档版本;最后用最小代码验证自己的理解。
熟悉以后,查询一个标准库 API 往往不再是“从哪里开始看文档”的问题,而只是确定自己现在掌握了多少信息,然后选择最短的检索路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









