

Python3多进程multiprocessing模块详解:Process、Pool、Queue与Pipe用法
本文详细介绍Python3中multiprocessing模块的核心组件,包括Process类的创建与同步、Pool进程池的apply_async与apply方法对比、Queue进程间通信的put/get机制及参数设置,以及Pipe双向通信的实现。通过代码示例解析各组件特性与适用场景,帮助开发者高效实现并发编程。
2026-10-13
9

本文详细介绍Python3中multiprocessing模块的核心组件,包括Process类的创建与同步、Pool进程池的apply_async与apply方法对比、Queue进程间通信的put/get机制及参数设置,以及Pipe双向通信的实现。通过代码示例解析各组件特性与适用场景,帮助开发者高效实现并发编程。
本文介绍如何在Anaconda3环境下快速创建并激活独立的Python 2.7虚拟开发环境。通过conda create命令指定版本,结合Linux/Mac的source activate或Windows的activate命令,实现环境隔离,确保库安装不影响主版本,适用于需要兼容旧版Python的项目开发。
本文详细解析Python中continue语句的用法。通过对比break退出循环,说明如何利用continue跳过特定条件下的后续代码并进入下一次迭代。文章包含计算及格平均分及奇数求和的具体代码示例,帮助开发者掌握循环控制的高级技巧。
本文详细介绍如何在Python中利用MongoDB进行模糊查询。通过结合re模块与[[wp:a4]]函数,演示了如何对集合中的特定字段进行包含匹配。文章提供了完整的代码示例和结果分析,帮助开发者掌握Python操作MongoDB数据库的核心技巧,适用于需要灵活检索数据的场景。
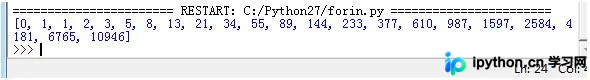
本文介绍Python 2.7中如何使用for循环遍历range函数来计算斐波那契数列。通过初始化列表并循环20次,利用append方法在列表末尾添加前两项之和,最终输出包含22个元素的数列。文章还解析了变量i的作用及列表逆向索引技巧,适合Python初学者参考。
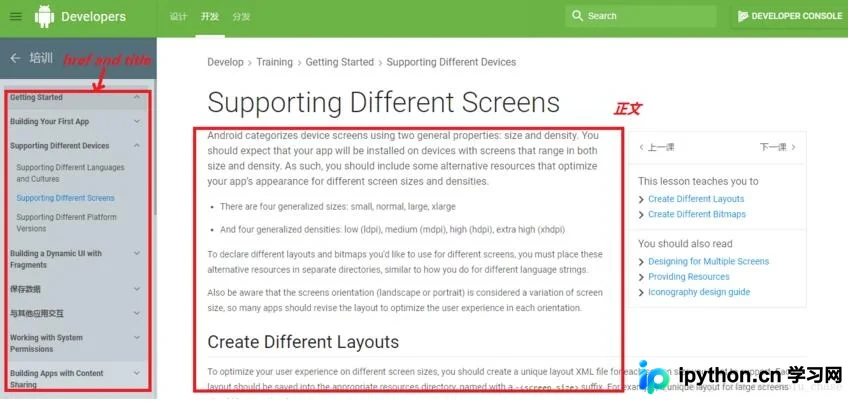
本文介绍如何利用Python编写爬虫程序,从指定网页提取标题、正文及导航链接,并通过BeautifulSoup解析HTML。结合Requests库获取内容,使用wkhtmltopdf工具将生成的HTML文件转换为PDF格式,实现离线阅读与记忆。
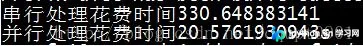
本文介绍利用Python multiprocessing模块的Pool进程池,结合jieba库对海量文本进行高效关键词提取的方法。通过对比单进程与多进程处理581行、7MB语料的耗时,验证了多进程异步处理的性能优势,并指出移除模拟延迟可显著缩短运行时间,为大规模文本分析提供实用参考。
本文详解如何利用Python的open函数进行文件读写,结合os模块遍历目录,并通过正则表达式re模块从多个文本文件中精准提取指定数据。文章提供了完整的代码示例,演示如何去除换行符、匹配模式并将结果写入新文件,适合需要批量处理文本数据的开发者参考。
本文提供了使用Python和Shell语言读取文本文件内容的具体实现代码。Python部分演示了以只读模式打开文件、读取全部内容并关闭句柄的标准流程;Shell部分展示了通过while循环逐行读取指定路径文件内容的方法。代码简洁实用,适合需要快速处理文本数据的开发者参考。
本文介绍Numpy中将数组数据保存为文本文件的方法。通过savetxt函数可将数组写入txt,利用loadtxt函数重新加载。示例展示了从生成随机数组、保存为data.txt到读取并验证数据一致性的完整流程,适用于需要后期灵活处理数据的场景。
本文详细解析Python中NumPy数组shape属性为(2,)与(2,1)的区别。通过示例展示一维数组与二维数组在形状表示上的差异,帮助开发者理解数组维度对数据处理的影响。
本文深入解析Python中求最长回文子串的算法演进。从时间复杂度为O(N^2)的暴力枚举出发,介绍中心扩展法的优化思路,最终重点讲解Manacher算法。该算法利用回文对称性将时间复杂度优化至O(N),并通过1000字符纯'a'字符串的实测数据,展示Manacher算法在耗时上相比暴力法(49.7s)和中心扩展法(0.33s)的显著优势,耗时仅0.008s。