

TensorFlow基于MNIST数据集的车牌识别演示:原理与实现
本文演示如何利用TensorFlow和MNIST手写数字数据集实现车牌识别。尽管MNIST仅含数字,通过筛选工整样本并配合OpenCV预处理,可初步识别车牌中的数字部分。文章提供了核心代码逻辑、实验结果分析及后续完善方向的指引,适合图像处理与机器学习初学者参考。
2026-10-13
9

本文演示如何利用TensorFlow和MNIST手写数字数据集实现车牌识别。尽管MNIST仅含数字,通过筛选工整样本并配合OpenCV预处理,可初步识别车牌中的数字部分。文章提供了核心代码逻辑、实验结果分析及后续完善方向的指引,适合图像处理与机器学习初学者参考。
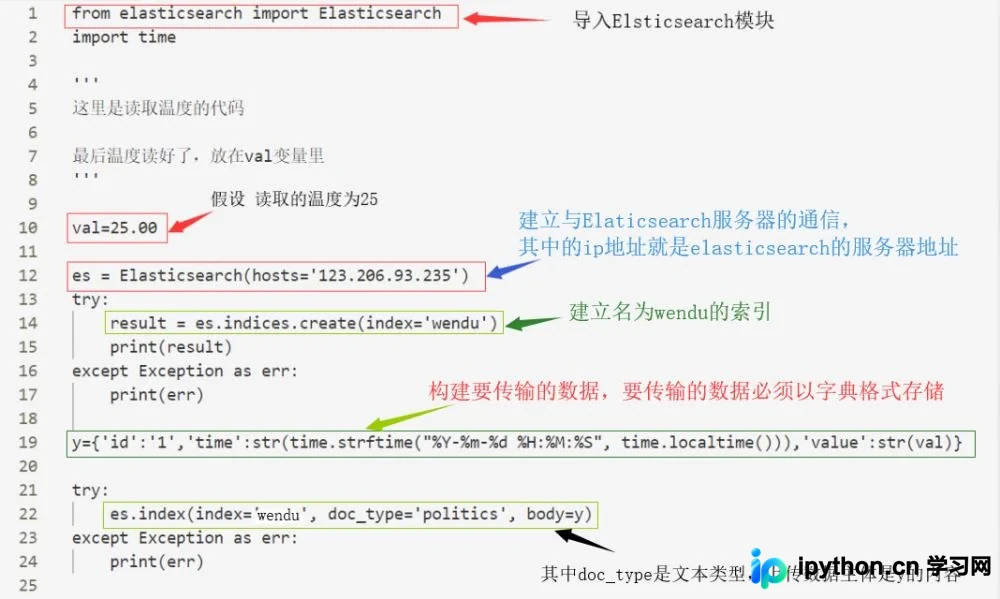
本文介绍如何使用Python脚本连接Elasticsearch,完成索引建立及数据上传。通过具体代码示例,展示利用elasticsearch库进行索引创建、文档写入以及使用match_all和get方法进行数据检索的完整流程,帮助开发者快速掌握ES基础操作。
本文深入解析Flask框架中的重定向与错误处理机制。详细讲解[[wp:a0]]方法的参数与默认状态码,并通过登录示例演示如何结合[[wp:a3]]实现页面跳转。同时介绍[[wp:a5]]方法,通过替换重定向代码为[[wp:a8]],展示如何返回401未授权错误,帮助开发者完善Web应用的路由与异常处理逻辑。
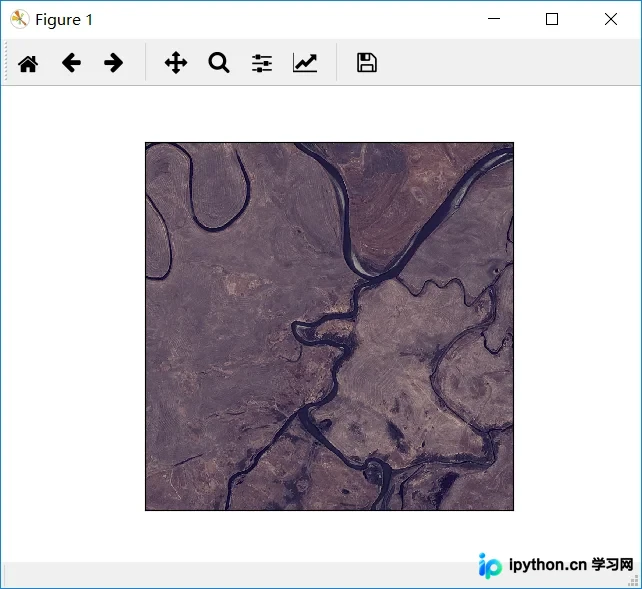
本文详细介绍 Python 中 GDAL 库的两种安装方式,包括下载 Wheel 文件及使用 Conda/Pip 指定版本安装,并演示如何读取 GeoTIFF 栅格数据、提取波段信息并合并显示为图像。
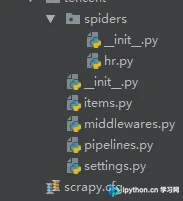
本文详细演示如何使用Scrapy框架创建爬虫项目,定义Items数据结构,编写Spider解析网页HTML并提取职位信息,最后通过Pipeline将数据持久化存储到MongoDB数据库中。涵盖从项目初始化、代码编写到数据落地的完整流程,适合初学者快速掌握Scrapy核心用法。
本文详解Python爬虫中模拟登录人人网的两种核心方法。首先介绍使用requests.Session()类自动维持会话状态,通过POST提交表单数据实现登录并抓取个人主页;其次演示如何手动提取并传递Cookie,分别通过Headers和Cookies参数访问受限页面。代码包含完整登录流程与本地保存逻辑,适用于学习爬虫会话保持机制。
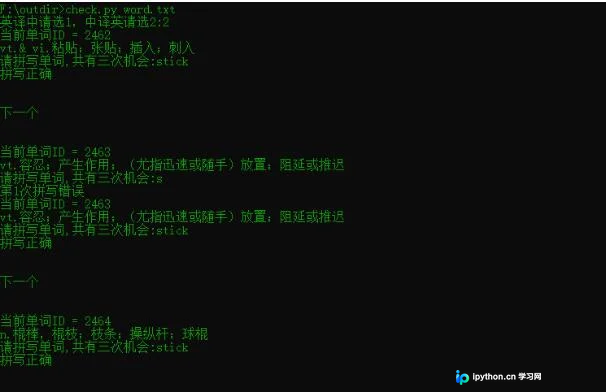
本文介绍使用Python构建个人单词词库的方法。通过爬取COCA两万单词表,利用requests和BeautifulSoup获取金山词霸的词性、释义及音频链接,并存储至SQLite数据库。程序支持自定义测试模式,包括中译英拼写与英译中选择释义,旨在提供灵活的背单词解决方案。
本文详解如何使用Python编写有道在线翻译小程序。针对有道反爬机制,重点讲解User-Agent伪装、Referer设置及data参数构造(含salt与sign生成)。提供完整Python代码,涵盖urllib、json、time及hashlib模块的应用,并分析运行结果,帮助开发者解决旧版教程失效问题。
本文详细解析 Django 中 models.py 的编写规范,涵盖常用字段类型及其在 Admin 后台的限制。重点讲解 makemigrations 与 migrate 命令的区别、作用范围及针对特定 App 的操作方法。针对 No migrations to apply 报错,提供清理迁移文件与 django_migrations 表的完整修复步骤,并附带 MySQL 配置示例。
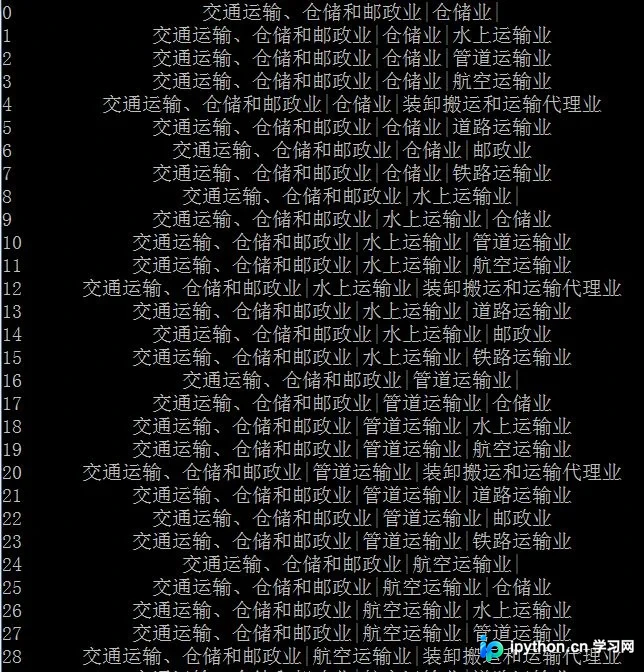
本文详解在pandas中如何使用str.split方法对包含分隔符的字符串列进行分割。重点解析expand参数的作用:设为True时可自动将分割结果展开为多列,设为False则保持单列。通过具体代码示例展示如何提取特定分割后的子列,适用于行业分类等数据的标准化处理。
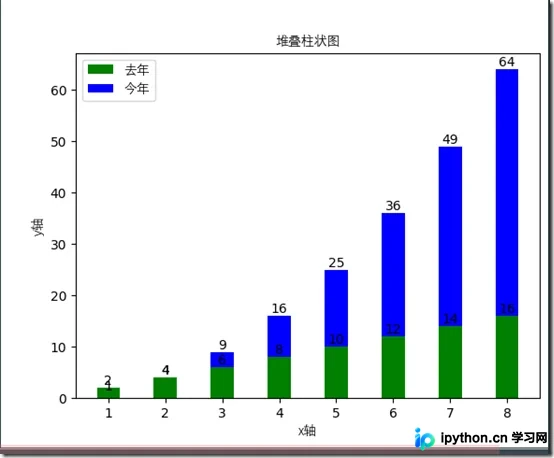
本文详细讲解如何在Python中使用Matplotlib库绘制堆叠柱状图。通过定义字体防止中文乱码,利用plt.bar函数分层绘制数据,并设置颜色、宽度及图例。代码示例展示了如何生成数据、绘制条形、添加数值标注及显示最终图表,适用于对比两组数据的场景。
本文详解Python中numpy和pandas计算标准差的区别。默认情况下,numpy.std()使用有偏估计(除以n),而pandas.std()使用无偏估计(除以n-1)。通过调整ddof参数,可实现两种算法的互换。文章指出ddof=1为无偏估计的关键,并提醒在scikit-learn等库中手动设置该参数的重要性,尤其在数据量较小时需特别注意。