pandas创建DataFrame的7种方法小结
本文总结了在pandas库中创建DataFrame的七种常用方法,包括利用Python字典、指定列与索引、读取Excel/CSV文件、使用NumPy数组、合并元组以及基于Series生成数据。文章提供了相应的代码示例与注意事项,如读取Excel需安装xlrd包,旨在帮助开发者快速掌握数据框的构建技巧。
2026-10-14
20

本文总结了在pandas库中创建DataFrame的七种常用方法,包括利用Python字典、指定列与索引、读取Excel/CSV文件、使用NumPy数组、合并元组以及基于Series生成数据。文章提供了相应的代码示例与注意事项,如读取Excel需安装xlrd包,旨在帮助开发者快速掌握数据框的构建技巧。
本文深入解析TensorFlow中tf.gradients()与tf.stop_gradient()的核心机制。tf.gradients()用于计算目标函数对变量的导数,支持自定义梯度更新;tf.stop_gradient()则用于阻断特定节点的梯度反向传播。通过代码示例展示如何在模型训练中实现前向与反向传播的解耦,以及利用stop_gradient构造自定义梯度更新策略。
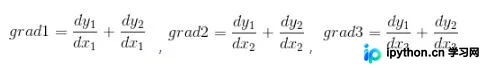
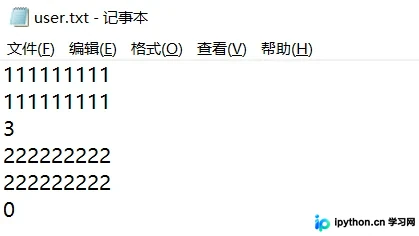
本文通过Python文件读写操作,实现一个完整的用户登录模拟系统。核心功能包括:验证账号是否存在、检查账户是否因多次错误被锁定(超过三次)、校验密码正确性,并在登录成功时重置错误计数。系统支持密码错误后的重试机制及手动退出,最终将更新后的错误次数写回本地文本文件,确保状态持久化。
本文解决PyCharm在Debug模式下界面下方不显示Step按钮及变量值的问题。通过View菜单添加Debug视图,并利用Move to功能将其移至底部即可恢复。同时指出在多文件项目中应通过入口文件启动Debug以确保断点生效,避免调试区域变灰无法单步执行。

本文详细介绍在PyCharm中进行Debug调试时如何实时查看数据操作。涵盖设置断点、启动Debug模式、使用Step Over/Into单步执行,以及通过Console开启Python Prompt实现交互式变量查看。此外,补充了无需Debug即可通过编辑配置勾选“用控制台运行”来查看变量的方法,帮助开发者更高效地排查代码问题。

本文详细介绍Python标准库configparser模块的使用方法,涵盖配置文件的生成、读取、删除及修改操作。通过具体代码示例,演示如何初始化配置、读写节点与选项、删除指定Section及Option,以及如何保存更改到文件,帮助开发者高效管理应用配置。
本文详细介绍如何使用Python和OpenCV库进行图像的基本操作。涵盖cv2.imread的读取模式与参数、cv2.imshow的窗口显示及键盘绑定机制、cv2.imwrite的文件保存方法,以及解决OpenCV BGR与Matplotlib RGB色彩空间差异的技巧。
本文详解 Python 中引用包的两种主要方式:直接使用 import 包名导入整个模块,以及利用 from 包名 import 类名/函数名进行精准导入。通过 time 模块示例演示具体代码,并深入解析如何依据 __init__.py 文件的存在来区分普通目录与 Python Package,帮助开发者高效管理依赖与提升代码可读性。
本文详细介绍如何使用Python通过hdfs库访问HDFS。涵盖pip安装步骤、核心代码示例(如Client初始化、文件下载),并重点解决WebHDFS服务未开启导致的连接失败问题。通过修改hdfs-site.xml启用dfs.webhdfs.enabled属性,并提供curl检测命令,帮助用户快速排查和配置Hadoop环境。
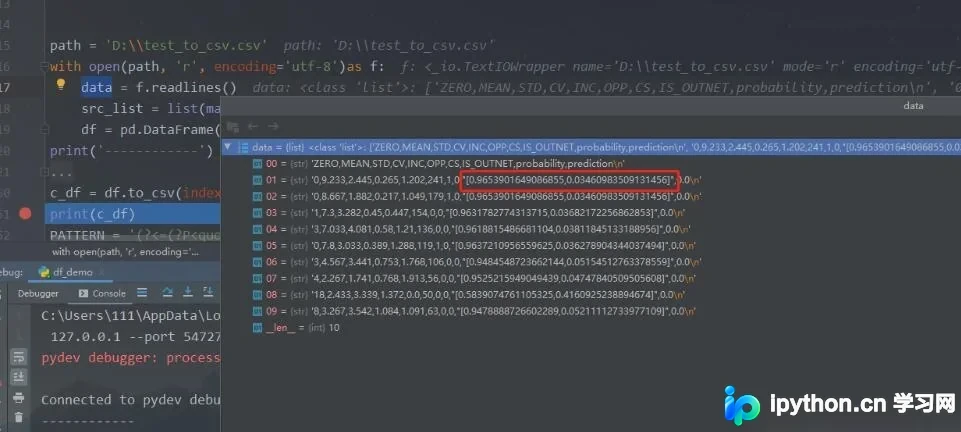
本文介绍如何使用Python的pyhdfs模块连接Hadoop集群,实现HDFS文件的读写与本地文件上传。重点解析在通过Pandas处理包含特殊引号格式的CSV数据时,因正则匹配保留引号导致的转义错误,并提供修正后的正则表达式与处理逻辑,确保数据准确转换。
本文深入探讨Python中函数传参机制,重点分析列表作为参数传入时的引用传递特性,证明修改形参会影响原对象。同时解析字典作为参数的遍历方法,并详细阐述全局变量与局部变量的作用域规则及global关键字的使用场景,帮助开发者避免常见的变量修改陷阱。
本文解决 Flask 程序中指定端口未生效的问题。当代码设置 port=8001 却仍监听 5000 时,需检查 IDE 运行配置。此外,为避免多项目运行时端口冲突或混乱,建议将不同主函数的代码存放于独立文件夹中,确保每次运行环境隔离。