

Python连接HDFS实现文件上传下载及Pandas转换文本文件到CSV操作

本文介绍如何使用Python的pyhdfs模块连接Hadoop集群,实现HDFS文件的读写与本地文件上传。重点解析在通过Pandas处理包含特殊引号格式的CSV数据时,因正则匹配保留引号导致的转义错误,并提供修正后的正则表达式与处理逻辑,确保数据准确转换。
目标与环境准备
1. 目标
利用Hadoop Hive或Spark等数据计算框架完成数据清洗后,将结果存储于HDFS系统中。
在Python环境中,爬虫开发与机器学习算法的实现相对便捷。
然而,在Linux环境下编写Python代码时,缺乏PyCharm等IDE提供的便利支持。
因此,需要建立Python与HDFS之间的读写通道,以支持数据交互。
HDFS连接与文件操作实现
2. 实现
首先安装Python模块pyhdfs。
测试环境版本为Python3.6与Hadoop 2.9。
读取HDFS文件的代码如下:
from pyhdfs import HdfsClient
client=HdfsClient(hosts='ghym:50070')#hdfs地址
res=client.open('/sy.txt')#hdfs文件路径,根目录/
for r in res:
 line=str(r,encoding='utf8')#open后是二进制,str()转换为字符串并转码
 print(line)
写入HDFS文件的代码如下:
from pyhdfs import HdfsClient
client=HdfsClient(hosts='ghym:50070',user_name='hadoop')#只有hadoop用户拥有写权限
str='hello world'
client.create('/py.txt',str)#创建新文件并写入字符串
将本地文件上传至HDFS的操作如下:
from pyhdfs import HdfsClient
client = HdfsClient(hosts='ghym:50070', user_name='hadoop')
client.copy_from_local('d:/pydemo.txt', '/pydemo')#本地文件绝对路径,HDFS目录必须不存在
Pandas处理CSV及引号问题解析
3. 读取文本文件写入CSV
确保Python环境中已安装pandas模块。
需预先确认文本文件使用的分隔符。
# pyhdfs读取文本文件,分隔符为逗号,
from pyhdfs import HdfsClient
client = HdfsClient(hosts='ghym:50070', user_name='hadoop')
inputfile=client.open('/int.txt')
# pandas调用读取方法read_table
import pandas as pd
df=pd.read_table(inputfile,encoding='gbk',sep=',')#参数为源文件,编码,分隔符
# 数据集to_csv方法转换为csv
df.to_csv('demo.csv',encoding='gbk',index=None)#参数为目标文件,编码,是否要索引
补充知识:记录从HDFS读取数据,经Pandas处理再转为CSV过程中遇到的一个典型问题。
工作流程如下:
使用HDFS客户端提供的read方法读取HDFS上的CSV文件,该方法返回一个生成器对象。
将读取到的数据按逗号进行分割,构建为二维数组结构。
将二维数组传入Pandas,生成DataFrame对象df。
对df进行若干处理后,将其转换为CSV文件并写入HDFS。
遇到的问题如下:
正常数据示例:
ZERO,MEAN,STD,CV,INC,OPP,CS,IS_OUTNET
0,9.233,2.445,0.265,1.202,241,1,0
0,8.667,1.882,0.217,1.049,179,1,0
上述三行数据按常规流程处理,未出现异常。
异常数据示例:
ZERO,MEAN,STD,CV,INC,OPP,CS,IS_OUTNET,probability,prediction
0,9.233,2.445,0.265,1.202,241,1,0,'[0.9653901649086855,0.03460983509131456]',0.0
0,8.667,1.882,0.217,1.049,179,1,0,'[0.9653901649086855,0.03460983509131456]',0.0
在每一行数据中,均存在被一对引号包裹的数组型数据,其中的逗号不可随意拆分。
针对此情况,采取的处理措施如下:
使用正则表达式匹配被成对引号包围的字符串。
将匹配到的字符串内部的逗号替换为特定占位符。
将替换后的新字符串重新嵌入原字符串中。
最后,将原字符串中的特定占位符还原为逗号。
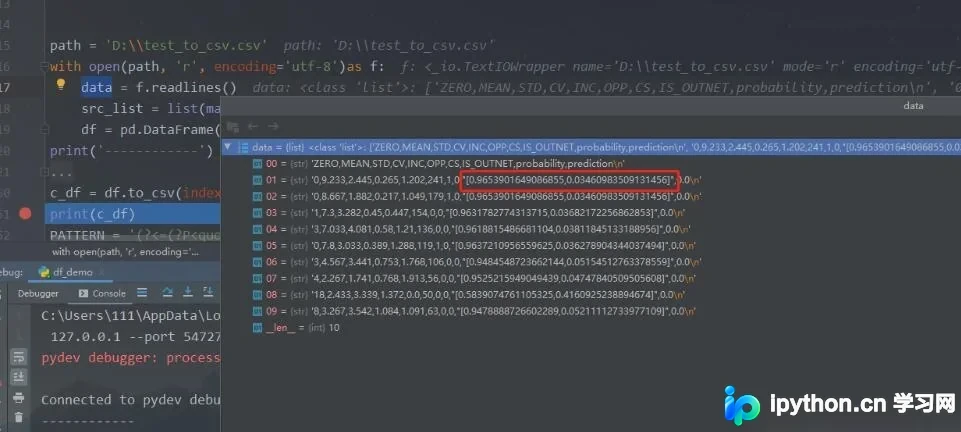
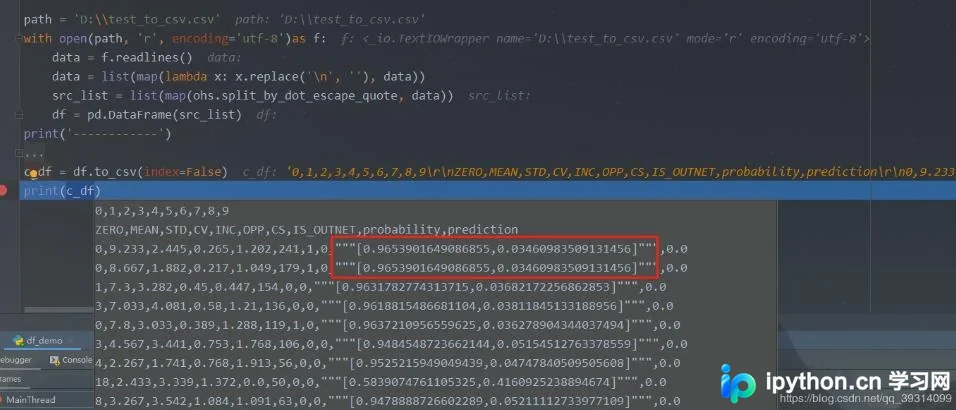
上述逻辑看似合理,但在通过Pandas转换为CSV文件时,发现原本带引号的字符串变成了前后各带三个引号。
源数据示例:
处理后的数据示例:
解决方法如下:
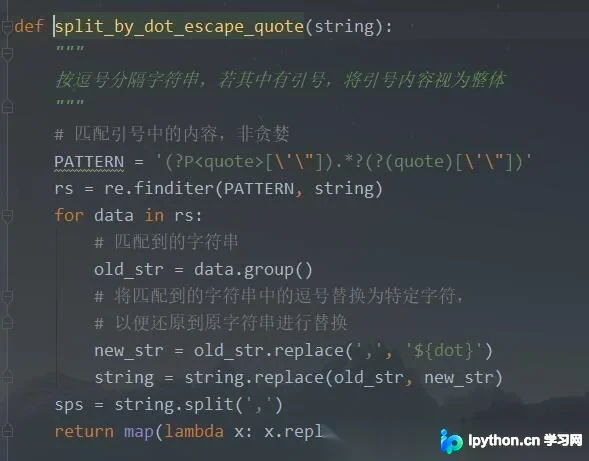
经仔细对比分析,发现数据中的引号仅用于在纯文本文件中标识字符串类型,不应作为实际数据内容保留。
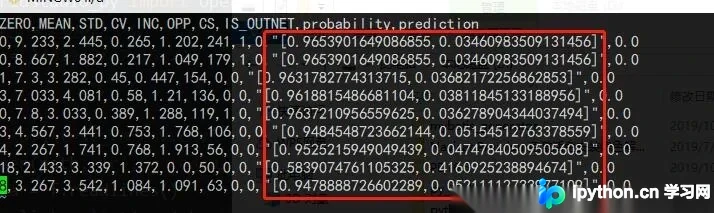
而在之前的处理中,每次匹配后均将原文本原封不动替换回去,例如:
源数据:
"[0.9653901649086855,0.03460983509131456]"
匹配替换后:
"[0.9653901649086855${dot}0.03460983509131456]"
若将此结果传给Pandas,它会识别该数据包含引号,在重新转为CSV时会进行转义处理,导致多出大量引号。
因此,解决方案是在替换前,去除匹配过程中遇到的引号:
PATTERN = '(?<=(?P<quote>[\'\"]))([^,]+,[^,]+)+?(?=(?P=quote))'
中间部分 ([^,]+,[^,]+)+? 必须使用+?,因为需确定存在此类组合,且采用非贪婪模式,故不可使用 ? 或 *?。
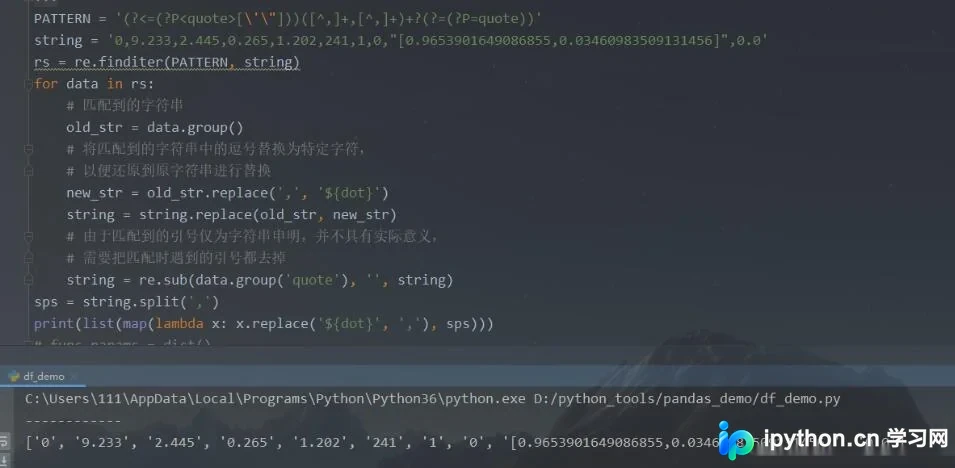
(注:为方便后续引用前面的匹配,在环视匹配中创建了一个组)
整体效果如下:
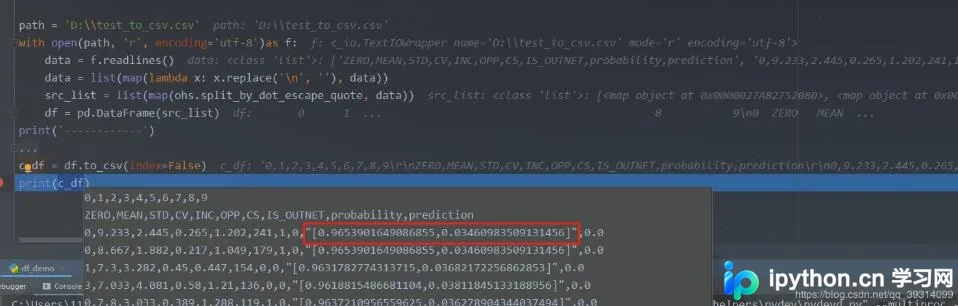
为说明效果,引用Pandas自带的读取CSV方法:
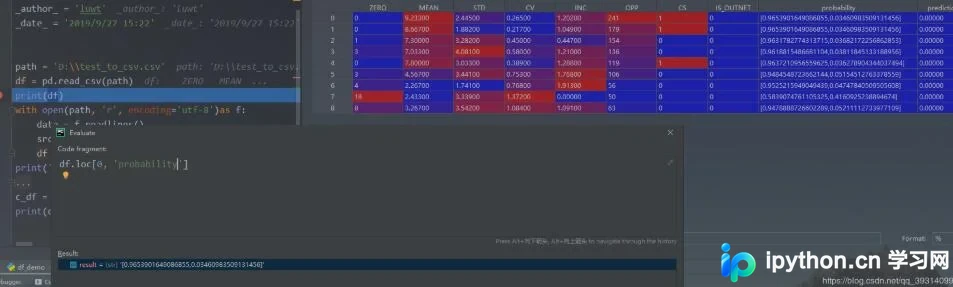
可以看到,Pandas读取出的该位置数据仍为字符串,引号在此处仅作为字符串声明存在。
再次修改正则表达式:
def split_by_dot_escape_quote(string):
  """
  按逗号分隔字符串,若其中有引号,将引号内容视为整体
  """
  # 匹配引号中的内容,非贪婪,采用正向肯定环视,
  # 当左引号(无论单双引)被匹配到,放入组quote,
  # 中间的内容任意,但是要用+?,非贪婪,且至少有一次匹配到字符,
  # 若*?,则匹配0次也可,并不会匹配任意字符(环视只匹配位置不匹配字符),
  # 由于在任意字符后面又限定了前面匹配到的quote,故只会匹配到",
  # +?则会限定前面必有字符被匹配,故"",或引号中任意值都可匹配到
  pattern = re.compile('(?=(?P<quote>[\'\"])).+?(?P=quote)')
  rs = re.finditer(pattern, string)
  for data in rs:
    # 匹配到的字符串
    old_str = data.group()
    # 将匹配到的字符串中的逗号替换为特定字符,
    # 以便还原到原字符串进行替换
    new_str = old_str.replace(',', '${dot}')
    # 由于匹配到的引号仅为字符串申明,并不具有实际意义,
    # 需要把匹配时遇到的引号都去掉,只替换掉当前匹配组的引号
    new_str = re.sub(data.group('quote'), '', new_str)
    string = string.replace(old_str, new_str)
  sps = string.split(',')
  return map(lambda x: x.replace('${dot}', ','), sps)


s = '"2011,603","3510006998","F","5","5","0",""'
print(list(split_by_dot_escape_quote(s)))
运行结果如下:
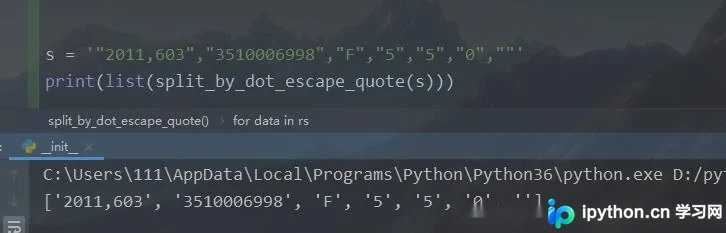
之前的正则逻辑过于复杂,反而偏离了本意,反映出对正则表达式的理解尚需深化。
以上关于Python连接HDFS实现文件上传下载及Pandas转换文本文件到CSV的操作内容分享完毕,希望能提供参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









