

TensorFlow中tf.gradients()与tf.stop_gradient()机制详解

本文深入解析TensorFlow中tf.gradients()与tf.stop_gradient()的核心机制。tf.gradients()用于计算目标函数对变量的导数,支持自定义梯度更新;tf.stop_gradient()则用于阻断特定节点的梯度反向传播。通过代码示例展示如何在模型训练中实现前向与反向传播的解耦,以及利用stop_gradient构造自定义梯度更新策略。
引言与背景
在实验室重构代码时,注意到一段涉及TensorFlow梯度处理的逻辑,由于对stop_gradient()函数的具体行为不够熟悉,特此在周末进行梳理与总结。
代码片段示例:y = xx + K.stop_gradient(rounded - xx)
该代码最终调用的底层实现位于tensorflow.python.ops.gen_array_ops.stop_gradient(input, name=None)。关于为何采用此种写法的具体意义,将在文章末尾进行解释。
【stop_gradient()的核心意义】
利用stop_gradient生成损失函数关于特定变量的梯度。
tf.gradients()机制详解
【tf.gradients()的基本理解】
在TensorFlow中,用户只需定义前向传播函数,框架提供了强大的自动微分工具tf.gradients()来计算梯度。
tf.gradients(
 ys,
 xs,
 grad_ys=None,
 name='gradients',
 colocate_gradients_with_ops=False,
 gate_gradients=False,
 aggregation_method=None,
 stop_gradients=None,
 unconnected_gradients=tf.UnconnectedGradients.NONE
)
gradients()函数会向计算图中添加操作节点,以输出ys关于xs的导数。它返回一个长度等于len(xs)的Tensor列表,其中每个Tensor表示ys中所有y对对应x的导数之和(sum(dy/dx))。
1、tf.gradients()用于计算ys对xs的导数
2、ys和xs可以是单个Tensor,也可以是包含多个Tensor的列表
3、求导返回值是一个列表,该列表的长度等于输入变量xs的数量
例如:假设返回值是[grad1, grad2, grad3],ys=[y1, y2],xs=[x1, x2, x3]。则计算过程为:
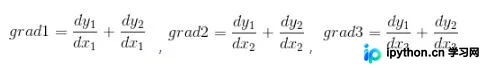
import numpy as np
import tensorflow as tf

#构造数据集
x_pure = np.random.randint(-10, 100, 32)
x_train = x_pure + np.random.randn(32) / 32
y_train = 3 * x_pure + 2 + np.random.randn(32) / 32

x_input = tf.placeholder(tf.float32, name='x_input')
y_input = tf.placeholder(tf.float32, name='y_input')
w = tf.Variable(2.0, name='weight')
b = tf.Variable(1.0, name='biases')
y = tf.add(tf.multiply(x_input, w), b)

loss_op = tf.reduce_sum(tf.pow(y_input - y, 2)) / (2 * 32)
train_op = tf.train.GradientDescentOptimizer(0.01).minimize(loss_op)
gradients_node = tf.gradients(loss_op, w)

sess = tf.Session()
init = tf.global_variables_initializer()
sess.run(init)

for i in range(20):
 _, gradients, loss = sess.run([train_op, gradients_node, loss_op], feed_dict={x_input: x_train[i], y_input: y_train[i]})
 print("epoch: {} \t loss: {} \t gradients: {}".format(i, loss, gradients))
sess.close()
自定义梯度和更新函数
import numpy as np
import tensorflow as tf

#构造数据集
x_pure = np.random.randint(-10, 100, 32)
x_train = x_pure + np.random.randn(32) / 32
y_train = 3 * x_pure + 2 + np.random.randn(32) / 32

x_input = tf.placeholder(tf.float32, name='x_input')
y_input = tf.placeholder(tf.float32, name='y_input')
w = tf.Variable(2.0, name='weight')
b = tf.Variable(1.0, name='biases')
y = tf.add(tf.multiply(x_input, w), b)

loss_op = tf.reduce_sum(tf.pow(y_input - y, 2)) / (2 * 32)
# train_op = tf.train.GradientDescentOptimizer(0.01).minimize(loss_op)

#自定义权重更新
grad_w, grad_b = tf.gradients(loss_op, [w, b])
new_w = w.assign(w - 0.01 * grad_w)
new_b = b.assign(b - 0.01 * grad_b)

init = tf.global_variables_initializer()
sess = tf.Session()
sess.run(init)

for i in range(20):
 _, gradients, loss = sess.run([new_w, new_b, loss_op], feed_dict={x_input: x_train[i], y_input: y_train[i]})
 print("epoch: {} \t loss: {} \t gradients: {}".format(i, loss, gradients))
sess.close()
tf.stop_gradient()阻断反向传播
【tf.stop_gradient()的基本理解】
在tf.gradients()函数的参数中存在stop_gradients,这是一个List类型参数,其中的元素是TensorFlow计算图中的op。一旦某个op被加入此列表,它将不会被计算梯度;更重要的是,在该op之后的反向传播(BP)计算都不会执行。
import numpy as np
import tensorflow as tf

a = tf.constant(0.)
b = 2 * a
c = a + b
g = tf.gradients(c, [a, b])

with tf.Session() as sess:
 tf.global_variables_initializer().run()
 print(sess.run(g))

#输出[3.0, 1.0]
以下是一个使用stop_gradient()的示例
import tensorflow as tf

#实验一
w1 = tf.Variable(2.0)
w2 = tf.Variable(2.0)
a = tf.multiply(w1, 3.0)
a_stoped = tf.stop_gradient(a)

# b=w1*3.0*w2
b = tf.multiply(a_stoped, w2)
gradients = tf.gradients(b, xs=[w1, w2])
print(gradients)
#输出[None, <tf.Tensor 'gradients/Mul_1_grad/Reshape_1:0' shape=() dtype=float32>]

#实验二
a = tf.Variable(1.0)
b = tf.Variable(1.0)
c = tf.add(a, b)
c_stoped = tf.stop_gradient(c)
d = tf.add(a, b)
e = tf.add(c_stoped, d)
gradients = tf.gradients(e, xs=[a, b])
with tf.Session() as sess:
 tf.global_variables_initializer().run()
 print(sess.run(gradients))

#因为梯度从另外地方传回,所以输出 [1.0, 1.0]
【答案】
前向与反向传播解耦示例解析
回到开头提出的问题,解释为何存在那段代码:
t = g(x)
y = t + tf.stop_gradient(f(x) - t)
这里,我们本来的前向传递函数是XX,但是想要在反向时传递的函数是g(x),因为在前向过程中,tf.stop_gradient()不起作用,因此+t和-t抵消掉了,只剩下f(x)前向传递;而在反向过程中,因为tf.stop_gradient()的作用,使得f(x)-t的梯度变为了0,从而只剩下g(x)在反向传递。
以上这篇Tensorflow中k.gradients()和tf.stop_gradient()用法说明就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









