

Python爬虫URL管理器实现:基于deque的去重与防循环机制
本文详解Python爬虫中URL管理器的实现方法,重点解析如何利用collections模块中的deque双向队列高效维护待抓取与已抓取URL集合。通过示例代码展示如何判断URL存在性、执行去重逻辑及防止页面跳转死循环,为构建稳定爬虫系统提供核心组件参考。
2026-10-13
21

本文详解Python爬虫中URL管理器的实现方法,重点解析如何利用collections模块中的deque双向队列高效维护待抓取与已抓取URL集合。通过示例代码展示如何判断URL存在性、执行去重逻辑及防止页面跳转死循环,为构建稳定爬虫系统提供核心组件参考。
本文详细介绍 Python 中成熟的 ORM 框架 SQLAlchemy 的基本用法。内容涵盖 ORM 的核心概念、优势及迁移便利性,并通过完整的代码示例演示如何建立数据库表模型、执行数据存储以及进行数据查询与更新操作,帮助开发者快速掌握 SQLAlchemy 在 Python Web 开发中的实际应用。
本文深入解析Python中的递归机制,通过阶乘和汉诺塔实例展示递归模型的构建方法。重点探讨尾递归优化的原理及其在防止栈溢出中的作用,并指出Python解释器目前不支持尾递归优化导致的栈溢出风险,为开发者提供实用的递归编程参考。
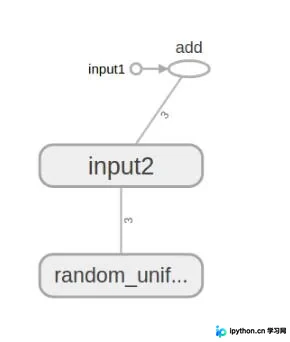
本文介绍TensorFlow中tf.name_scope与tf.variable_scope的区别,演示如何通过命名空间整理TensorBoard计算图节点。通过修改代码示例,展示如何在TensorBoard中展开和查看特定命名空间下的运算节点,提升可视化清晰度。
本文介绍如何在Python中利用wave模块提取WAV音频文件的关键参数。通过调用getparams()方法,可快速获取声道数、量化位数、采样频率及采样点数。文中提供完整代码示例,并对比Windows下sox命令的验证结果,确保数据一致性,适用于音频分析与处理场景。
本文详细介绍Python中数据归一化的定义、目的及常见实现方法。归一化旨在消除量纲影响,提升数据可比性,主要处理奇异样本数据。内容涵盖最大-最小标准化(映射至[0,1])和Z-score标准化(均值0,方差1),并解析矩阵列归一化原理。通过sklearn库的normalize函数示例,展示axis参数在行与列归一化中的具体应用,为机器学习数据预处理提供实用参考。
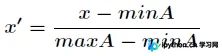
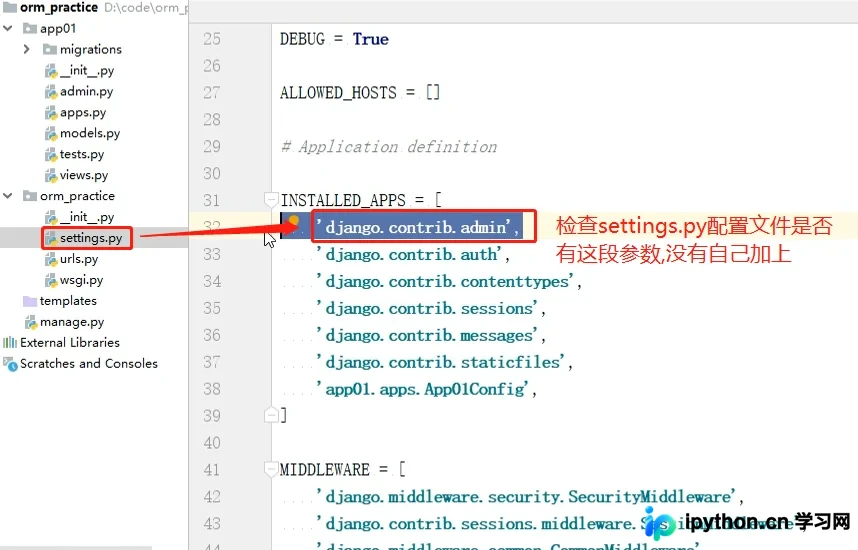
本文详细介绍Django后台管理系统的配置流程,包括检查URL路由、启动服务及创建超级用户的具体命令与参数要求。同时深入讲解如何在Django中集成Tinymce富文本编辑器,涵盖模块安装、settings配置、URL注册及模型应用等关键步骤,帮助开发者快速实现后台内容的富文本编辑功能。
本文介绍TensorFlow中张量数据的切片与重塑操作。通过tf.split函数按指定维度将张量分割为多个子张量,并利用tf.reshape命令将高维张量转换为二维数组。文章包含完整的代码示例、输出结果分析及关键参数说明,帮助开发者掌握TensorFlow基础数据处理技巧。
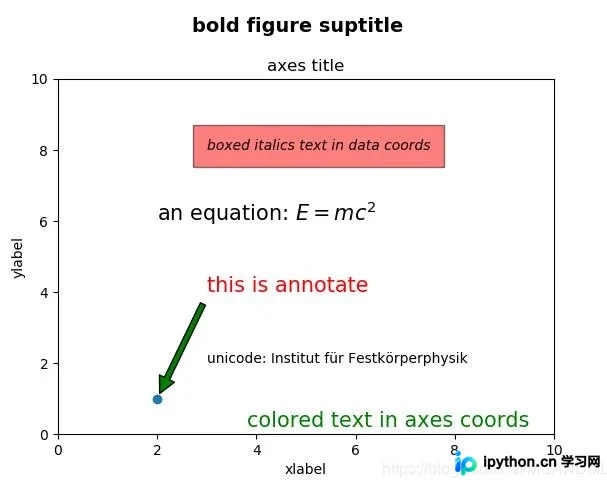
本文详细介绍Python中Matplotlib库的subplot子图绘制流程。涵盖从数据准备、画布创建、多种绘图方式(如plot、bar、scatter等)到图表定制(标题、标签、注释、图例)及保存显示的完整步骤。重点解析fig.add_subplot与plt.subplots()函数的参数用法,包括行列数、共享坐标轴及布局调整,并提供代码示例供参考。
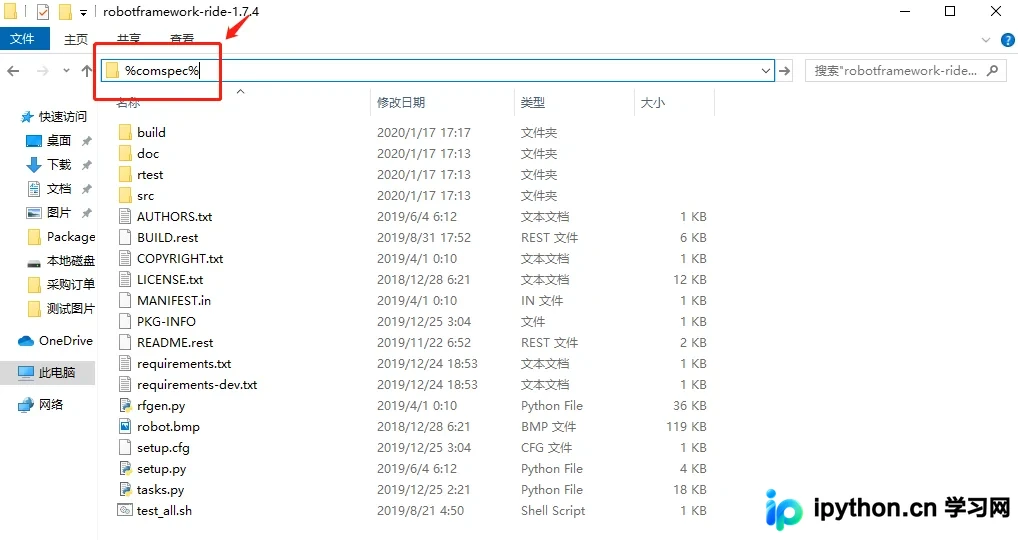
本文详细讲解在Python中安装tar.gz格式源码文件的具体步骤。以robotframework-ride-1.7.4.tar.gz为例,介绍了将文件放入Lib目录、定位setup.py文件以及通过命令行执行python.exe setup.py install进行自动安装的全过程,适用于没有对应.whl文件的库安装场景。
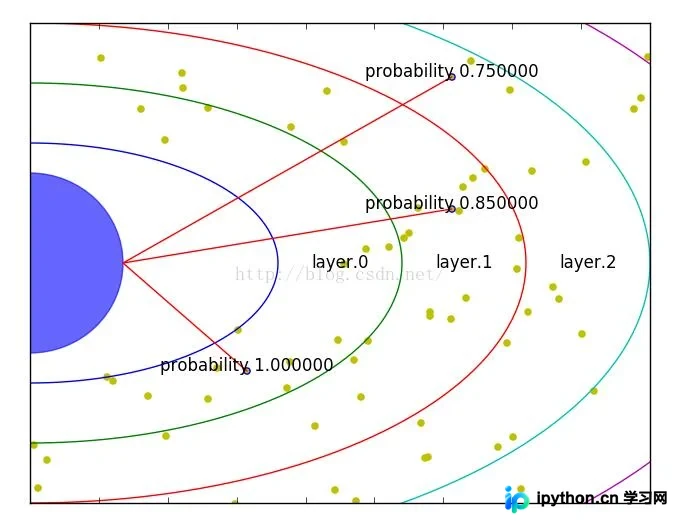
本文介绍如何使用Python的Matplotlib库绘制轨道及概率分布。通过定义圆形基础与多层椭圆轨道,结合泊松分布随机生成数据点,实现动态轨道与概率位置的可视化展示,适用于轨道模拟与数据分析场景。
本文解析Python中replace()函数看似替换无效的原因。由于Python字符串是不可变对象,直接调用replace()不会修改原变量,必须将返回值重新赋值给变量。通过对比错误代码与正确示例,帮助开发者理解引用机制,避免常见陷阱。