

Pandas分组聚合实战:深入解析transform与apply自定义函数用法

发布时间:2026-10-12| 1人浏览过
本文详细解析Pandas中transform与apply方法在分组聚合中的区别与应用。通过示例展示如何利用自定义函数处理Series和DataFrame,包括数值计算、字符串操作及多列聚合。重点阐述transform保持原索引长度与apply返回聚合结果的特性,帮助开发者根据需求选择合适方法,提升数据处理效率。
首先构建一个包含学生姓名、分数、分组、班级及身高的DataFrame数据结构。
import pandas as pd

df = pd.DataFrame(
    data={
        'name': ['z_s', 'l_s', 'w_w', 'z_l', 'y_s', 'j_j', 'l_b', 'z_f', 'hs_q', 'lbl_k', 'qy_n', 'mg_n'],
        'score': [100, 97, 98, 89, 67, 59, 29, 87, 78, 89, 88, 80],
        'group': [1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 2],
        'cls': ['A', 'A', 'A', 'B', 'B', 'B', 'A', 'A', 'A', 'B', 'B', 'B'],
        'height': [178.0, 180.0, 176.0, 182.0, 189.0, 190.0, 172.5, 175.0, 165.0, 160.0, 158.5, 159.0]
    },
    index=['stu_' + str(i) for i in np.arange(1, 13, 1)]
)
print('df:\n', df)

def func_add_one(x):
    return x + 1
接下来演示transform方法的具体使用方式。
# 调用自定义函数
ret = df.loc[:, 'score'].transform(func_add_one)
print('ret1:\n',ret)
# 调用numpy指标 求均值
ret = df.groupby(by=['cls'])['score'].transform(np.mean)
print('ret2:\n', ret)
# 求 多列的均值
ret = df.groupby(by=['cls'])[['score','height']].transform(np.mean)
print('ret3:\n', ret)
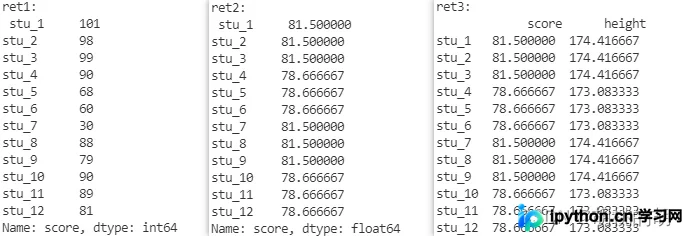
观察运行结果可知,当transform调用统计指标时,会将统计后的数值广播至该组的第一个元素位置,从而确保输出数据的行数与原输入数组完全一致。这种特性使得后续将统计结果直接拼接回原DataFrame变得十分便捷。
若需对数据进行真正的聚合操作,则应调用apply方法。
随后介绍apply方法的使用场景。
# 调用自定义函数
ret = df.loc[:, 'score'].apply(func_add_one)
print('ret1:\n',ret)

# 调用numpy指标
ret = df.groupby(by=['cls'])[['score','height']].apply(np.mean)
print('ret2:\n', ret)
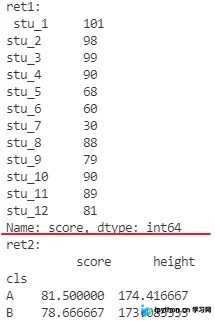
补充说明部分。
transporm方法的功能是将DataFrame或Series中的值同时传入指定的函数中执行,并将执行结果返回。
示例展示了获取name列第0个元素的操作过程。
def func_get_firstnameword(x):
    return x[0]

ret = df['name'].transform(func_get_firstnameword)
print('ret:\n', ret)
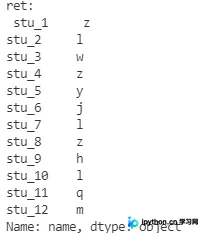
自定义方法具备极高的灵活性,通过编写自定义逻辑,可以对数据进行各类复杂操作,最终获取期望的处理结果。
此外,还可以利用str方法进行处理。
str方法与dt方法类似(关于dt方法的使用可参考相关文档)。
ret = df['name'].str.split('_', expand=True)[0]
print('ret:\n', ret)
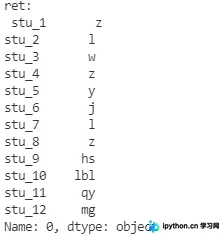
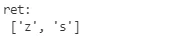
str的作用是将整个Series视为字符串对象,对Series中的所有元素同时执行.split('_', expand=True)[0]方法。其中,expand=True参数的作用是明确指定split()方法是对整个Series进行批量操作,而非仅针对第一个元素进行处理:
ret = df['name'].str.split('_')[0]
print('ret:\n', ret)
文章总结。
至此,关于Pandas分组聚合中transform()与apply()自定义函数方法的使用介绍完毕。如需了解更多Pandas自定义函数相关内容,建议查阅本站历史文章或继续浏览后续教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









