

Python实现模拟登录网易邮箱的方法示例
本文详细介绍如何使用Python的urllib2库实现网易邮箱的模拟登录。通过配置代理IP、处理CookieJar、构造POST请求及解析响应HTML,完成身份验证并获取登录后的页面内容。代码包含完整的请求头设置与URL跳转处理,适用于Python 2环境下的自动化登录场景。
2026-10-13
17

本文详细介绍如何使用Python的urllib2库实现网易邮箱的模拟登录。通过配置代理IP、处理CookieJar、构造POST请求及解析响应HTML,完成身份验证并获取登录后的页面内容。代码包含完整的请求头设置与URL跳转处理,适用于Python 2环境下的自动化登录场景。
本文介绍使用Python Selenium与xlwings库实现有赞订单自动发货的方法。通过读取Excel中的客户姓名与物流单号,Selenium自动登录有赞后台,搜索订单并填入单号完成发货操作,提升电商运营效率。
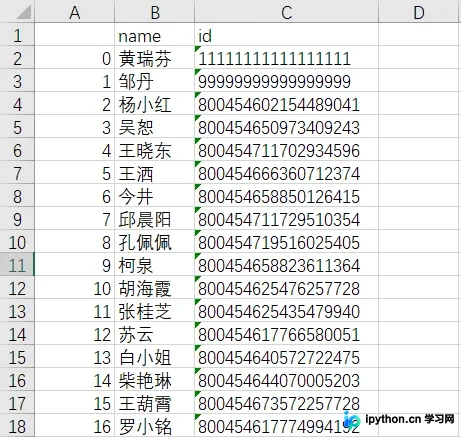
在使用pandas读取文件名含中文的csv文件时,常因默认C引擎兼容性问题触发OSError。通过将read_csv函数的engine参数显式设置为'python',可解决中文标题读取错误,尽管速度略慢但功能更完备。
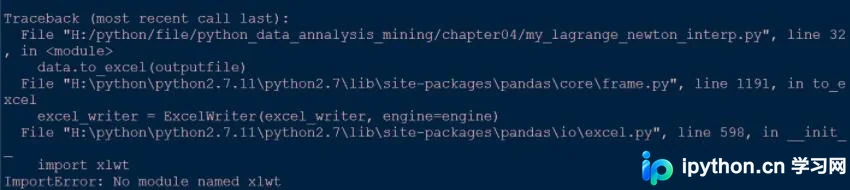
本文针对Python使用pandas库将DataFrame写入Excel时遇到的两个常见错误进行解析。首先介绍如何通过pip安装缺失的xlwt依赖库;其次重点解决因Windows路径中单斜杠导致的to_excel报错,指出需将路径中的单斜杠替换为双斜杠以正确处理转义字符,确保文件成功保存。
本文介绍如何使用pandas的read_table函数读取CSV文件。通过对比指定sep=','与不指定分隔符两种情况,分析read_table在默认行为下的数据解析差异。结果显示,明确指定分隔符可正确生成DataFrame结构,而省略sep参数可能导致列名合并及数据解析异常,建议在实际操作中显式声明分隔符以确保数据准确性。
本文介绍在 Python 数据分析中,利用 pandas DataFrame 进行行筛选的常用技巧。通过 isin() 方法可实现按特定值选取行,而排除特定行则可通过将列转换为列表并移除目标值后再次使用 isin() 来实现,无需额外函数。
本文详细介绍Django框架中Cookies和Session的常用操作方法,包括如何检查、获取、设置及删除Cookies,以及Session的读写、存在性判断和数据库清除命令。同时提供基于自定义Cookies实现登录、注册和退出功能的完整代码示例,帮助开发者掌握Django中的状态管理机制。
本文详解Django中datetime对象的格式化与解析方法,重点讲解strftime将时间转为字符串及strptime将字符串转为时间的具体用法。针对开发中常见的12小时制导致前后端时间不一致、以及datetime对象无法直接JSON序列化等Bug提供解决方案,并补充time模块基础类型说明,帮助开发者避免常见陷阱。
本文介绍Django中利用母板页面实现代码复用的核心机制。通过{% block %}定义占位符,子页使用{% extends %}继承母板并填充具体HTML内容。文章提供base.html基础模板及两个具体继承页面的代码示例,展示如何统一导航样式并差异化显示主体内容,帮助开发者构建结构清晰的Web应用界面。
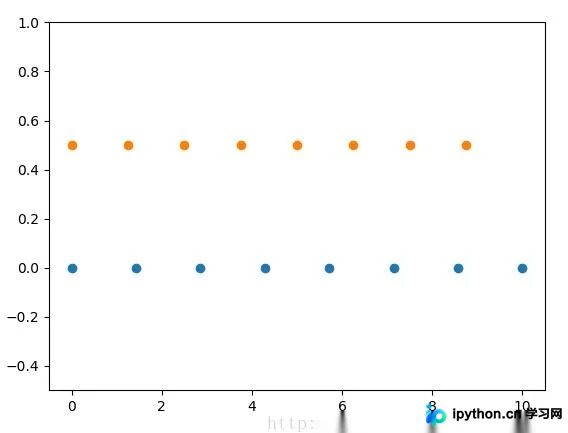
本文详细介绍Python中numpy库的linspace函数,用于生成指定数量的等差数列。重点解析start、stop、num、endpoint、retstep及dtype等核心参数的含义与默认值,并通过代码示例展示其用法。同时对比了arange函数通过步长生成数组的区别,帮助开发者根据需求选择合适的数组生成方式。
本文分析Python爬虫中常见错误:在循环外定义字典并多次调用list.append(),导致列表中所有元素指向同一内存地址,最终值被最后一次循环覆盖。通过将字典初始化移至循环内部,确保每次迭代创建新对象,从而正确保存所有数据。
本文介绍利用Python去除文件中重复行的方法。通过定义空列表存储已出现行,遍历文件时判断是否重复,若重复则记录行号及内容至新文件,否则加入列表。该方案可有效识别并导出重复数据,适用于文本清洗场景。