

Python使用广度优先搜索爬取网站内外链完整代码示例
本文详细介绍如何使用Python结合广度优先搜索(BFS)算法,编写代码以获取指定网站的所有内链与外链。文章涵盖队列类的定义、urllib库解析URL的方法、请求头设置以及完整的爬虫实现逻辑,并提供百度图片站点的爬取结果示例,适合Python初学者参考学习。
2026-10-14
16

本文详细介绍如何使用Python结合广度优先搜索(BFS)算法,编写代码以获取指定网站的所有内链与外链。文章涵盖队列类的定义、urllib库解析URL的方法、请求头设置以及完整的爬虫实现逻辑,并提供百度图片站点的爬取结果示例,适合Python初学者参考学习。
本文详细介绍Python中的条件控制语句,涵盖双分支结构的语法格式、三元条件运算符的使用方法及多项分支的执行逻辑。通过具体代码示例,解析if-else语句及条件表达式的真假判断流程,帮助开发者掌握分支选择的核心用法。
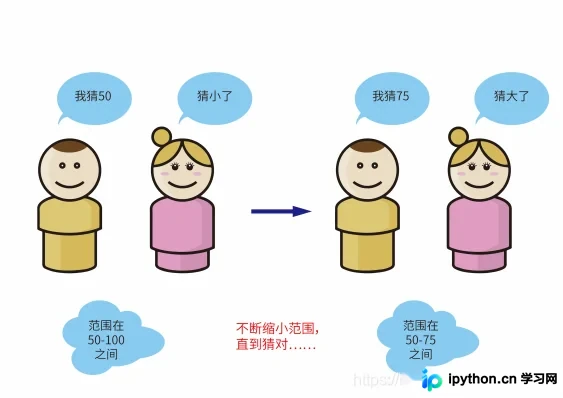
本文深入解析Python中的折半查找(二分查找)算法,阐述其通过不断缩小搜索范围来快速定位目标数据的原理。文章结合排序数列示例演示具体步骤,并通过线路故障排查的实际案例,展示如何利用该算法高效锁定故障点,代码完整且附带执行流程说明。
本文深入解析Python多线程机制,涵盖线程定义、优势及与普通进程的区别。详细演示线程的多种创建方式,并通过I/O密集型与计算密集型任务的对比实验,阐明多线程在不同场景下的性能表现及适用建议,帮助开发者优化并发程序。
本文针对500万行级别的大规模数据,系统对比了Pandas中iloc、at、apply及Series直接处理的速度差异。实测显示,iloc耗时约5小时,at优化至10分钟,而转为Series处理仅需37秒。此外,文章通过数值实验深入剖析了loc、at、iloc、iat及直接访问values数组在读取与修改场景下的性能表现,指出直接获取二维数组再定位是最高效方案,并提供了相应的代码实现与优化建议。
本文详细介绍在Django项目中配置Memcached和Redis作为缓存后端的完整步骤,涵盖Windows与Linux系统的安装、服务启动及Django settings.py配置方法。通过对比数据结构、键值上限、持久化支持等核心特性,分析两者差异,并给出针对中大型网站的选型建议,帮助开发者提升网站性能。
本文详细介绍Python中List去重且保持原有顺序的多种方法。对比了直接使用set导致顺序混乱的问题,并提供了基于set排序、普通循环、列表推导式以及Lambda表达式的高效实现方案。文章包含完整代码示例与性能讨论,帮助开发者根据实际需求选择最优解。
本文详细介绍如何结合Tushare、PyCharm和Excel进行股票数据分析。通过PyCharm安装numpy、tushare和matplotlib库,使用Tushare接口获取指定股票的历史交易数据,并导出至Excel。为解决PyCharm写入Excel时覆盖其他Sheet的问题,文章提出建立双文件同步策略,利用Excel公式实现数据自动关联,最终支持K线、MACD等技术指标分析。
本文介绍在Python中计算两个不等长列表对应元素乘积和的两种实现方式。首先通过遍历较短列表进行手动累加,其次利用内置zip函数将列表打包为元组后求和。文章还补充了计算列表元素总积的递归与迭代示例,帮助理解相关编程技巧。
本文介绍Jupyter Notebook中代码突然无法执行的问题,主要原因为代码错误导致Kernel状态异常。通过观察右上角内核状态图标(空心与实心)判断执行状态,并给出重启Kernel、修正错误代码的解决方案。此外,还列举了无法读取CSV文件和快捷方式失效等常见错误及其路径检查的解决方法。
本文详解Python中私有属性和私有方法的实现机制。通过双下划线__前缀,Python将属性或方法名进行名称改写,从而实现对外部访问的限制。文章介绍了私有成员在类内部的可访问性、对子类不可继承的特性,并通过具体代码案例演示了如何安全地封装数据及调用内部逻辑,帮助开发者更好地利用封装特性提升代码安全性。
本文详细解析Python中合并列表的八种常见方法,包括使用加号、itertools.chain、解包操作符、extend方法、列表推导式、heapq.merge、魔法方法__add__结合reduce以及yield from生成器。文章强调在团队协作中,代码简洁性与可读性优于炫技,建议根据具体场景(如是否需要排序、性能要求等)选择最合适的合并策略,并指出理解多种写法有助于阅读他人代码。