Django中url与path及re_path的区别说明
本文详细解析Django框架中url、path及re_path函数的区别与用法。重点介绍Django 2.x版本中path和re_path的引入背景,对比两者在参数捕获、类型转换器及正则表达式使用上的差异。同时提供从Django 1.x迁移至2.x时的常见配置问题及解决方案,包括namespace设置和模块导入注意事项,帮助开发者正确配置URL路由。
2026-10-14
16

本文详细解析Django框架中url、path及re_path函数的区别与用法。重点介绍Django 2.x版本中path和re_path的引入背景,对比两者在参数捕获、类型转换器及正则表达式使用上的差异。同时提供从Django 1.x迁移至2.x时的常见配置问题及解决方案,包括namespace设置和模块导入注意事项,帮助开发者正确配置URL路由。
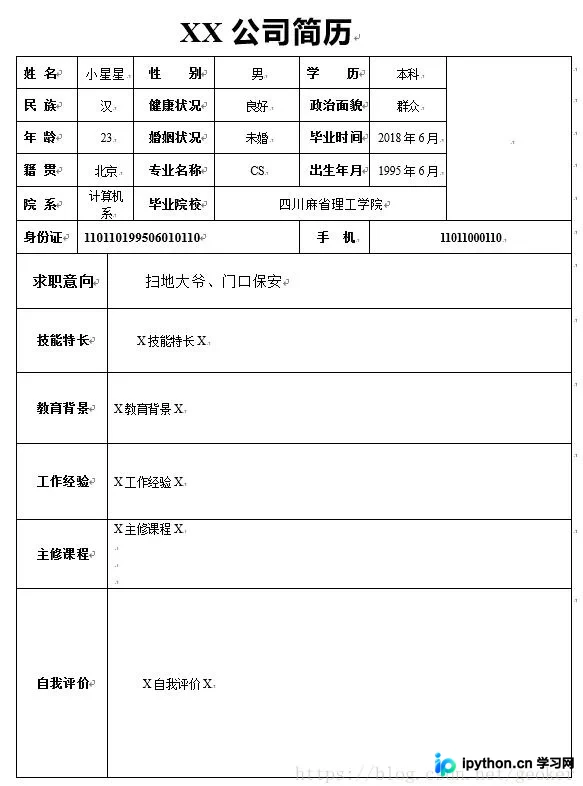
本文介绍如何利用Python自动处理大量Word表格简历。通过解析docx文件内部的zip结构和document.xml,结合正则表达式提取姓名、学历等关键字段,并批量写入txt或Excel文件。文章提供完整代码示例及常见权限错误解决方案,帮助开发者高效完成数据整理任务。
本文详解NumPy中sum函数的axis与keepdim参数。axis指定求和维度,keepdim控制输出维度是否保留。通过三维数组示例说明axis对不同层级的影响,并结合代码展示keepdim=True如何保持结果维度与原始数组一致,帮助开发者精准控制数组计算结果。
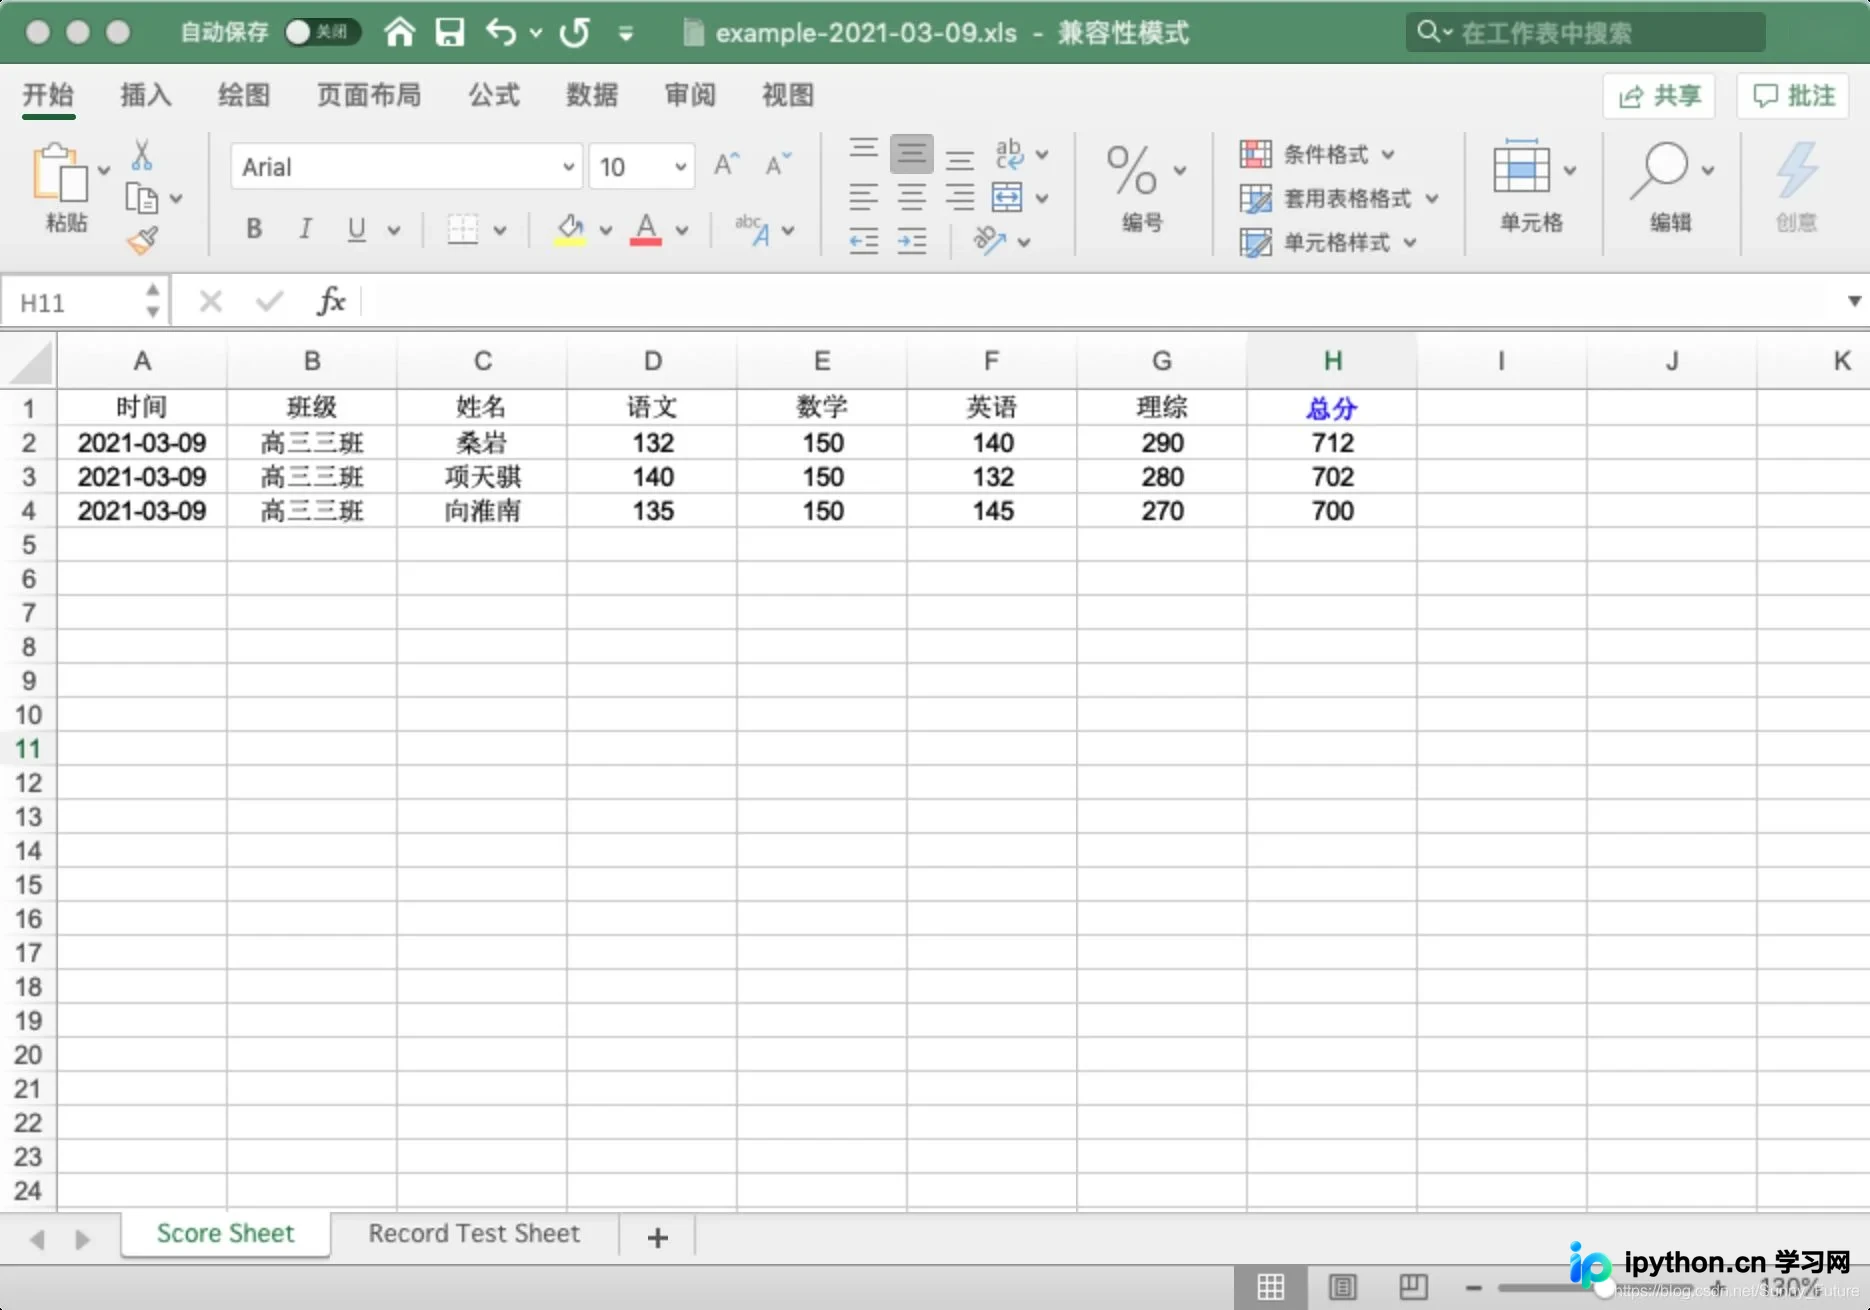
本文详细介绍Python中处理Excel文件的三个核心库:xlrd用于读取,xlwt用于写入,xlutils用于修改。通过安装模块、写入带格式数据、读取Sheet内容及使用copy方法修改现有文件等实例,演示如何高效操作Excel表格,并指出复制xls文件时格式保留的局限性。
本文介绍如何使用Python编写程序计算输入数字的平方,并通过条件判断实现当平方值小于100时退出循环的功能。文章提供了完整的源代码、运行结果示例,以及一个将退出阈值调整为50的补充案例,帮助读者理解基本的数据输入、数学运算与流程控制。
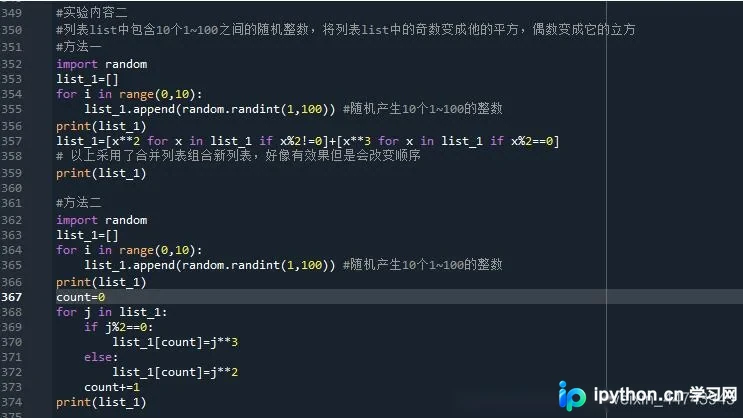
本文介绍使用Python对包含1至100整数的列表进行特定规则转换的方法。核心逻辑为:遍历列表,若元素为偶数则计算其平方值,若为奇数则计算其立方值,并返回转换后的新列表。文中提供了基于循环的完整实现代码及测试用例,适用于Python初学者理解列表遍历与条件判断的应用场景。
本文介绍如何利用Python的jieba库对中文文本进行精确分词,并通过Counter模块统计高频词汇。同时结合matplotlib和wordcloud库,将统计结果可视化生成词云图。文章包含完整的代码示例、运行结果分析及注意事项,适用于需要处理中文文档并提取关键信息的场景。
本文介绍在 Python3 环境下,如何将爬取或接口返回的 bytes 格式图片数据直接保存为本地 JPG 文件。文章提供了两种主要实现方式:一是利用 urllib 库的 urlretrieve 方法直接下载保存;二是结合 requests 获取内容,并通过 PIL (Pillow) 库将字节流转换为图像对象后保存。文中包含具体的代码示例,涵盖从网络请求到本地文件写入的完整流程,适用于爬虫数据处理及 API 图像存储场景。
本文介绍如何使用Python实现邮箱的自动监控与邮件处理。通过zmail库可快速获取最新邮件并提取主题及附件;同时结合smtplib、poplib等标准库,演示了构建完整邮件发送逻辑的方法,包括正文添加、附件处理及标题解码,为开发者提供实用的邮箱自动化操作参考。
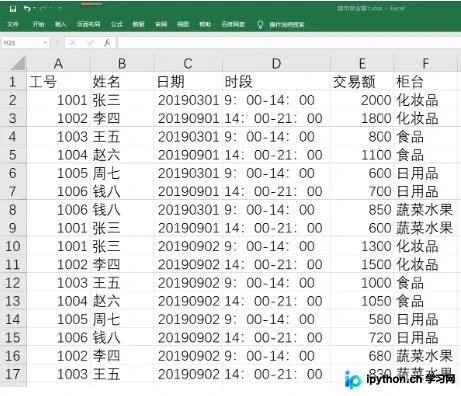
本文介绍如何使用Python的docx库提取Word文档中的红色加粗文字及所有超链接地址与文本,并结合openpyxl库处理Excel文件,统计员工、时段及柜台的销售额。内容涵盖文档结构解析、代码实现及结果展示,适用于Python办公自动化场景。
本文详解Python中判断集合范围与包含关系的方法。通过大于、小于、等于等运算符检查集合间的子集或超集关系,并介绍issubset判断子集、isdisjoint判断无交集的具体用法与代码示例,帮助开发者准确掌握集合比较逻辑。
本文详细解析Python中random模块的核心功能,涵盖random.random、uniform、randint及choice等常用函数的具体用法与参数限制。重点讲解种子设定对随机数生成的影响,以及shuffle和sample在序列处理中的应用,帮助开发者准确掌握随机数生成与列表打乱技巧。