Python3 xml.etree.ElementTree支持的XPath语法详解
本文详细介绍Python3中xml.etree.ElementTree模块支持的有限XPath表达式语法。内容涵盖标签名、通配符、属性过滤、文本匹配及位置索引等核心用法,并通过具体代码示例演示如何在XML文档中精准定位子元素、孙子元素及特定属性节点,帮助开发者高效进行XML数据提取与处理。
2026-10-13
19

本文详细介绍Python3中xml.etree.ElementTree模块支持的有限XPath表达式语法。内容涵盖标签名、通配符、属性过滤、文本匹配及位置索引等核心用法,并通过具体代码示例演示如何在XML文档中精准定位子元素、孙子元素及特定属性节点,帮助开发者高效进行XML数据提取与处理。
本文详细介绍如何使用Python第三方库pygame开发经典的贪吃蛇小游戏。通过导入模块、初始化窗口、定义蛇与食物坐标类、处理游戏逻辑及渲染画面等步骤,完整展示了游戏核心代码实现。文章包含关键参数设置、碰撞检测机制及游戏循环控制,帮助开发者快速掌握pygame基础应用并实现可运行的贪吃蛇程序。
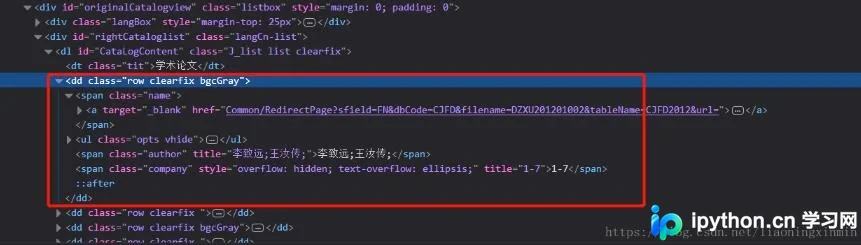
本文详解Python中XPath解析定位的六种核心方法。内容涵盖绝对路径与相对路径的区别、基于索引的定位、节点属性精确匹配、部分属性值模糊匹配(如contains、starts-with),以及多条件组合定位技巧。通过具体代码示例,帮助开发者掌握高效精准的网页数据抓取定位策略。
本文介绍如何使用Python的lxml库通过XPath定位HTML文档中的特定元素,并解决提取内容中出现的中文乱码问题。通过html.tostring获取字节流后,利用HTMLParser.unescape方法将HTML实体编码转换为可读字符串,从而完整保留原始文本内容。
本文通过五个Python代码实例,详解如何使用requests库进行网络爬虫开发。内容涵盖普通页面爬取、模拟浏览器请求规避限制、搜索引擎关键词抓取、图片保存以及IP地址归属地查询,提供完整代码与参数解析,帮助开发者快速掌握网络数据提取核心技巧。
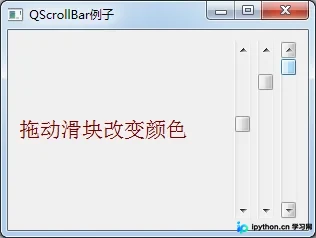
本文深入解析PyQt5中的QScrollBar滚动条控件,重点介绍valueChanged和sliderMoved等常用信号及其应用场景。通过一个控制标签文字RGB颜色的完整代码示例,演示如何创建水平滚动条、设置最大值255,并将sliderMoved信号与槽函数绑定,实现实时颜色调整。
本文详细解析Python中Paramiko模块的SSH功能,涵盖基于用户名密码和公钥密钥的SSHClient与Transport两种登录方式,演示SFTP文件上传下载,并深入讲解如何实现类似Xshell的交互式命令行终端及SSH服务端开发,适用于运维自动化与远程管理场景。
本文详解Python中如何使用os.chmod修改Linux文件及目录的读写执行权限,解析stat模块中各类权限常量的含义。同时针对Python脚本在Linux下通过绝对路径无法执行的问题,提供了利用os.path.abspath和os.chdir切换工作目录的解决方案,确保脚本能正确调用相对路径资源。
本文详细介绍如何利用Python内置的xml.dom.minidom模块对XML文件进行解析、新建写入及节点更新操作。通过具体代码示例,演示如何遍历节点、创建新元素并追加到文档,以及如何定位并修改特定节点的文本值或属性,适用于需要处理XML数据结构的开发场景。
本文深入解析Python中常用的len()函数,阐述其返回对象长度的核心功能。详细列出语法格式及参数要求,并通过元组、列表、字典、字符串及集合等具体代码示例,展示len()在不同数据类型中的实际调用方法与返回值,帮助开发者快速掌握该API的高效使用。
本文详解Python中urllib模块的自定义Opener构建原理。通过HTTPHandler、ProxyHandler及HTTPCookieProcessor处理器,实现代理IP切换与Cookie持久化。涵盖Debug调试、免费与私密代理选择策略,以及基于CookieJar的模拟登录流程,帮助开发者突破基础urlopen的功能限制。
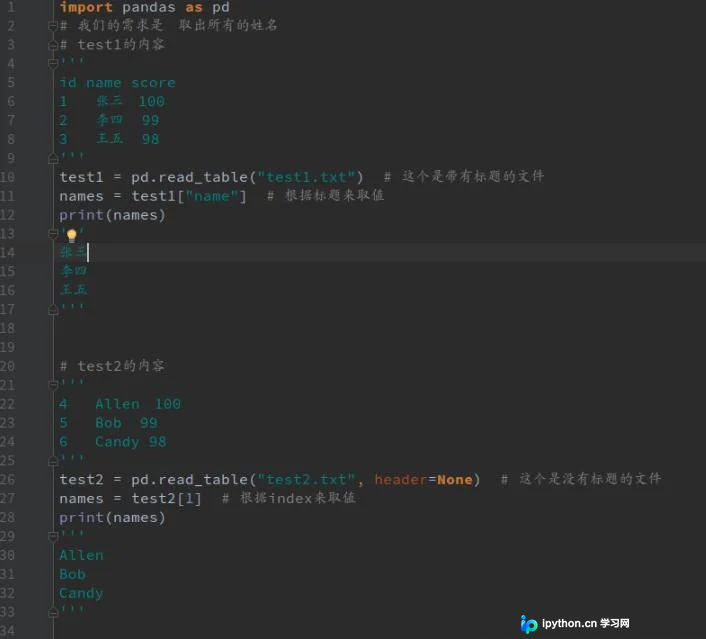
本文介绍使用pandas读取txt文件指定列的方法,重点区分带有标题和无标题文件的处理差异。详细解析read_table函数的filepath_or_buffer、sep、names、engine及encoding等关键参数,解决中文路径及编码问题,并提供完整代码示例与常见错误排查指南。