Python使用ddddocr实现简单验证码识别
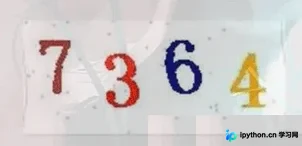
本文介绍如何利用Python的ddddocr开源库进行简单的验证码识别。通过pip安装模块,实例化对象后读取图片二进制数据,调用classification方法即可输出识别结果。该方法适用于纯数字及字母数字混合验证码,虽精度有限但部署简便,适合数据采集场景。
2026-10-15
6

本文介绍如何利用Python的ddddocr开源库进行简单的验证码识别。通过pip安装模块,实例化对象后读取图片二进制数据,调用classification方法即可输出识别结果。该方法适用于纯数字及字母数字混合验证码,虽精度有限但部署简便,适合数据采集场景。
本文介绍使用Python脚本快速保存微信公众号文章图片的方法。通过requests获取HTML,利用BeautifulSoup解析标题与时间,结合正则表达式提取图片URL并保存至本地文件夹。同时附带Python正则匹配日期与时间的示例代码,帮助开发者掌握文本解析技巧,实现自动化内容抓取。
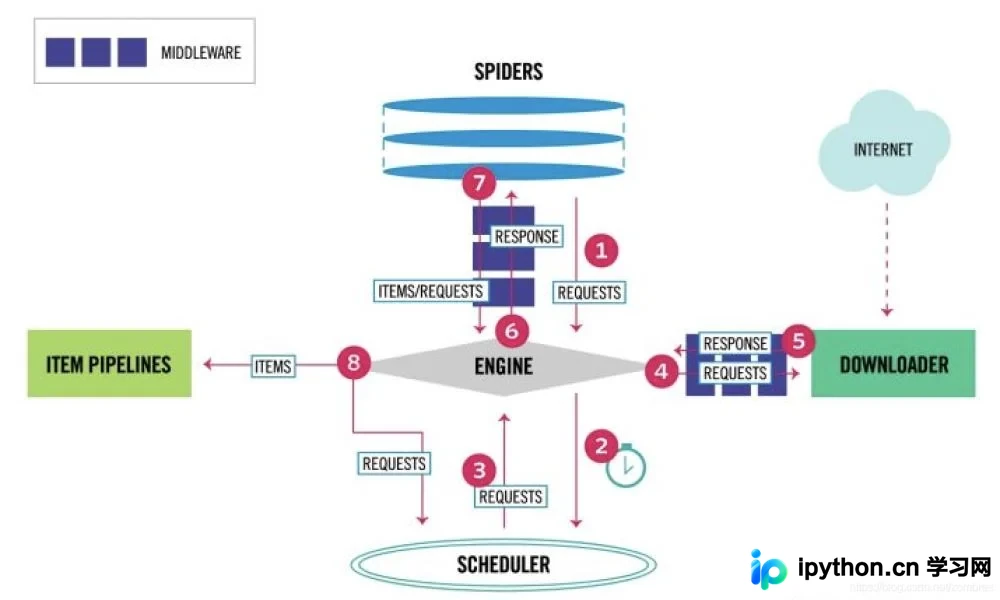
本文深入解析 Scrapy 框架中的两类核心中间件:下载器中间件(Downloader Middleware)与 Spider 中间件。详细说明了中间件的注册顺序、执行流程及关键方法(process_request、process_response、process_exception)的行为差异。提供了自定义 User-Agent 轮换、代理 IP 切换及基于状态码的重试中间件代码示例,并介绍了 Spider 中间件对 Item 和 Request 的处理逻辑,帮助开发者构建更稳健的爬虫系统。
本文介绍如何在Python中使用js2py库直接运行JavaScript代码。针对爬虫中常见的JS加密、混淆及动态接口返回JS变量等场景,详细讲解eval_js和EvalJs两种核心用法。通过提取JS对象属性和调用函数,实现从复杂JS代码中高效获取数据,解决传统正则或字符串解析的繁琐问题,满足90%日常爬虫需求。
本文介绍如何使用Python Flask框架搭建一个个性化网站,通过抓取高清图片与特定语录数据,结合前端懒加载技术实现流畅浏览体验,并详细讲解使用Gunicorn进行服务部署的具体配置与启动命令。
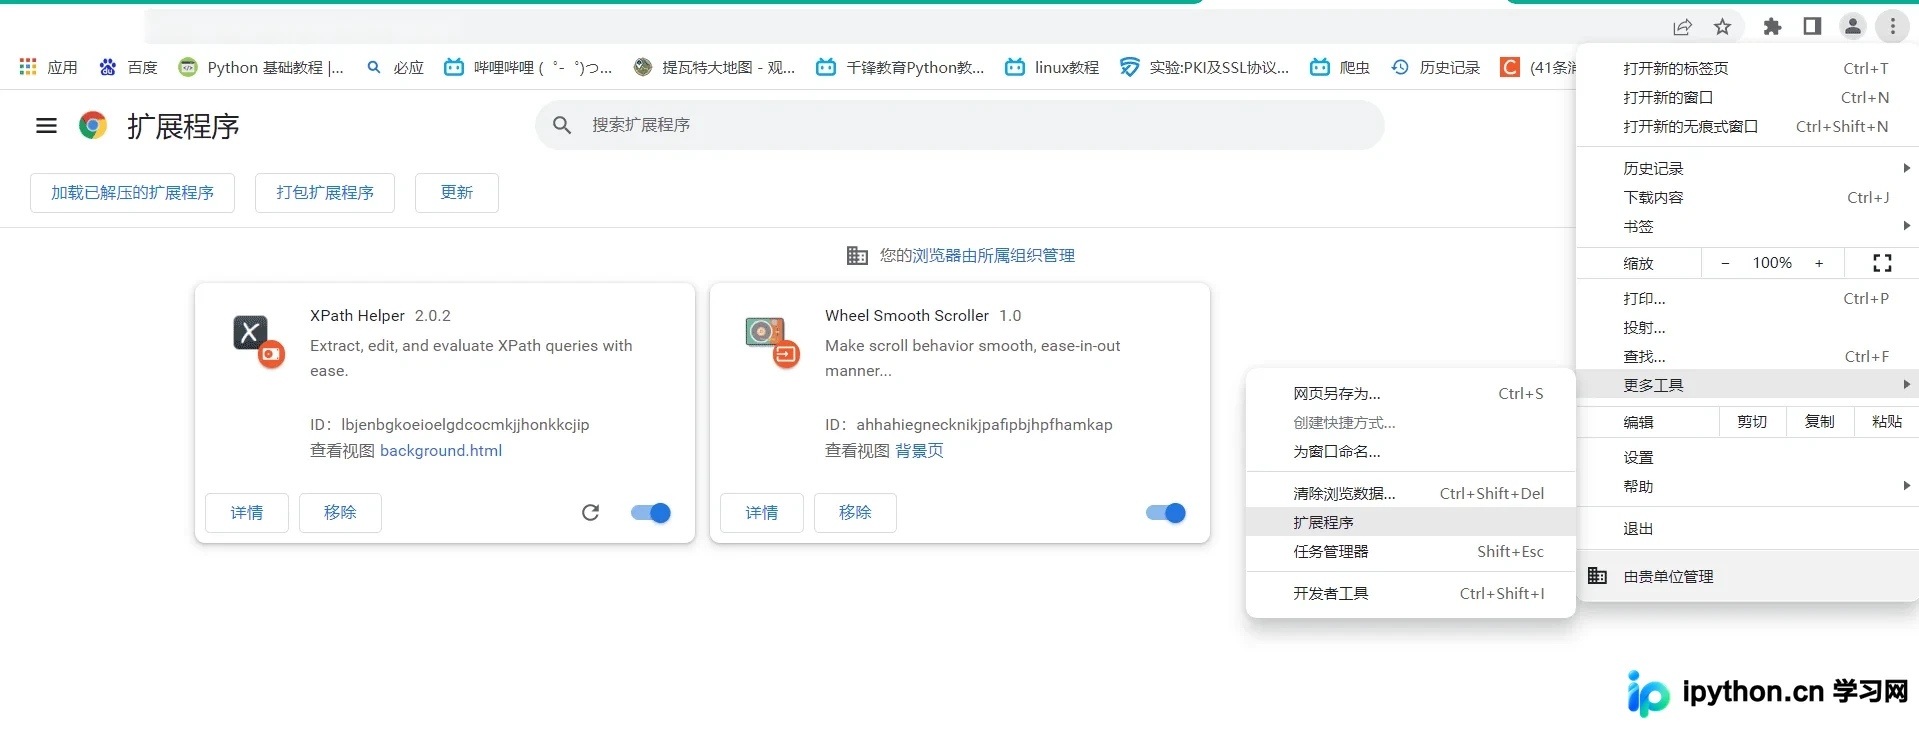
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。
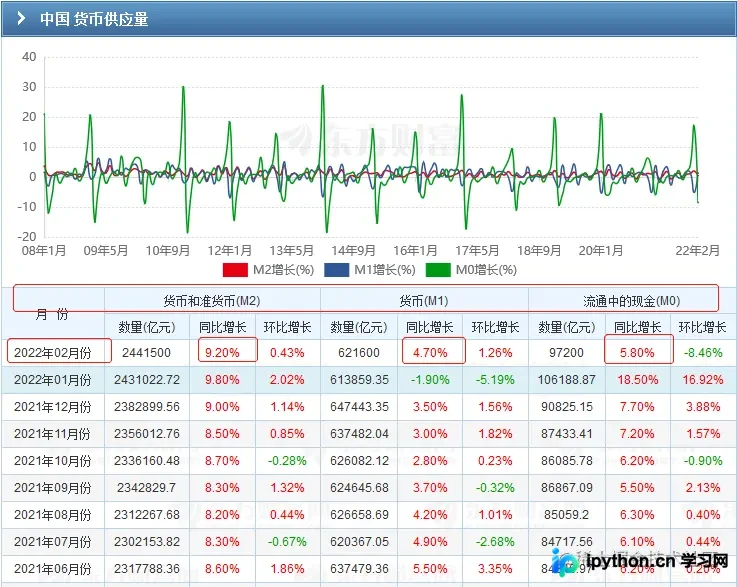
本文详解如何使用Python从东方财富网抓取M0、M1、M2货币供应量数据,并通过Matplotlib库绘制增速对比图。重点展示M1与M2的差值区间颜色填充,直观反映经济活跃度与流动性变化,适合初学者学习数据获取、处理及可视化全流程。
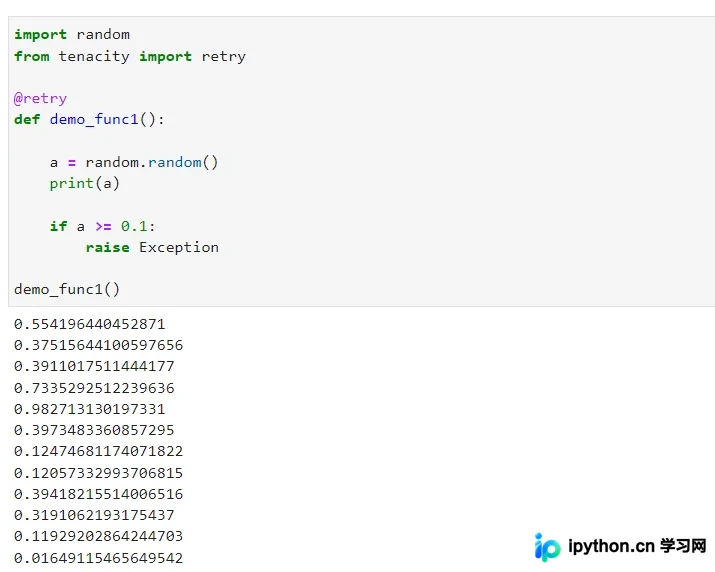
本文深入解析Python中强大的错误重试库tenacity。通过retry装饰器,实现自动重试逻辑。详解如何配置最大重试次数(stop_after_attempt)、超时限制(stop_after_delay)及组合条件。介绍wait_fixed和wait_random设置重试间隔,以及retry_if_exception_type和retry_if_result自定义重试触发条件,助力构建高可用程序。
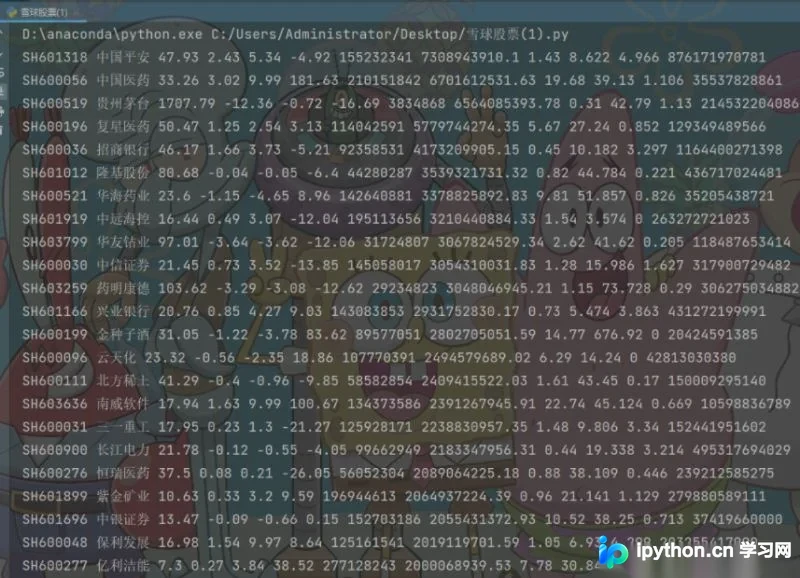
本文详细介绍如何使用Python从雪球网采集股票实时数据,包括requests请求、数据解析及CSV保存。接着利用pandas处理数据,通过pyecharts库生成成交量柱状图,实现股票数据的可视化展示,适合Python初学者参考。
本文介绍如何使用Python语言结合requests和json库,从QQ音乐网站抓取指定歌手的歌曲清单。通过解析网页请求头、分析API参数及编写自动化脚本,实现以CSV格式输出歌曲数据。文章包含详细操作步骤、完整代码示例及运行结果分析,帮助开发者掌握基础的网络爬虫技能。
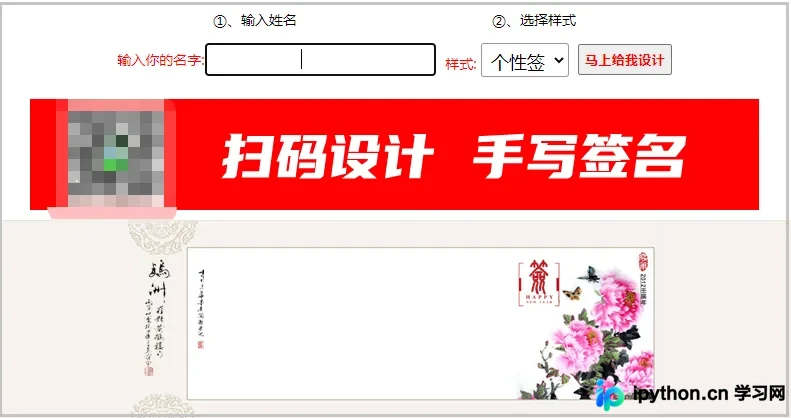
本文介绍如何使用Python结合Tkinter库与网络爬虫技术,开发一个个性签名设计工具。通过解析在线签名网站的POST请求,获取用户输入并生成签名图片,同时处理输入校验与界面交互,最终打包为独立应用。
本文详细介绍如何利用Python的Requests库发送HTTP请求获取网页源码,并结合BeautifulSoup解析HTML结构以提取特定标签数据。通过分步示例,演示从环境配置、单页抓取到多页循环爬取的完整流程,帮助开发者快速掌握基础爬虫技术。