Scrapy框架中配置Cookie的三种有效方法
本文详细介绍在Scrapy框架中启用和管理Cookie的三种核心方法。首先解析settings.py中COOKIES_ENABLED参数的逻辑陷阱;其次演示如何在中间件process_request中动态注入Cookie;最后讲解在Spider的start_requests中通过Request对象传递自定义Cookie。适用于Python3.6及以上版本,帮助开发者解决爬虫登录状态保持及页面获取失败的问题。
2026-10-14
6

本文详细介绍在Scrapy框架中启用和管理Cookie的三种核心方法。首先解析settings.py中COOKIES_ENABLED参数的逻辑陷阱;其次演示如何在中间件process_request中动态注入Cookie;最后讲解在Spider的start_requests中通过Request对象传递自定义Cookie。适用于Python3.6及以上版本,帮助开发者解决爬虫登录状态保持及页面获取失败的问题。
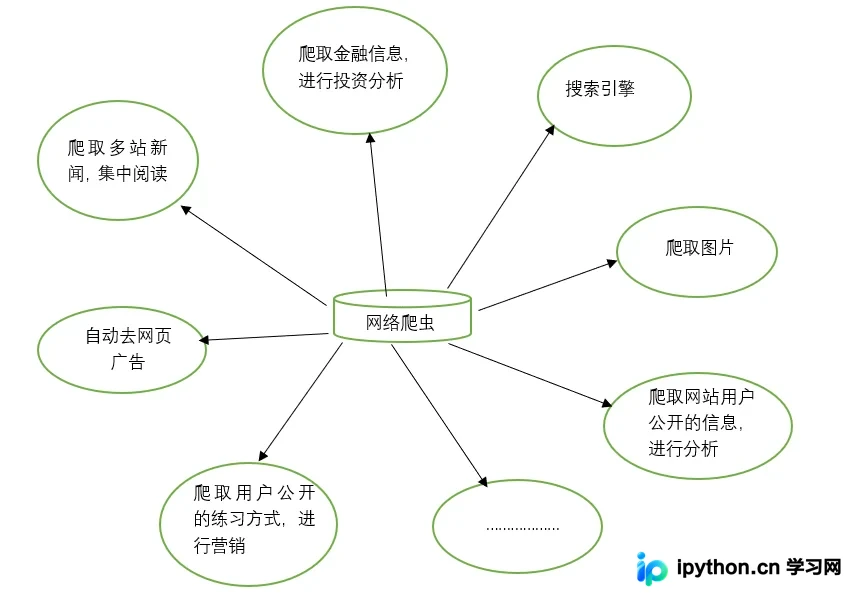
本文详细介绍Python网络爬虫的基础概念与核心功能,涵盖搜索引擎、图片抓取、金融分析及营销数据采集等应用场景。教程演示如何在Windows环境下通过pip安装requests第三方库,并提供完整的Python代码示例,展示如何获取淘宝首页HTML源码及使用BeautifulSoup进行初步数据解析,同时强调爬取频率控制与法律合规性注意事项。
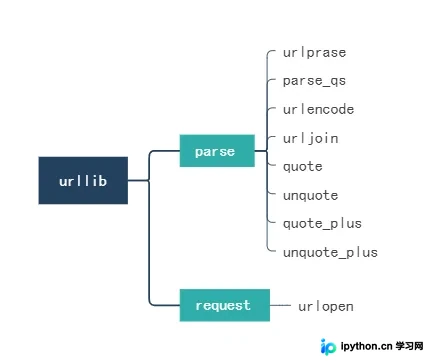
本文深入解析Python内置模块urllib,重点介绍urlparse、parse_qs、urlencode、quote及unquote等核心方法。通过实际代码示例,展示如何拆分URL、处理查询参数、进行字符编码与解码,帮助开发者高效处理网络请求中的URL操作。
本文详细介绍Python中requests模块的安装与基础用法,涵盖指定URL、参数处理、发起请求及数据持久化存储的完整流程。通过百度翻译POST请求案例演示UA伪装技巧,并结合搜狗首页GET请求案例,讲解如何获取网页源码并保存为本地文件,帮助开发者快速掌握网络爬虫核心技能。
本文以51CTO博客为例,详细介绍如何使用Python进行网页数据爬取。通过安装Python 3.7及requests、bs4模块,结合清华镜像加速下载,编写代码抓取博客标题与阅读量,并将结果保存至本地文本文件,为初学者提供完整的实战案例。
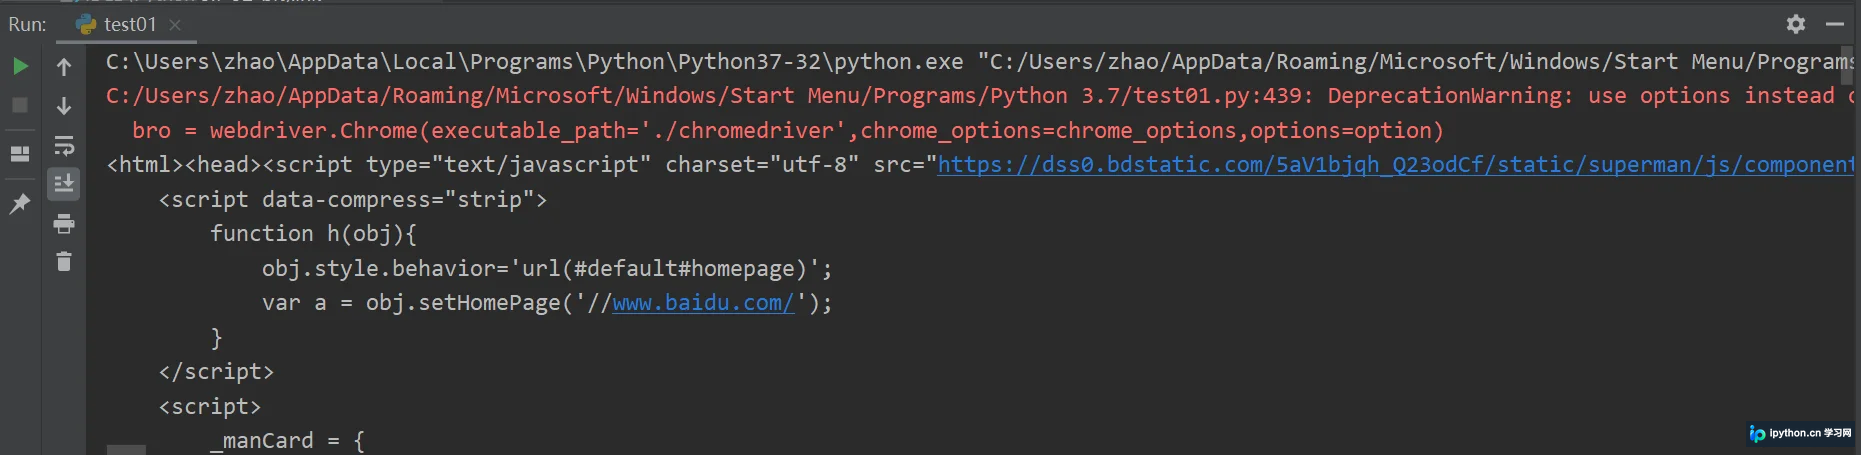
本文详解如何在 Python 中使用 Selenium 配置无头模式(Headless)以隐藏运行过程,并介绍通过 ChromeOptions 添加实验性参数来规避自动化检测的方法。包含完整代码示例及运行效果说明,帮助开发者实现高效且隐蔽的网页数据抓取。
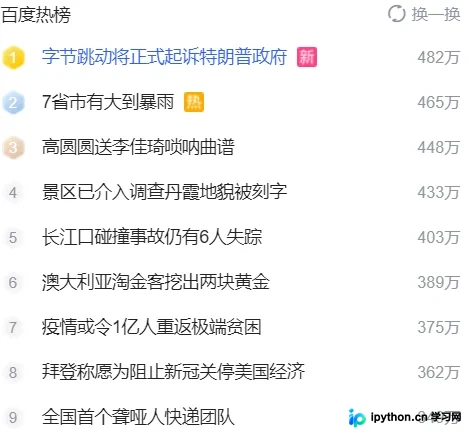
本文详细介绍如何利用Python获取百度首页热榜关键词,并通过构造特定URL参数生成对应的搜索链接。同时,文章扩展讲解了使用requests和lxml库抓取百度搜索结果标题、摘要及链接的完整代码实现,涵盖请求头设置、参数解析及数据提取技巧,帮助开发者掌握基础的网络数据采集方法。
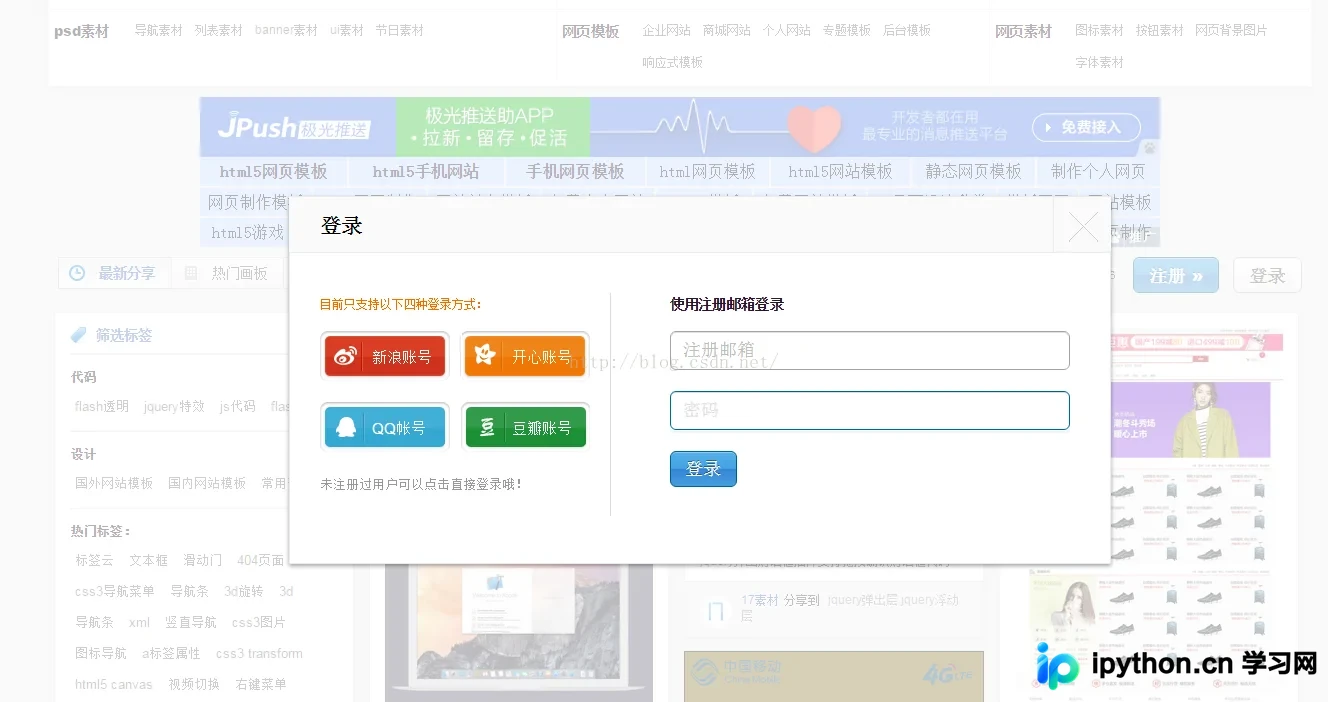
本文介绍如何利用Python编写爬虫程序,结合Fiddler工具分析网络请求,实现特定素材网站的自动登录与每日签到功能。通过抓取登录接口和签到接口的参数及Cookie,程序可模拟用户操作自动获取积分,并可通过Windows任务计划实现定时运行,解决手动签到繁琐的问题。
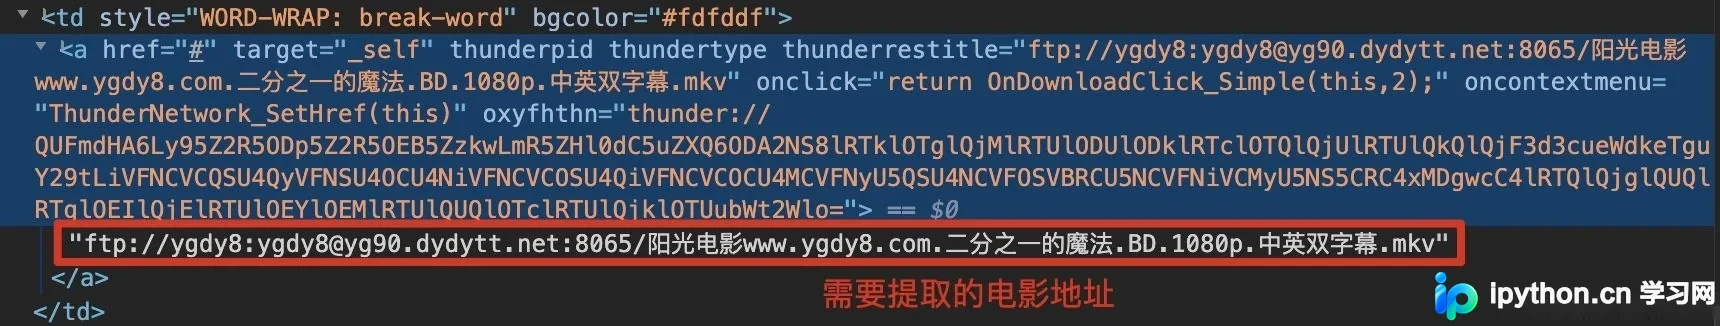
本文介绍如何利用 Python 的 re 和 requests 模块,通过正则表达式从网页 HTML 中快速提取电影 FTP 下载地址。相比繁琐的标签遍历,正则匹配能显著减少代码量并提高提取效率。文章包含完整的代码示例、编码处理技巧及运行结果分析,帮助开发者掌握高效的网页信息抓取方法。
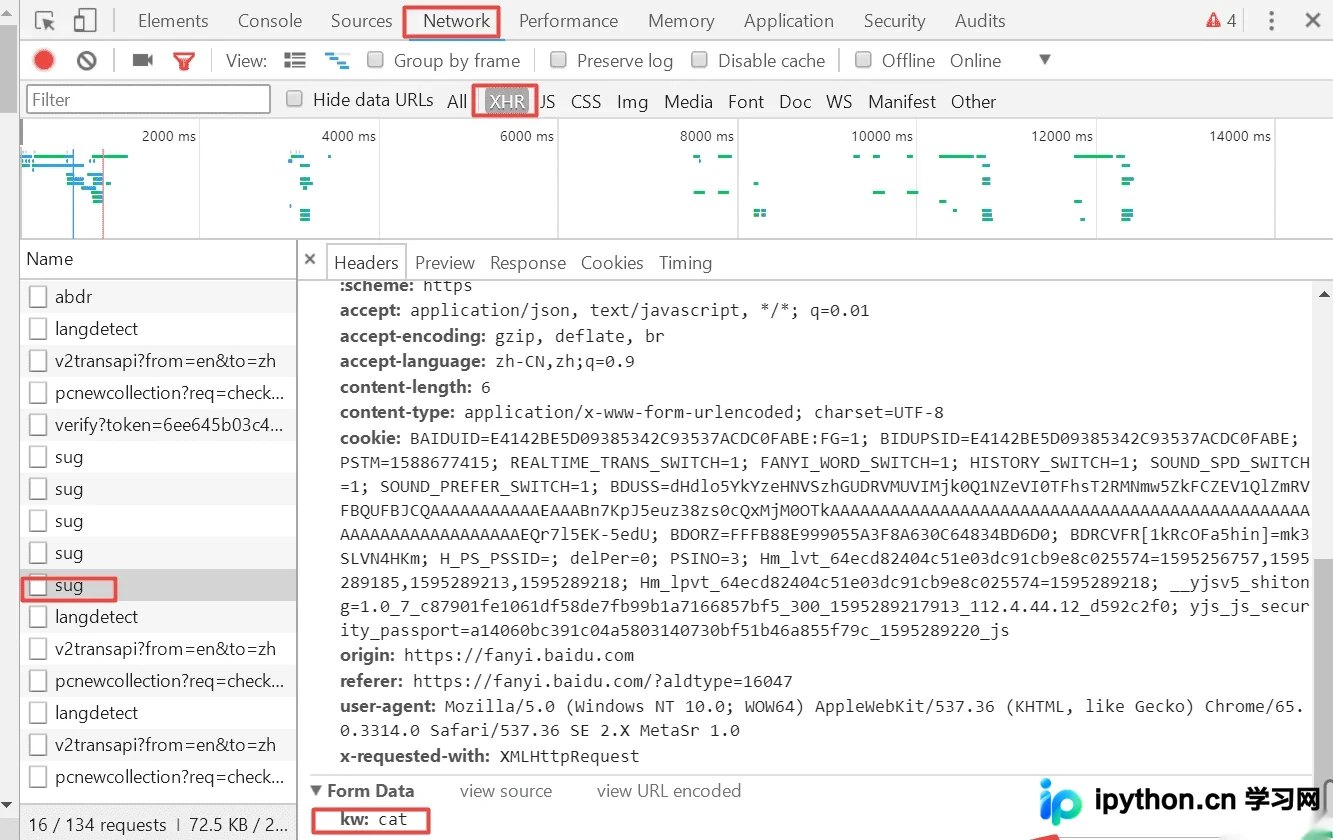
本文详解Python爬虫中动态加载数据的识别与抓取方法。通过浏览器开发者工具分析网络请求,定位非URL直接返回的数据接口,利用requests发送请求并解析JSON数据,解决商品价格等动态内容无法直接获取的问题。
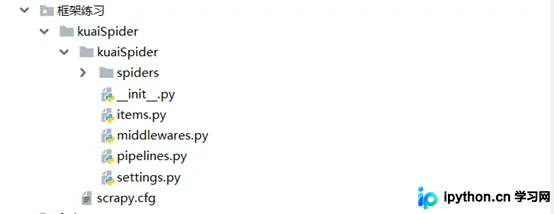
本文深入解析Python Scrapy框架的核心架构与工作流程。Scrapy基于Twisted异步网络库,由引擎、调度器、下载器、爬虫及管道等组件协同工作,高效实现网页数据抓取。文章详细阐述了各组件职责,并提供了从创建项目到生成爬虫的完整命令示例,帮助开发者快速掌握这一强大爬虫工具的基础应用。
本文详解如何使用Python爬虫实现GitHub网页的模拟登录。通过浏览器开发者工具分析登录请求,提取Form Data中的动态参数authenticity_token、login及password,利用requests.Session保持会话状态,发送POST请求完成登录,并成功提取登录后的页面信息如注册号码。