

Python Selenium 实现无头浏览器与反检测配置详解

发布时间:2026-10-14| 5人浏览过
本文详解如何在 Python 中使用 Selenium 配置无头模式(Headless)以隐藏运行过程,并介绍通过 ChromeOptions 添加实验性参数来规避自动化检测的方法。包含完整代码示例及运行效果说明,帮助开发者实现高效且隐蔽的网页数据抓取。
Selenium 无界面模式与反检测配置
无界面模式的核心价值
在进行网页数据抓取时,许多场景下无需关注中间过程,仅需获取最终数据结果。此时,启用无界面模式显得尤为必要。
具体实现代码如下:
from selenium import webdriver
from time import sleep
#实现无可视化界面
from selenium.webdriver.chrome.options import Options
#实现规避检测
from selenium.webdriver import ChromeOptions

#实现无可视化界面的操作
chrome_options = Options()
chrome_options.add_argument('--headless')
chrome_options.add_argument('--disable-gpu')

#实现规避检测
option = ChromeOptions()
option.add_experimental_option('excludeSwitches', ['enable-automation'])

#如何实现让selenium规避被检测到的风险
bro = webdriver.Chrome(executable_path='./chromedriver',chrome_options=chrome_options,options=option)

#无可视化界面(无头浏览器) phantomJs
bro.get('https://www.baidu.com')

print(bro.page_source)
sleep(2)
bro.quit()
程序运行后的输出效果如下:
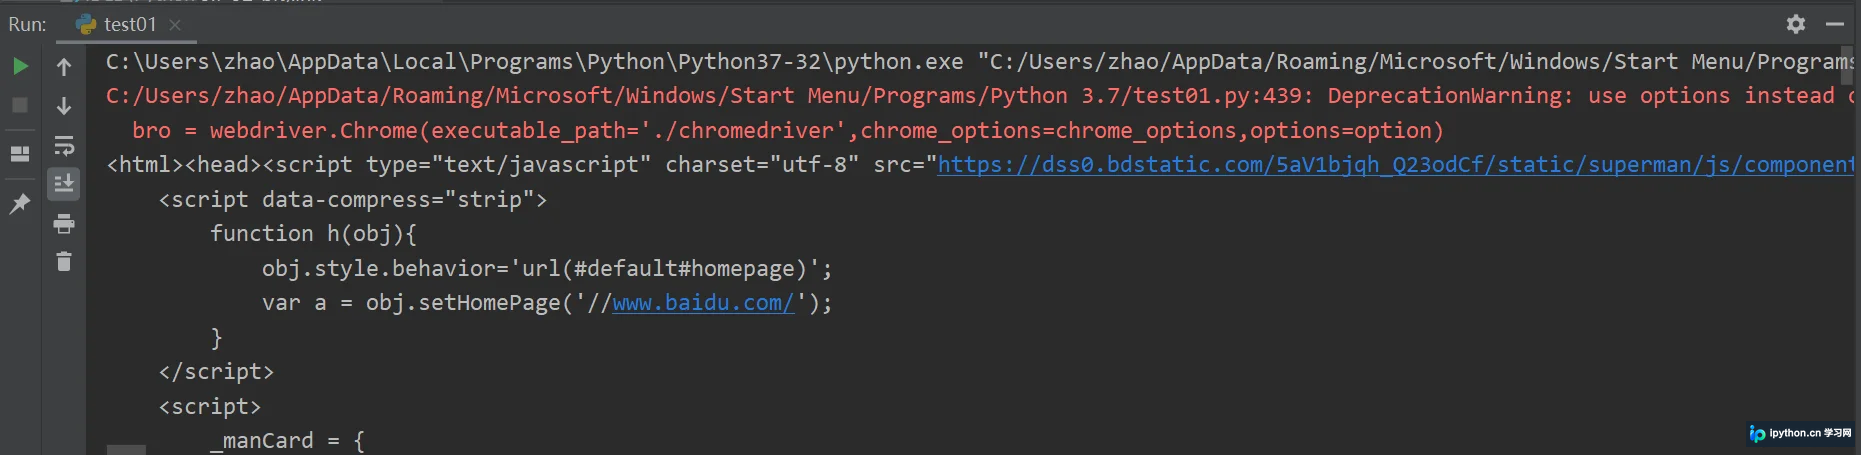
控制台成功打印出网页源码,证实网站信息爬取操作已完成。
以上内容为本文的全部分享,旨在为读者提供实用参考。若觉得有帮助,欢迎继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









