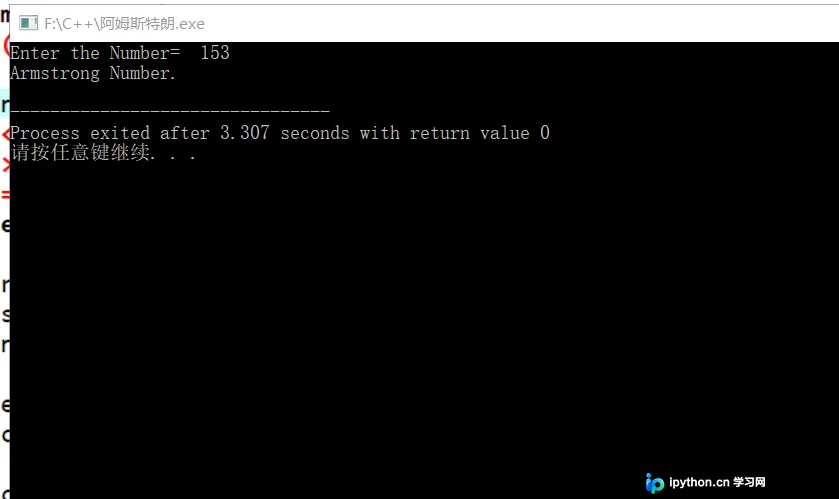
C++与Python实现阿姆斯特朗数判断及范围查找
本文介绍了阿姆斯特朗数的定义,即一个n位正整数等于其各位数字的n次方之和。文章提供了C++和Python两种语言的实现代码,分别用于判断单个数字是否为阿姆斯特朗数,以及查找指定范围内的所有阿姆斯特朗数。通过对比两种语言的实现方式,帮助读者理解算法逻辑并掌握相关编程技巧。
2026-10-14
7

本文介绍了阿姆斯特朗数的定义,即一个n位正整数等于其各位数字的n次方之和。文章提供了C++和Python两种语言的实现代码,分别用于判断单个数字是否为阿姆斯特朗数,以及查找指定范围内的所有阿姆斯特朗数。通过对比两种语言的实现方式,帮助读者理解算法逻辑并掌握相关编程技巧。
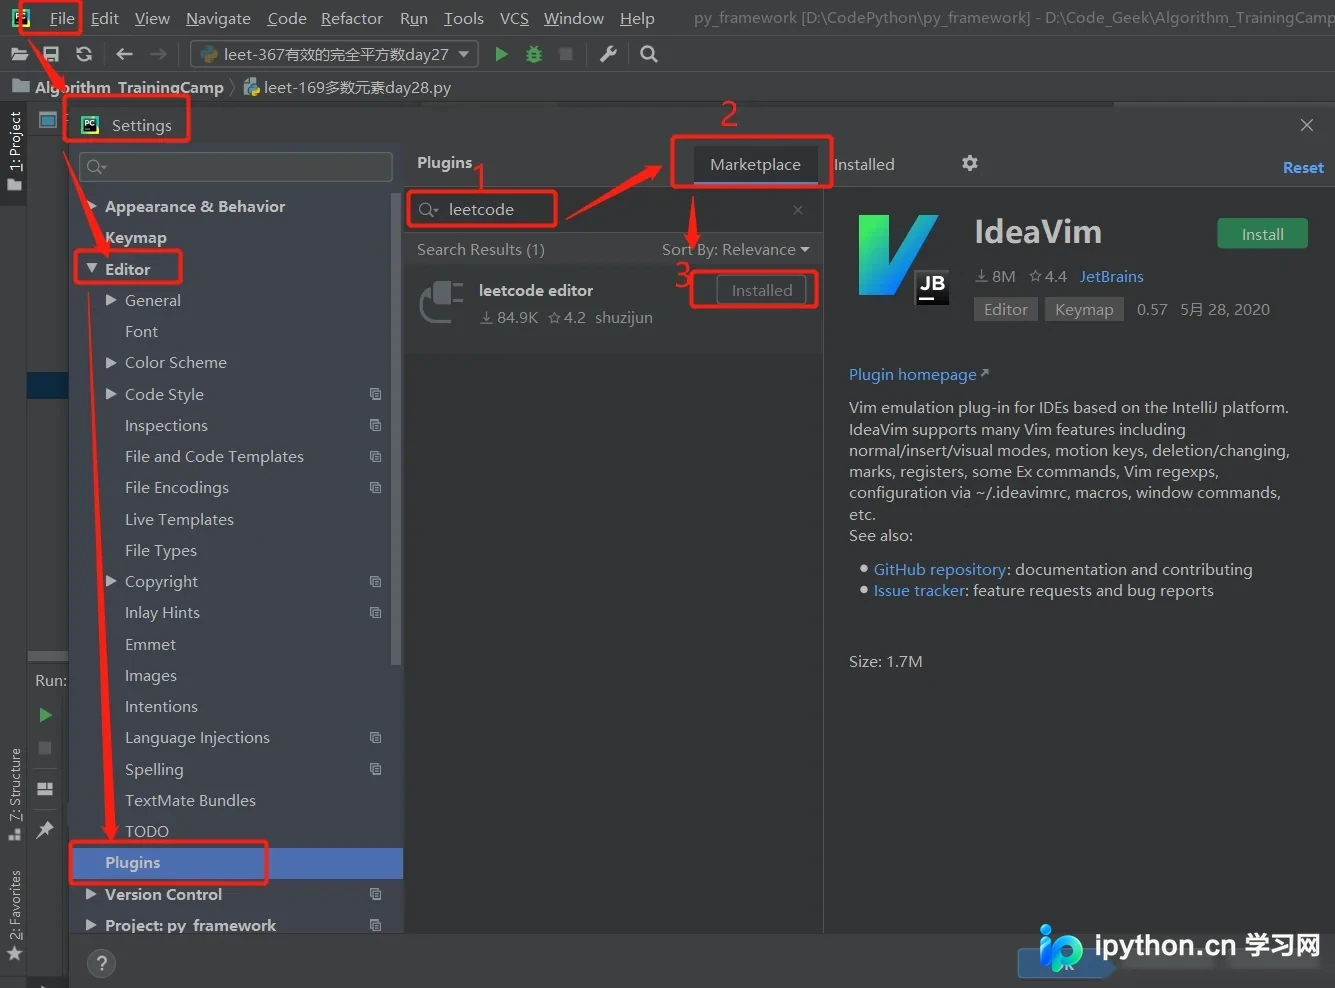
本文详细介绍在PyCharm中安装和使用LeetCode插件的完整流程。内容涵盖插件安装、IDE重启、账号登录配置、题库浏览、本地编码调试以及代码提交测试等关键步骤,帮助开发者在熟悉的IDE环境中高效进行算法练习与在线评测。
本文介绍如何使用Python生成文件字符串的MD5值并进行去重处理。由于MD5存在碰撞风险,不同内容可能产生相同哈希值。通过示例演示从生成128位MD5字符串到自动去重写入新文件的全过程,帮助开发者理解哈希校验与数据清洗的实际应用。
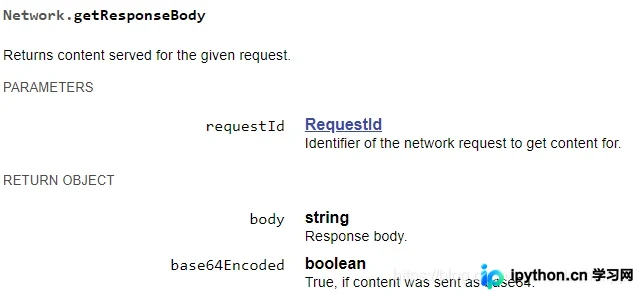
本文介绍如何在 Python Selenium 中通过 Chrome DevTools Protocol (CDP) 获取接口数据。Selenium 本身不提供直接查询接口响应的方法,但可通过配置性能日志(performance logging)捕获 requestid,进而调用 Network.getResponseBody 命令提取特定 URL 的完整响应内容。
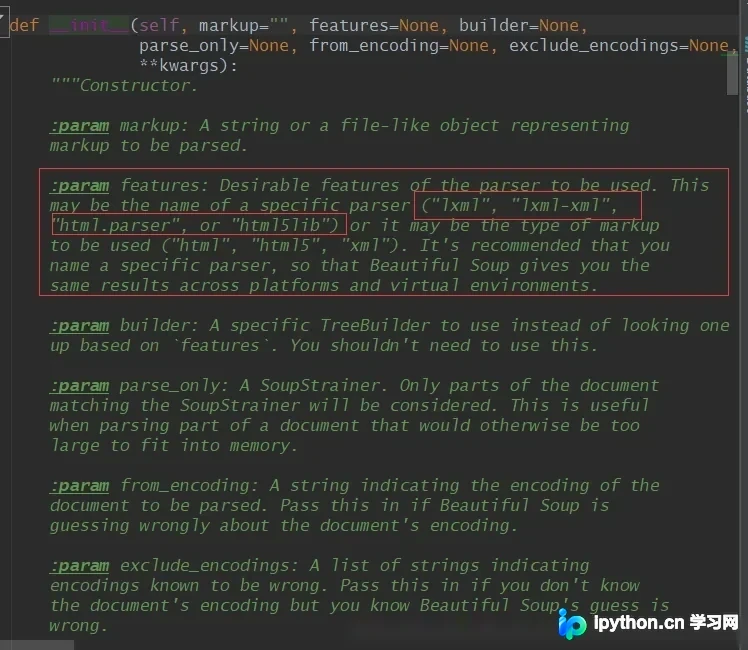
本文详细介绍Python中BeautifulSoup库的核心查找方法find和find_all。通过构建实例、解析HTML结构,演示如何精准定位标签、提取文本与属性。重点讲解处理class关键字冲突的技巧,以及find_all在批量提取数据时的灵活应用,帮助开发者高效完成网页数据抓取任务。
本文详解在Python Selenium中如何利用XPath根据元素文本内容精准定位元素。针对无固定ID或Class的场景,深入解析text()精确匹配与contains()模糊匹配两种核心方法,并附带完整代码示例,帮助开发者解决动态页面元素查找难题。
本文详解在Python爬虫中获取指定class样式的div标签的三种方法。对比字符串查找与正则表达式的局限性,重点介绍BeautifulSoup库的使用技巧。通过字典形式赋值attrs参数解决官方文档示例无效的问题,并提供完整代码示例及图片下载实战,帮助开发者高效准确提取网页数据。
本文详解如何在 Python3 环境中利用 pybind11 调用 C++ 的 Eigen 库以解决循环计算性能瓶颈。内容涵盖从虚拟环境配置、依赖库安装到 C++ 代码编写、Python 接口定义及编译测试的全流程步骤,提供具体的代码示例与操作命令,帮助开发者实现高效的矩阵运算加速。
本文介绍如何使用Python结合xlwings库实现Excel表格的自动查重功能。通过读取指定列数据并比对,程序可自动高亮标记重复行,解决人工核对效率低的问题。此外,文章详细讲解了利用PyInstaller将Python脚本打包为独立EXE可执行文件的方法,方便无Python环境的办公电脑直接使用,提升数据处理效率。
本文介绍当Selenium的.text方法无法直接获取Script标签内的JSON数据时,如何结合BeautifulSoup提取源码,并通过json模块将字符串转换为字典对象,从而精准获取嵌套数据。
本文详细介绍如何在Windows环境下,利用pybind11将C++的Eigen库集成到Python项目中,以解决Python循环计算性能瓶颈。内容涵盖从环境准备、虚拟环境配置、依赖库安装到C++代码编写、Python接口定义及最终编译测试的完整步骤,帮助开发者实现高效的矩阵运算加速。
本文介绍如何在Django项目中集成LDAP实现统一用户登录验证,解决多平台账号管理难题。重点讲解Windows环境下Python-ldap库的安装避坑指南,以及settings.py中AUTHENTICATION_BACKENDS和LDAP连接参数的具体配置方法,帮助开发者快速实现基于LDAP的后端验证。