初学者入门python机器学习应优先掌握哪些库
从Python基础与数据处理出发,梳理初学者进入机器学习阶段最值得优先掌握的核心库,明确各库的定位、学习顺序、基本操作与验证方法,避免一开始堆砌过多工具导致学习成本过高。
2026-09-08
11

从Python基础与数据处理出发,梳理初学者进入机器学习阶段最值得优先掌握的核心库,明确各库的定位、学习顺序、基本操作与验证方法,避免一开始堆砌过多工具导致学习成本过高。
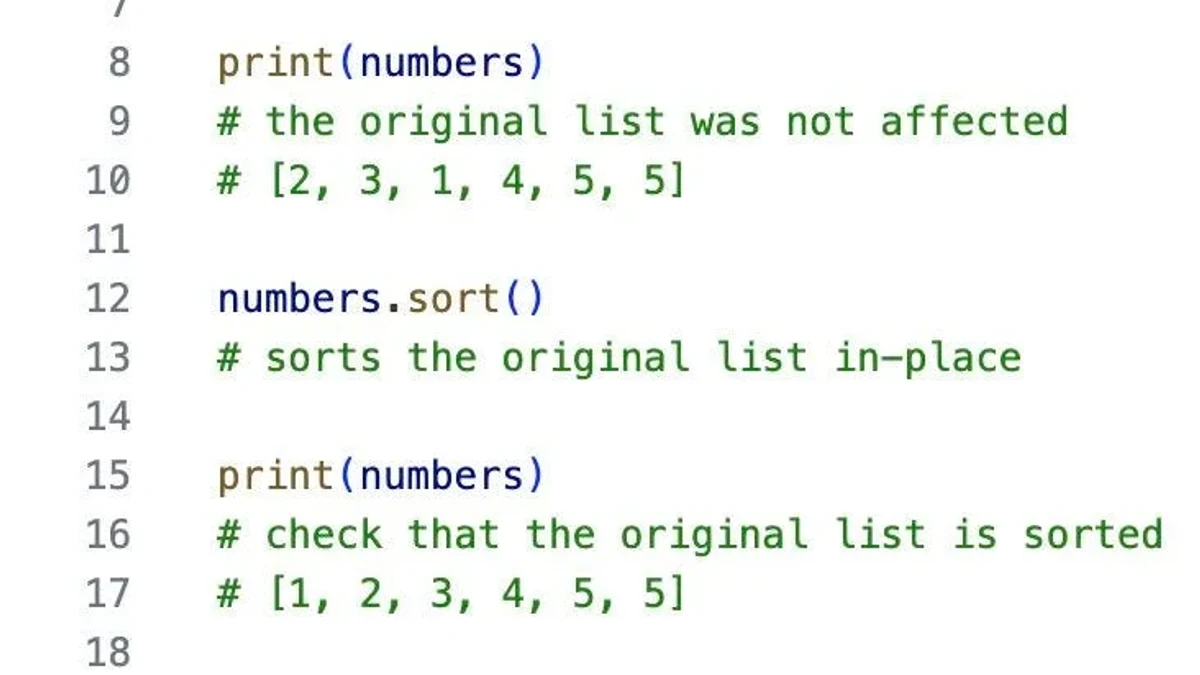
围绕Python列表排序,系统对比sort()方法与sorted()函数在返回值、是否修改原列表、使用场景和参数上的差异,并通过代码验证常见排序效果,帮助初学者避免误用。
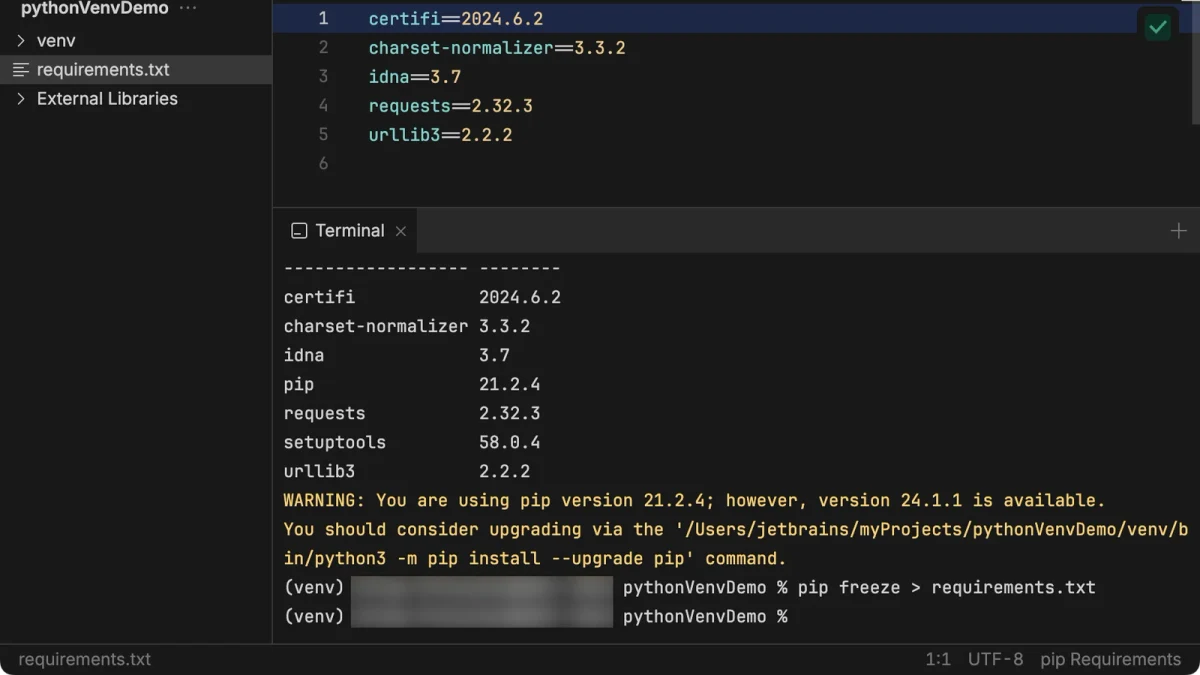
换电脑后,Python项目最耗时的往往不是重新安装Python,而是准确恢复原环境中的第三方依赖。通过导出依赖清单、安装匹配版本、处理系统与Python版本差异,并进行项目验证,可以更快完成环境迁移,减少版本冲突和遗漏依赖。
针对无法联网或网络受限的开发环境,介绍如何准备本地Python手册、快速检索API与标准库文档,并通过版本核对和实际运行验证避免查错文档。
从官方文档、开源示例和完整小游戏项目入手,找到适合初学者的Pygame基础代码,并通过运行、拆解和修改验证代码是否真正适合自己的学习需求。
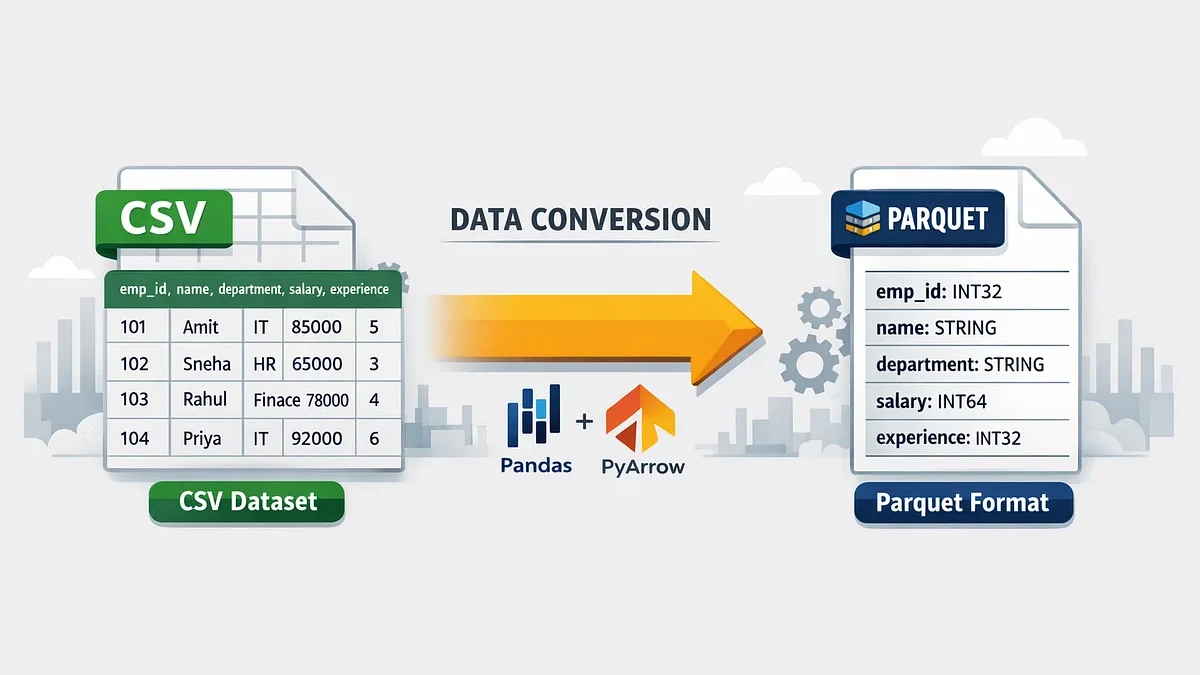
面对数GB甚至更大的CSV文件,Python数据导入常见瓶颈并不只来自文件读取,还涉及解析方式、内存占用、数据类型推断、磁盘与CPU吞吐等环节。本文将从性能定位、导入方式优化、内存控制和结果验证几个方面,系统分析大规模CSV导入中的常见问题与优化方法。
围绕零基础学习者的实际需求,从教材难度、内容体系、实战项目、配套资源和学习路径等维度比较Python教材,帮助读者根据学习目标选到更适合自己的书,并避开只重语法、项目过时或难度不匹配等常见误区。
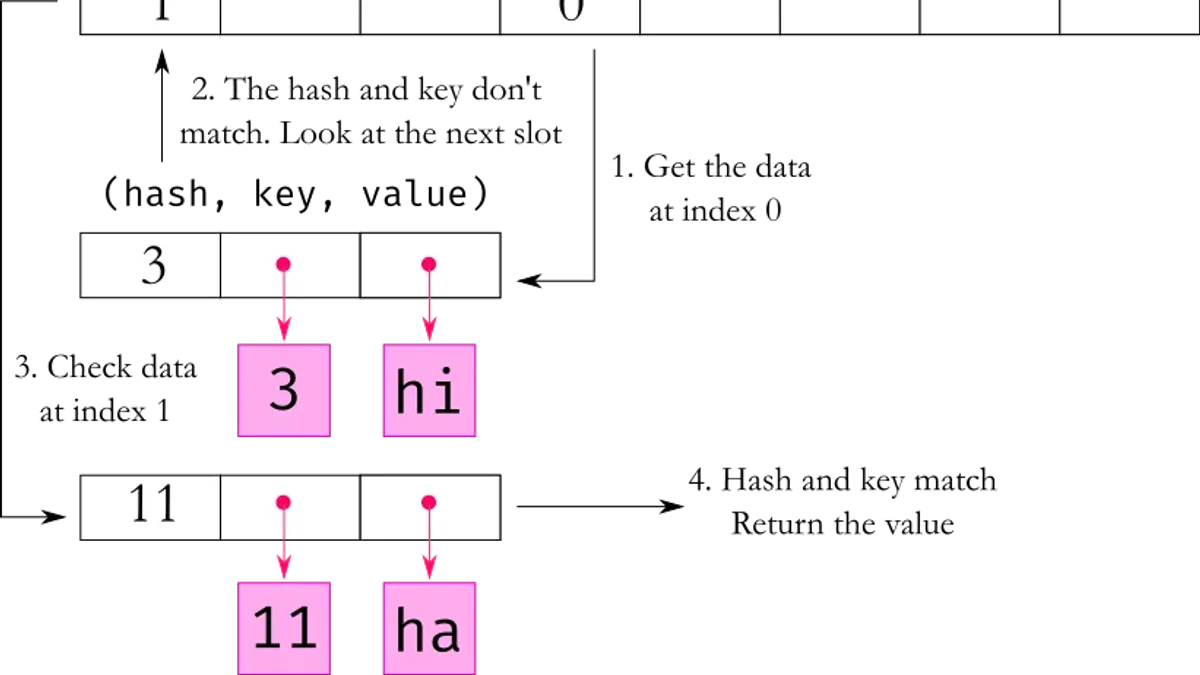
从对象内存布局、存储结构、扩容机制、哈希查找等角度拆解Python列表与字典的底层实现,并通过代码验证常见操作的性能与行为,帮助读者理解“为什么这样设计”以及实际开发中的避坑方法。
介绍 Python 交互式解释器的作用,并对比 IDLE 与终端两种进入方式,帮助初学者选择合适的调试环境,同时掌握启动、执行代码、退出及常见问题的处理方法。
围绕 Python 串口开发在 Windows、Linux、macOS 等平台上的实际差异,对主流串口库的系统兼容性、API 特性、通信性能、异常处理与工程选型进行对比,并通过统一测试方法帮助开发者验证库的表现、规避常见兼容性问题。
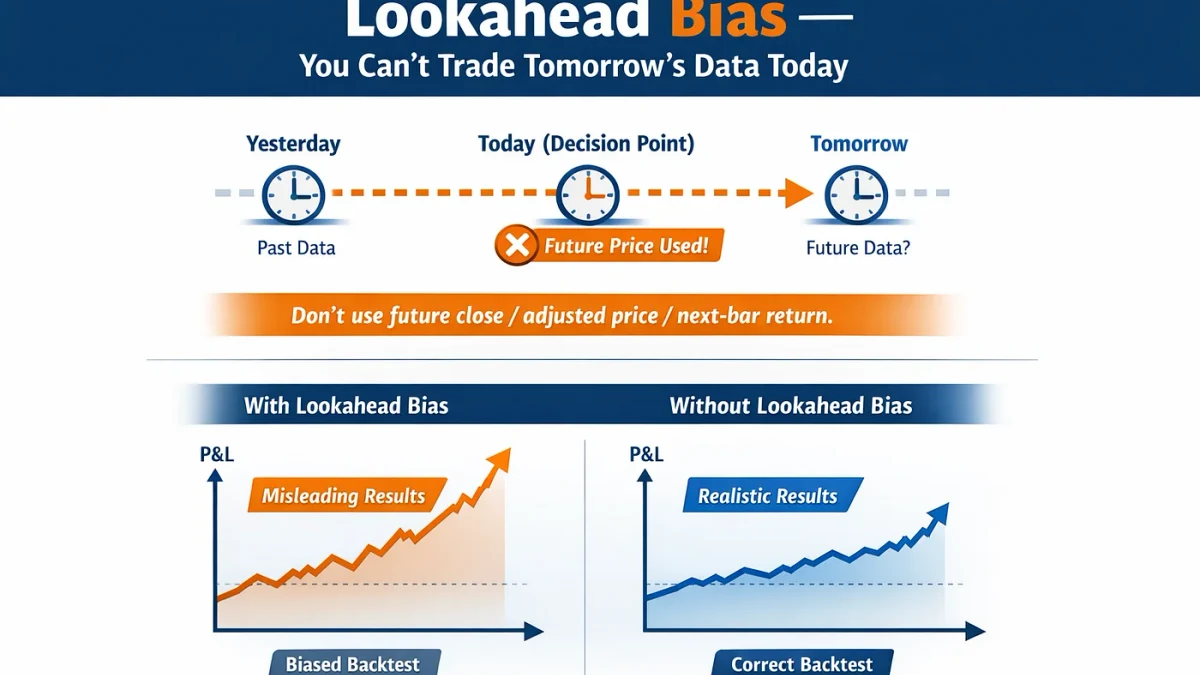
从量化交易入门、策略研究到回测与社区交流,系统整理值得关注的Python开源库和学习资源,并结合项目维护状态、适用场景与常见风险,帮助读者按需求选择工具,避免只看热门项目而忽略实际可用性。
系统梳理Python常见运算符的优先级与结合性,结合表达式执行顺序、括号控制和实际代码验证,帮助读者准确判断复杂表达式的计算结果并避免因优先级误判产生的常见错误。