

Python IDLE 使用指南:从安装到调试的全流程解析
本文详细介绍 Python 官方自带的 IDLE 集成开发环境。内容涵盖 IDLE 的安装注意事项、启动方式、编辑器核心功能(自动缩进、语法高亮、单词补全)、程序运行与保存方法,以及调试器的使用技巧。旨在帮助初学者高效掌握 Python 基础开发流程。
2026-10-13
9

本文详细介绍 Python 官方自带的 IDLE 集成开发环境。内容涵盖 IDLE 的安装注意事项、启动方式、编辑器核心功能(自动缩进、语法高亮、单词补全)、程序运行与保存方法,以及调试器的使用技巧。旨在帮助初学者高效掌握 Python 基础开发流程。
本文系统梳理 Python NumPy 库的核心功能,涵盖数组创建、维度变换、组合分割、修剪压缩及统计计算等常用函数。详细解析 where、reshape、concatenate、clip 等关键方法的参数与用法,帮助开发者高效掌握 NumPy 在科学计算与数据处理中的实际应用。
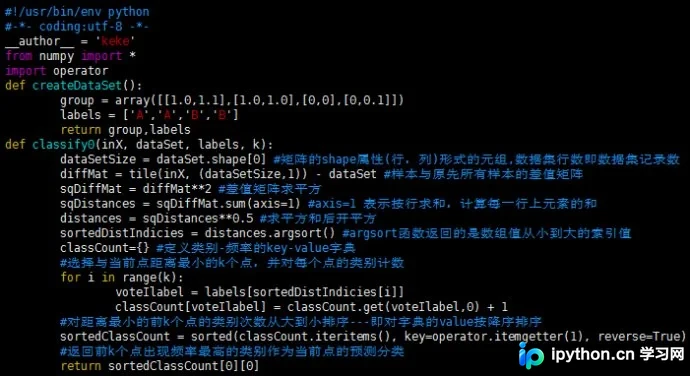
本文深入解析K-近邻算法(KNN)的工作原理、优缺点及适用场景,详细阐述其从计算距离到确定分类的五步实现流程。通过Python代码示例展示如何构建分类器,并介绍利用错误率评估模型性能的方法,帮助开发者快速掌握KNN的核心技术与实战应用。
本文介绍使用Python抓取亚马逊书籍基本信息的完整流程。通过构造包含node参数的GET请求获取搜索结果页,利用正则表达式解析书名、作者、封面等字段,并将结果写入MySQL数据库。代码展示了从请求构造到数据入库的核心逻辑,适用于需要批量采集书籍元数据的场景。
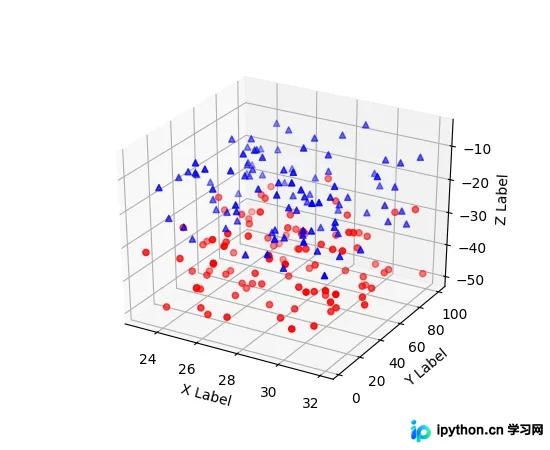
本文详细介绍如何在Python中使用matplotlib库绘制3D散点图。通过导入必要的第三方包,利用Axes3D创建三维坐标轴,并演示如何生成随机数据及设置点的颜色、形状和坐标标签。包含完整的代码示例与效果解析,帮助开发者快速掌握三维数据可视化技巧。
本文通过Python代码详细演示线性回归的三种应用场景:基于房屋面积预测房价、对比《闪电侠》与《绿箭侠》的下一集观众数量,以及利用线性回归填补数据集中的缺失值。文章提供完整的代码示例、数据预处理步骤及模型训练结果解析,帮助读者掌握线性回归的实际编程技巧。
本文详解Python中Matplotlib库绘制散点图的方法。通过scatter()函数展示单点绘制、批量数据生成及样式设置,包括标题、标签和刻度调整。进一步介绍利用axis()控制坐标范围,以及通过cmap参数实现基于数据值的颜色渐变效果,帮助读者掌握可视化核心技巧。
本文介绍Python中用于统计序列元素出现频率的Counter类。通过示例演示如何利用collections模块中的Counter类,结合most_common()方法快速获取列表或字符串中出现次数最多的元素。同时讲解了Counter对象支持加减运算的高级功能,适用于词频统计等数据分析场景。
本文详解Python中capitalize()与title()两个字符串方法的区别。capitalize()仅将字符串第一个字符转为大写,而title()会将字符串内所有单词的首字母大写。文章通过代码示例展示了普通字符串及非字母开头字符串在两种方法下的不同输出结果,帮助开发者准确选择合适的方法。
本文介绍如何使用Python实现基于二叉树存储结构的堆排序算法。与常见的数组实现不同,该方法通过显式构建二叉树节点来管理数据,重点解决了节点间复杂的交换逻辑。文章提供了完整的Tree类代码示例及运行结果,适合希望深入理解树结构排序原理的开发者参考。
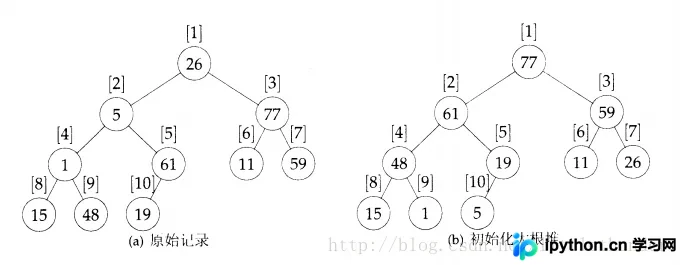
本文深入解析Python中的堆排序算法,通过大顶堆特性演示排序过程。详细讲解了基于堆的优先队列实现,包括fixUp和fixDown函数的调整逻辑,以及完整的堆排序代码示例,帮助开发者掌握排序搜索基本算法。
本文介绍在Python数据分析中,如何利用字典或Series对象对DataFrame进行自定义分组。通过示例演示了groupby方法在列方向上的应用,展示了如何将多个列映射到同一组别(如red、blue)并执行聚合计算。对比发现字典与Series分组原理一致,均通过键值匹配实现数据归类,为灵活处理复杂数据结构提供了实用方案。