

K-近邻算法(KNN)原理详解与Python实现指南

本文深入解析K-近邻算法(KNN)的工作原理、优缺点及适用场景,详细阐述其从计算距离到确定分类的五步实现流程。通过Python代码示例展示如何构建分类器,并介绍利用错误率评估模型性能的方法,帮助开发者快速掌握KNN的核心技术与实战应用。
K-近邻算法概述
K-近邻算法(KNN)的全称为K-Nearest Neighbors Algorithms,其核心思想是通过计算不同特征值之间的距离来进行数据分类。
从定义角度来看,K近邻算法是指给定一个带有标签的训练数据集,当面对一个新的输入实例时,算法会在训练数据集中寻找与该实例最接近的K个实例(即所谓的“K个邻居”)。如果这K个实例中大多数属于某一个特定的类别,那么就将该新输入实例划分到该类别中。
k-近邻算法分析
该算法的优势在于预测精度较高,对异常值具有较强的鲁棒性,且在对数据输入分布做出任何假设方面没有要求。
然而,其缺点也较为明显:计算复杂度较高,且随着数据量增加,空间复杂度也会显著上升。
该算法适用于处理数值型数据和标称型数据。
k-近邻算法工作原理
KNN的工作机制如下:首先存在一个包含标签的样本数据集合(即训练样本集),其中每个数据点都对应一个已知的分类标签。当输入一个没有标签的新数据时,算法会将新数据的各个特征与训练集中所有数据的对应特征进行比较。随后,算法会提取出训练集中与新数据特征最相似(即距离最近)的数据点的分类标签。通常情况下,我们只考虑训练集中前k个最相似的数据点,这里的k通常是一个不超过20的整数。最终,算法统计这k个最相似数据点中出现频率最高的类别,并将其作为新数据的预测分类结果。
k-近邻算法实现过程
对于未知类别的数据集中的每一个数据点,依次执行以下操作步骤:
(1) 计算已知类别数据集中的所有点与当前待分类点之间的距离;
(2) 按照距离从小到大的顺序对这些距离进行排序;
(3) 选取与当前点距离最小的前k个点;
(4) 统计这前k个点所在类别的出现频率;
(5) 返回前k个点中出现频率最高的类别,作为当前点的预测分类结果。
k-近邻算法python代码实现
编辑kNN.py文件,具体代码如下:
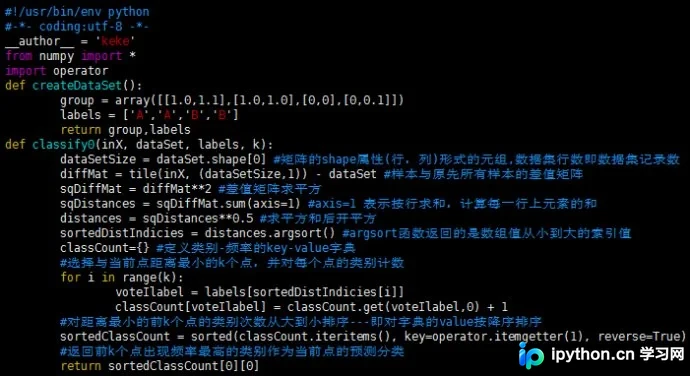
保存编辑后的文件。在Linux环境下,确保当前工作路径为存储kNN.py文件的位置,随后进入Python开发环境进行代码测试:
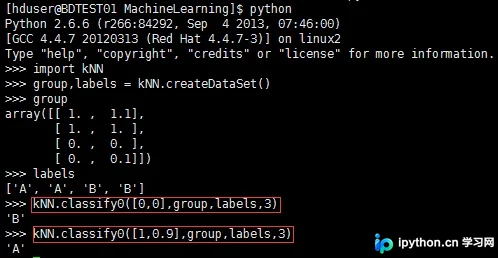
上图展示了点[0,0]和[1,0.9]的测试输出,其分类结果分别为B和A。至此,我们已经成功构建了一个分类器,利用该分类器可以执行多种分类任务。基于此实例,进一步构建使用分类算法的应用将变得更加简便。
分类器测试评估
为了验证分类器的实际效果,必须对其进行评估。我们可以通过大量测试数据来计算分类器的错误率,即分类器给出错误结果的次数除以测试执行的总次数。错误率是评估分类器在特定数据集上执行效果的常用指标。完美分类器的错误率为0,而最差分类器的错误率为1.0,这意味着分类器完全无法找到正确答案。
结束语
本文首先对kNN进行了简要介绍,通过解析其工作原理和实现流程,并利用k-近邻算法成功构造了分类器。我们还可以检验分类器给出的答案是否符合预期,此外,通过对分类器进行大量测试,并以错误率为指标来评估其分类效果。
以上就是本文关于K-近邻算法的python实现代码分享的全部内容,希望对大家有所帮助。感兴趣的朋友可以继续参阅本站其他相关专题。如有不足之处,欢迎留言指出。感谢朋友们对本站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









