

Python线性回归实战:房价预测、剧集收视分析与缺失值填补

本文通过Python代码详细演示线性回归的三种应用场景:基于房屋面积预测房价、对比《闪电侠》与《绿箭侠》的下一集观众数量,以及利用线性回归填补数据集中的缺失值。文章提供完整的代码示例、数据预处理步骤及模型训练结果解析,帮助读者掌握线性回归的实际编程技巧。
在开始编写代码之前,我们先明确本文要解决的实际问题案例。
1) 预测房屋价格
房价是许多普通民众关注的焦点,近年来房价波动对收入的影响日益显著。
我们的目标是根据房屋面积来预测特定房屋的市场价值。
2) 预测下周电视节目观众数量
《闪电侠》和《绿箭侠》是我喜爱的剧集,尤其是《绿箭侠》,我曾追剧至深夜,后因故中断。现在我想预测下周哪部节目的观众人数更多。
3) 使用线性回归填补缺失值
处理包含缺失值的数据集是常见任务。虽然此处没有具体案例,但将演示如何利用线性回归算法来估算并替换这些缺失数据。
接下来,我们直接进入编程环节。
在动手编码前,建议先安装我之前文章《Python数据挖掘包》中提到的相关程序库。
1) 预测房屋价格
我们使用以下数据集进行演示:
| 输入编号 | 平方英尺 | 价格 |
|---|---|---|
| 1 | 150 | 6450 |
| 2 | 200 | 7450 |
| 3 | 250 | 8450 |
| 4 | 300 | 9450 |
| 5 | 350 | 11450 |
| 6 | 400 | 15450 |
| 7 | 600 | 18450 |
操作步骤如下:
在线性回归中,我们需要在数据中寻找线性关系,从而计算出参数θ0和θ1。假设方程如下所示:
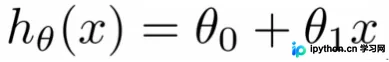
其中:hθ(x)代表特定面积对应的价格预测值(即我们要预测的目标变量),表示价格是面积的线性函数;θ0为截距常数;θ1为回归系数。
现在开始编写代码:
步骤1
打开你常用的文本编辑器,新建文件并命名为predict_house_price.py。我们需要在程序中导入以下库,请将相关代码复制到该文件中。
# Required Packages
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from sklearn import datasets, linear_model
运行代码。如果程序未报错,则步骤1完成。若遇到错误,通常是因为缺少依赖库,请检查并安装相关包后再次运行,确保无报错。
确认程序无误后,我们继续下一步。
步骤2
我将数据保存为名为input_data.csv的CSV文件。接下来编写一个函数,将数据转换为X值(房屋面积)和Y值(价格)。
# Function to get data
def get_data(file_name):
 data = pd.read_csv(file_name)
 X_parameter = []
 Y_parameter = []
 for single_square_feet ,single_price_value in zip(data['square_feet'],data['price']):
    X_parameter.append([float(single_square_feet)])
    Y_parameter.append(float(single_price_value))
 return X_parameter,Y_parameter
第3行:使用Pandas读取CSV数据到数据帧中。
第6-9行:将Pandas数据帧转换为X_parameter和Y_parameter变量,并返回这两个变量。
现在,我们打印出X_parameter和Y_parameter的值:
[[150.0], [200.0], [250.0], [300.0], [350.0], [400.0], [600.0]]
[6450.0, 7450.0, 8450.0, 9450.0, 11450.0, 15450.0, 18450.0]
[Finished in 0.7s]
脚本输出: [[150.0], [200.0], [250.0], [300.0], [350.0], [400.0], [600.0]] [6450.0, 7450.0, 8450.0, 9450.0, 11450.0, 15450.0, 18450.0] [Finished in 0.7s]
步骤3
接下来,我们将X_parameter和Y_parameter拟合到线性回归模型中。我们需要编写一个函数,输入参数为X_parameters、Y_parameter以及待预测的面积值,返回θ0、θ1和预测价格。
# Function for Fitting our data to Linear model
def linear_model_main(X_parameters,Y_parameters,predict_value):

 # Create linear regression object
 regr = linear_model.LinearRegression()
 regr.fit(X_parameters, Y_parameters)
 predict_outcome = regr.predict(predict_value)
 predictions = {}
 predictions['intercept'] = regr.intercept_
 predictions['coefficient'] = regr.coef_
 predictions['predicted_value'] = predict_outcome
 return predictions
第5-6行:首先创建线性回归对象,并使用X_parameters和Y_parameter对其进行训练。
第8-12行:创建一个名为predictions的字典,存储θ0(截距)、θ1(系数)和预测值,最后返回该字典。
现在调用该函数,设定待预测的房屋面积为700平方英尺。
X,Y = get_data('input_data.csv')
predictvalue = 700
result = linear_model_main(X,Y,predictvalue)
print "Intercept value " , result['intercept']
print "coefficient" , result['coefficient']
print "Predicted value: ",result['predicted_value']
脚本输出:Intercept value 1771.80851064 coefficient [ 28.77659574] Predicted value: [ 21915.42553191] [Finished in 0.7s]
此处,Intercept value(截距值)对应θ0,coefficient value(系数)对应θ1。我们得到的预测价格为21915.4255,至此完成了房价预测任务。
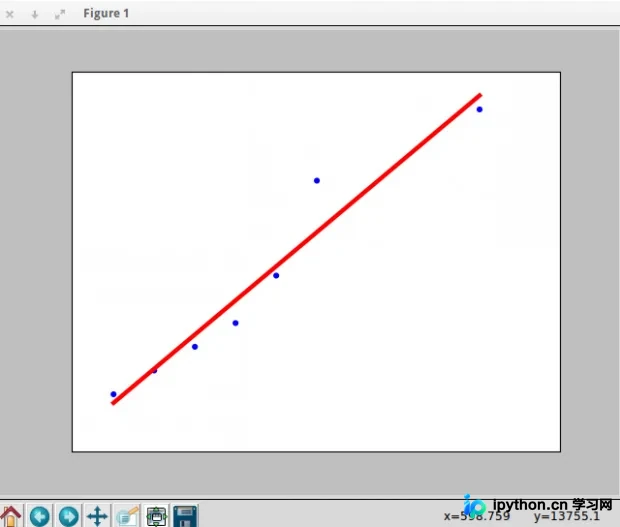
为了验证模型效果,我们需要观察数据与线性回归直线的拟合情况。因此,编写一个函数,输入X_parameters和Y_parameters,绘制拟合直线。
# Function to show the resutls of linear fit model
def show_linear_line(X_parameters,Y_parameters):
 # Create linear regression object
 regr = linear_model.LinearRegression()
 regr.fit(X_parameters, Y_parameters)
 plt.scatter(X_parameters,Y_parameters,color='blue')
 plt.plot(X_parameters,regr.predict(X_parameters),color='red',linewidth=4)
 plt.xticks(())
 plt.yticks(())
 plt.show()
调用show_linear_line函数:
show_linear_line(X,Y)
脚本输出:
2) 预测下周电视节目观众数量
《闪电侠》是由Greg Berlanti、Andrew Kreisberg和Geoff Johns创作,CW电视台播出的美国电视剧。该剧基于DC漫画角色闪电侠(Barry Allen),讲述拥有超高速度的超级英雄打击犯罪的故事,该角色由Robert Kanigher、John Broome和Carmine Infantino创作。作为《绿箭侠》的衍生剧,两者处于同一世界观。试播集由Berlanti、Kreisberg和Johns编剧,David Nutter执导,于2014年10月7日在北美首播,成为CW电视台收视率最高的节目之一。
《绿箭侠》是由Greg Berlanti、Marc Guggenheim和Andrew Kreisberg创作的电视剧。基于DC漫画角色绿箭侠,该角色由Mort Weisinger和George Papp创作。该剧于2012年10月10日在北美首播,随后在全球播出。主要拍摄地点位于加拿大不列颠哥伦比亚省温哥华。剧情讲述亿万富翁Oliver Queen(由Stephen Amell饰演)在荒岛被困五年后回国,化身使用弓箭的神秘义警打击犯罪腐败。与漫画不同,Queen初期并未使用“绿箭侠”这一化名。
由于这两部剧是我心中的最爱,我好奇哪部更受欢迎,即谁能在收视率上胜出。因此,我们编写程序来预测哪部节目下一集观众更多。我们需要一个包含每集观众数的数据集,我从维基百科获取数据并整理为.csv文件,格式如下。
| 闪电侠 | 闪电侠美国观众数 | 绿箭侠 | 绿箭侠美国观众数 |
|---|---|---|---|
| 1 | 4.83 | 1 | 2.84 |
| 2 | 4.27 | 2 | 2.32 |
| 3 | 3.59 | 3 | 2.55 |
| 4 | 3.53 | 4 | 2.49 |
| 5 | 3.46 | 5 | 2.73 |
| 6 | 3.73 | 6 | 2.6 |
| 7 | 3.47 | 7 | 2.64 |
| 8 | 4.34 | 8 | 3.92 |
| 9 | 4.66 | 9 | 3.06 |
观众数量单位为百万。
解决步骤如下:
首先,将数据转换为X_parameters和Y_parameters,但这里涉及两组变量。分别命名为flash_x_parameter、flash_y_parameter、arrow_x_parameter、arrow_y_parameter。接着,分别对《闪电侠》和《绿箭侠》建立两个线性回归模型。然后,预测两部节目下一集的观众数量,最后比较结果以推测哪部节目更受欢迎。
步骤1
导入所需程序库:
# Required Packages
import csv
import sys
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from sklearn import datasets, linear_model
步骤2
编写一个函数,以数据集为输入,返回flash_x_parameter、flash_y_parameter、arrow_x_parameter和arrow_y_parameter的值。
# Function to get data
def get_data(file_name):
 data = pd.read_csv(file_name)
 flash_x_parameter = []
 flash_y_parameter = []
 arrow_x_parameter = []
 arrow_y_parameter = []
 for x1,y1,x2,y2 in zip(data['flash_episode_number'],data['flash_us_viewers'],data['arrow_episode_number'],data['arrow_us_viewers']):
 flash_x_parameter.append([float(x1)])
 flash_y_parameter.append(float(y1))
 arrow_x_parameter.append([float(x2)])
 arrow_y_parameter.append(float(y2))
 return flash_x_parameter,flash_y_parameter,arrow_x_parameter,arrow_y_parameter
现在有了参数,编写另一个函数,以上述参数为输入,输出预测哪部节目观众更多的结果。
# Function to know which Tv show will have more viewers
def more_viewers(x1,y1,x2,y2):
 regr1 = linear_model.LinearRegression()
 regr1.fit(x1, y1)
 predicted_value1 = regr1.predict(9)
 print predicted_value1
 regr2 = linear_model.LinearRegression()
 regr2.fit(x2, y2)
 predicted_value2 = regr2.predict(9)
 #print predicted_value1
 #print predicted_value2
 if predicted_value1 > predicted_value2:
 print "The Flash Tv Show will have more viewers for next week"
 else:
 print "Arrow Tv Show will have more viewers for next week"
将所有代码整合到一个文件中。打开编辑器,命名为prediction.py,并将以下代码复制进去。
# Required Packages
import csv
import sys
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from sklearn import datasets, linear_model

# Function to get data
def get_data(file_name):
 data = pd.read_csv(file_name)
 flash_x_parameter = []
 flash_y_parameter = []
 arrow_x_parameter = []
 arrow_y_parameter = []
 for x1,y1,x2,y2 in zip(data['flash_episode_number'],data['flash_us_viewers'],data['arrow_episode_number'],data['arrow_us_viewers']):
 flash_x_parameter.append([float(x1)])
 flash_y_parameter.append(float(y1))
 arrow_x_parameter.append([float(x2)])
 arrow_y_parameter.append(float(y2))
 return flash_x_parameter,flash_y_parameter,arrow_x_parameter,arrow_y_parameter

# Function to know which Tv show will have more viewers
def more_viewers(x1,y1,x2,y2):
 regr1 = linear_model.LinearRegression()
 regr1.fit(x1, y1)
 predicted_value1 = regr1.predict(9)
 print predicted_value1
 regr2 = linear_model.LinearRegression()
 regr2.fit(x2, y2)
 predicted_value2 = regr2.predict(9)
 #print predicted_value1
 #print predicted_value2
 if predicted_value1 > predicted_value2:
 print "The Flash Tv Show will have more viewers for next week"
 else:
 print "Arrow Tv Show will have more viewers for next week"

x1,y1,x2,y2 = get_data('input_data.csv')
#print x1,y1,x2,y2
more_viewers(x1,y1,x2,y2)
你可以猜测哪部节目观众更多,但运行程序验证你的猜测是否正确。
3) 替换数据集中的缺失值
有时我们需要分析包含缺失值的数据。有人选择直接删除缺失值,有人使用最大值、最小值或平均值填补。虽然平均值是常见做法,但利用线性回归可以更有效地填补缺失值。
该方法大致流程如下。
首先定位需要填补的列,找出该列缺失值与其他列数据的依赖关系。将缺失值所在列作为Y_parameters,将依赖的其他列作为X_parameters,并拟合线性回归模型。利用模型预测缺失列的值。
完成此过程后,我们便得到了无缺失值的数据集,可自由进行分析。
作为练习,我将此问题留给你。请从网络获取包含缺失值的数据集并尝试解决,完成后欢迎在评论区分享结果,我很期待看到你的成果。
个人小笔记:
我想分享个人的数据挖掘学习经历。记得在数据挖掘入门课上,老师起初讲解缓慢,介绍应用领域和基础概念,随后难度骤增。这导致部分同学感到沮丧,甚至因此失去兴趣。因此,我希望在博客中避免这种情况,让内容更轻松随意。我尝试通过有趣的案例,让读者在舒适的状态下学习,避免枯燥或恐惧。
总结
以上是关于Python线性回归预测数据的完整内容,希望对你有帮助。感兴趣的朋友可继续查阅本站:
python编程线性回归代码示例
Python语言描述最大连续子序列和
Python实现字符串匹配算法代码示例
如有不足之处,欢迎留言指正。感谢朋友们对本站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









