利用Python与批处理脚本批量启动多个程序
本文介绍如何利用Python结合Windows批处理文件(.bat)实现批量启动多个程序。通过编写简单的批处理脚本,可以一次性打开多个Python脚本或应用程序,特别适用于服务器重启后的自动恢复场景。文章涵盖基础批处理语法、多文件并行执行以及虚拟环境下的路径切换方法,帮助提升运维效率。
2026-10-15
7

本文介绍如何利用Python结合Windows批处理文件(.bat)实现批量启动多个程序。通过编写简单的批处理脚本,可以一次性打开多个Python脚本或应用程序,特别适用于服务器重启后的自动恢复场景。文章涵盖基础批处理语法、多文件并行执行以及虚拟环境下的路径切换方法,帮助提升运维效率。
本文详细介绍Python中Matplotlib库的动态rc参数设置方法,包括全局参数定制与编程方式修改。重点讲解字体、线条样式及刻度标签的配置,并通过fill_between和fill函数演示曲线下方、局部区域及双曲线间的图形填充技巧,帮助开发者优化图表显示效果。
本文详细介绍如何使用Python内置的sqlite3模块进行SQLite数据库操作。内容涵盖数据库文件的创建、数据表的建立、记录的插入以及数据的查询与结果处理。通过具体代码示例,演示了从连接数据库到执行SQL语句的完整流程,并介绍了使用SqliteStudio可视化工具辅助开发的方法,适合初学者快速掌握Python与SQLite的基本交互技巧。
本文介绍如何使用Python的pexpect库对FTP交互进行封装。通过spawn类控制子进程,实现自动登录、文件上传下载及异常处理。文章详细解析了spawn类的expect与send方法,以及run函数的用法,提供了完整的代码示例,帮助开发者实现无需人工干涉的FTP自动化操作。
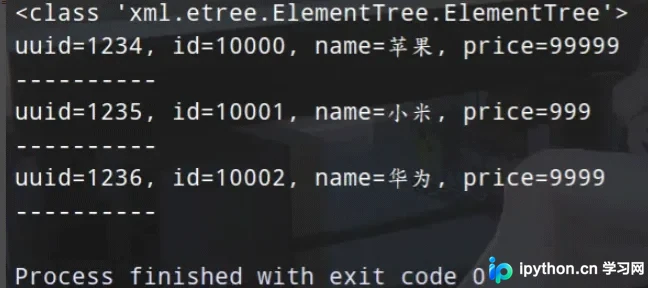
本文通过Python面试题案例,演示如何使用xml.etree.ElementTree模块读取XML文件。重点讲解parse函数加载文档及iterfind方法遍历子节点,结合findtext与get方法获取节点文本及属性值,实现数据的高效提取与分析。
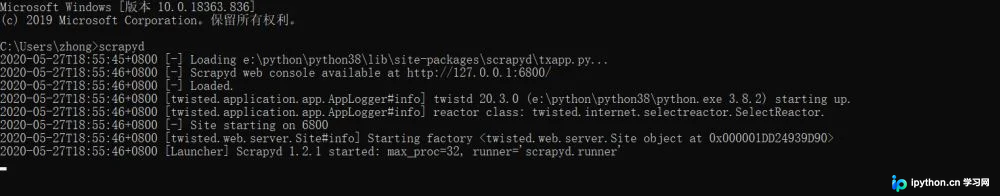
本文详细介绍Scrapy爬虫在生产环境中的服务器部署方案,涵盖Scrapyd服务端、ScrapydClient客户端及ScrapydWeb可视化管理工具的安装与配置。通过具体命令演示项目上传、爬虫启动及参数传递,并结合实际爬取数据展示部署效果与常见问题分析,帮助开发者实现高效、可视化的爬虫集群管理。
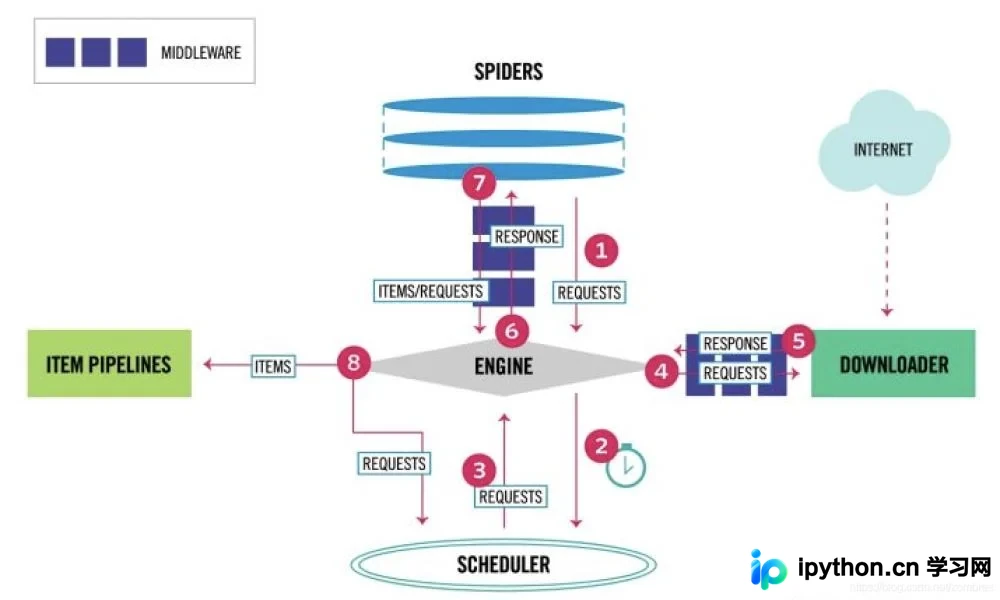
本文深入解析 Scrapy 框架中的两类核心中间件:下载器中间件(Downloader Middleware)与 Spider 中间件。详细说明了中间件的注册顺序、执行流程及关键方法(process_request、process_response、process_exception)的行为差异。提供了自定义 User-Agent 轮换、代理 IP 切换及基于状态码的重试中间件代码示例,并介绍了 Spider 中间件对 Item 和 Request 的处理逻辑,帮助开发者构建更稳健的爬虫系统。
本文详细介绍使用Flask框架搭建轻量级API服务的完整流程。内容涵盖数据库配置、全局DB对象定义及数据转码工具类的构建。重点演示了五种SQL查询接口的实现方式,包括无参查询、常规参数传递及复杂的IN参数处理。针对IN参数在URL中的多种传值形式(逗号分隔或多次重复键),提供了可靠的解析方案,并展示了标准化的错误处理与JSON响应返回机制,旨在为开发者提供一套可直接复用的API开发模板。
本文提供基于Python和Tkinter库实现的动态烟花效果完整代码。通过定义Firework类管理粒子状态、颜色及运动轨迹,利用多线程与Canvas绘图实现实时渲染。代码包含粒子生成、爆炸逻辑及界面刷新机制,适合Python初学者学习GUI编程与基础动画原理。
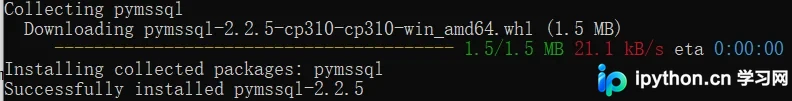
本文详细介绍如何使用Python的pymssql库连接SQL Server数据库。内容涵盖库的安装方式、数据库连接的创建与关闭、利用cursor对象执行查询语句(包括fetchone、fetchmany、fetchall及迭代器用法),以及通过execute和executemany实现单条或多条数据插入,并强调commit提交的重要性。
本文详细介绍如何使用Python实现凯撒密码的加密与解密过程。通过示例代码展示利用string模块和maketrans、translate方法构建字符映射表的具体步骤,解析偏移量作为密钥的原理,并附带完整的运行结果分析,帮助开发者快速掌握基础密码学算法在Python中的实现。
本文详解二维图像双线性插值的数学原理及其在Python中的高效实现。通过对比最近邻与双三次插值,阐述双线性插值在计算成本与效果间的平衡。提供基于NumPy meshgrid的完整代码示例,处理边界问题,适用于图像Resize、坐标映射等场景。