

Python自动抓取代理IP并验证可用性的实现方案
本文介绍使用Python自动从网站批量抓取免费代理IP,并通过Socket连接验证其可用性的方法。代码包含IP抓取、有效性判断及本地JSON存储逻辑,支持定时更新以维持IP池的有效性,适合需要稳定代理资源的开发场景。
2026-10-13
5

本文介绍使用Python自动从网站批量抓取免费代理IP,并通过Socket连接验证其可用性的方法。代码包含IP抓取、有效性判断及本地JSON存储逻辑,支持定时更新以维持IP池的有效性,适合需要稳定代理资源的开发场景。
本文介绍使用Python抓取西刺代理网站IP并验证其可用性的完整流程。针对反爬机制,通过设置请求头、增加延时及切换备选网站(如IP巴士)来应对封禁。代码展示了从抓取、解析到通过测试URL验证代理有效性的具体实现,旨在为开发者提供可参考的免费代理获取方案。
本文分享使用Python获取并验证免费代理IP的完整流程。通过正则表达式从西刺代理网站抓取IP及端口,利用多线程机制并行检测IP可用性,最终返回格式化的可用IP列表。代码包含getIP、check_one及mul_thread_check三个核心函数,适用于需要规避同一IP重复访问限制的数据抓取场景。
本文介绍了使用Python的urllib库通过指定代理IP访问whatismyip.com.tw网站的完整代码实例。文中演示了如何配置ProxyHandler和Opener,并分析了该代理IP(27.155.101.233:3128)的匿名程度。结果显示该代理为透明代理,真实IP被网站识别,虽不满足高匿需求,但仍适用于部分对匿名性要求不高的场景如投票等。
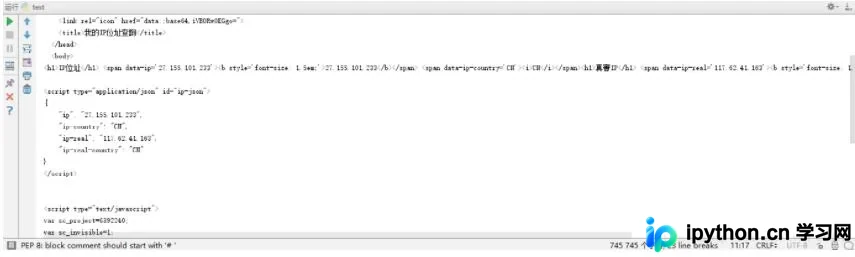
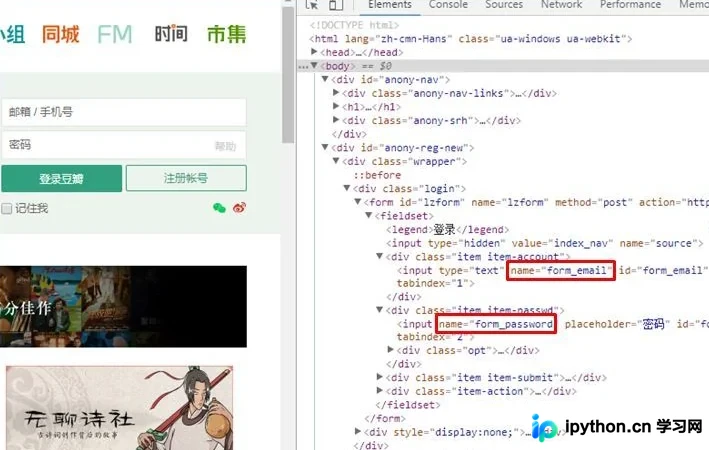
本文详细讲解Python爬虫中如何有效设置代理IP及伪装浏览器身份。内容涵盖使用urllib模块配置请求头、添加代理服务器、处理POST请求参数,以及利用PhantomJS和Selenium WebDriver模拟真实浏览器行为。通过具体代码示例,帮助开发者规避反爬限制,提升数据采集成功率。
本文详细介绍在Python爬虫开发中应对反爬机制的代理IP设置方法。通过安装requests、bs4和lxml库,构建从免费代理网站抓取IP并随机选取的完整流程。代码演示如何利用random模块生成符合requests格式的代理字典,有效规避真实IP被封风险,提升爬虫稳定性。
本文深入解析Python urllib库的高级用法,重点讲解如何利用Request方法构建Headers模拟浏览器进行POST数据提交,并详细剖析通过ProxyHandler定制Opener以配置代理IP解决反爬限制的技巧。内容涵盖参数解析、编码规则及异常处理,助力提升爬虫效率与稳定性。
本文介绍如何使用Python编写工具扫描并获取可用的代理IP。通过解析西刺代理网站结构,利用requests和BeautifulSoup提取IP、端口及协议信息,并结合多线程与队列机制提高抓取效率。随后通过请求特定网站验证代理有效性,最终将可用代理保存至文件,适用于需要大量代理资源的爬虫场景。
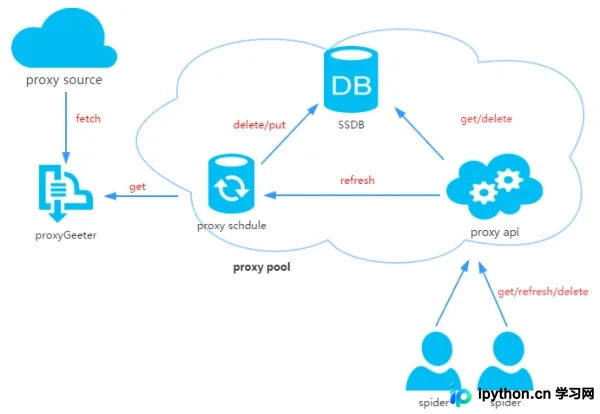
本文详细介绍如何使用Python搭建一个轻量级的分布式爬虫代理IP池。通过整合多个免费代理源,利用SSDB进行高性能存储,并结合Flask提供RESTful API接口。文章涵盖代理获取、质量检测、定时刷新及爬虫调用等核心模块,帮助开发者快速实现稳定高效的代理IP管理服务。
本文详细介绍如何利用Python的urllib.request库实现贝壳找房房源数据的自动化爬取。教程涵盖请求库引入、URL构建、随机代理IP配置及反爬策略(如随机休眠),并通过完整代码示例演示如何批量保存不同城市的多页网页数据,为后续大数据分析提供数据源。
本文介绍利用Python脚本提升博客访问量的两种方法。第一版通过模拟浏览器直接访问,但易触发IP限制;第二版引入西刺代理IP池,有效规避服务器屏蔽。文章包含Python2与Python3的代码示例及关键参数说明,供技术参考。
本文介绍如何使用Python多线程技术批量检测代理IP的有效性。通过读取本地IP文件,利用requests库发起HTTP请求,并结合threading模块实现并发测试。示例代码展示了线程池管理、结果去重及有效IP写入文件的完整流程,帮助开发者快速验证代理池质量。