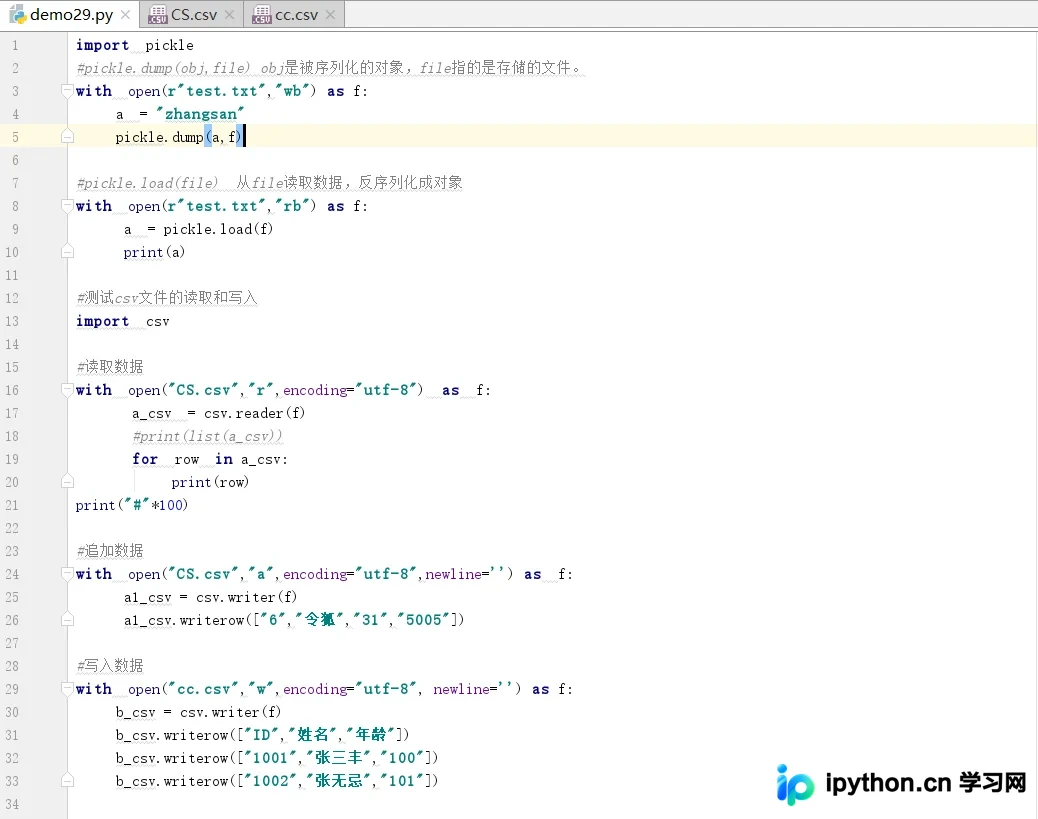
Python pickle模块实现Python对象持久化存储
本文详细介绍Python标准库pickle模块的使用方法,涵盖dumps、loads、dump和load四个核心函数的语法与参数。通过具体代码示例,演示如何将Python对象序列化为二进制数据并存储至文件或内存,实现对象的持久化与恢复。同时指出pickle在并发和高性能场景下的局限性,并推荐ZODB作为替代方案。
2026-10-15
8

本文详细介绍Python标准库pickle模块的使用方法,涵盖dumps、loads、dump和load四个核心函数的语法与参数。通过具体代码示例,演示如何将Python对象序列化为二进制数据并存储至文件或内存,实现对象的持久化与恢复。同时指出pickle在并发和高性能场景下的局限性,并推荐ZODB作为替代方案。
本文深入解析Python中的三种核心数据序列化模块:json、pickle和shelve。详细对比它们的数据支持范围、跨语言兼容性以及文件读写模式差异,重点讲解Python 2与3在编码处理上的不同,并提供dumps/loads与dump/load的具体代码示例,帮助开发者根据场景选择最合适的持久化方案。
本文详细解析Python中pickle模块的dump()和load()方法。介绍如何将Python对象序列化为二进制文件,以及如何从文件中反序列化恢复对象。涵盖关键参数如protocol、fix_imports及错误处理机制,并提供完整代码示例,帮助开发者掌握数据持久化技巧。
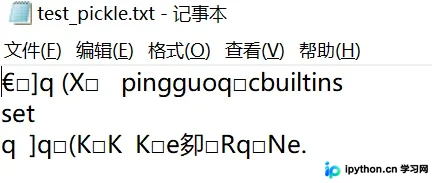
本文详解Python中pickle模块的序列化与反序列化机制。通过将内存对象转换为有序二进制数据并存储至磁盘实现持久化,再从磁盘读取恢复对象。文章提供了使用dumps/dumps及load/dump方法的完整代码示例,涵盖写入与读取流程,帮助开发者掌握对象持久化技术。
本文介绍在Python3环境中读取由Python2生成的pickle序列化文件时,因默认编码差异导致的UnicodeDecodeError错误。通过指定encoding='iso-8859-1'参数,可成功加载数据,解决跨版本兼容性问题。
本文详细介绍Python中Json与pickle两个序列化模块。Json用于字符串与通用数据类型的转换,支持跨语言交互;Pickle用于Python特有类型及复杂对象的序列化,仅限Python使用。文章对比dumps、dump、loads、load四个核心功能,并通过代码示例演示文件读写、函数序列化及常见报错原因,帮助开发者掌握数据持久化技巧。
本文详细介绍Python中pickle模块的功能,涵盖dumps、loads、dump和load四个核心方法的使用示例。文章对比了pickle与JSON在格式、兼容性及安全性上的差异,并列举了可被序列化的数据类型。重点强调pickle处理非信任数据时的安全风险,建议开发者谨慎使用。
本文深入解析 Python 中对象序列化的两种核心方式:pickle 与 json。pickle 适用于 Python 内部数据交换,支持自定义对象但仅限 Python 环境;json 则提供跨语言标准格式,便于网络传输与存储。文章详细对比两者差异,并通过代码示例演示如何处理自定义类的序列化问题,包括使用 default 参数和 __dict__ 属性等技巧。
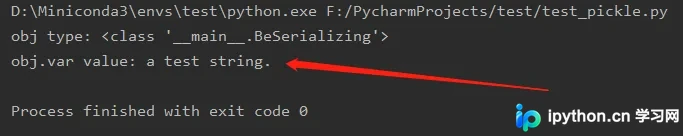
本文详解Python中pickle库的序列化与反序列化用法,通过完整代码示例展示如何将对象写入文件及从文件还原。重点探讨在特定框架无法直接获取返回值时,利用序列化机制中转数据的解决方案,帮助开发者处理复杂对象的状态保存与恢复。
本文深入解析Python中对象序列化的两种核心方式:JSON与Pickle。详细对比了json.dumps/loads与pickle.dumps/loads在数据类型支持、文件读写模式及函数序列化能力上的差异,重点探讨了多次序列化同一对象到文件时JSON与Pickle的不同表现及反序列化报错原因,为Python数据持久化提供实用指南。
本文详细介绍Python中json和pickle模块的使用方法。json模块用于将Python数据类型转换为JSON字符串格式,支持int、str、bool、list、dict等类型,需注意中文编码及双引号规范。pickle模块专用于Python内部数据持久化,支持所有Python类型,序列化结果为bytes。文章通过代码示例演示dumps、loads、dump、load函数的具体应用及两者核心差异。
本文详解Python中的序列化机制,重点介绍pickle模块实现对象持久化的方法。同时对比CSV与Excel文件的差异,阐明CSV仅支持字符串数据、无样式及多表等限制,帮助开发者正确使用CSV进行数据存储与读取。