

Python pickle 序列化与反序列化实战:解决框架返回值获取难题

发布时间:2026-10-15| 6人浏览过
本文详解Python中pickle库的序列化与反序列化用法,通过完整代码示例展示如何将对象写入文件及从文件还原。重点探讨在特定框架无法直接获取返回值时,利用序列化机制中转数据的解决方案,帮助开发者处理复杂对象的状态保存与恢复。
Python pickle 序列化与反序列化实战:解决框架返回值获取难题
一、说明
近日关注到Python中利用pickle进行序列化和反序列化的应用场景,联想到当前遇到的一个框架问题:由于框架限制无法直接获取某些操作的返回值,尝试通过先在框架内部执行序列化操作,随后在外部进行反序列化的方式来间接获取数据。基于此思路,对pickle库的具体使用方式进行了深入研究。
该过程本身并不复杂,但出于防止遗忘以及厘清概念的目的进行记录。自学习Java以来,听到“反序列化”一词便产生莫名的畏惧感,总觉得这是某种高深且复杂的技术。关于Java反序列化的相关漏洞实现,可参考“Java反序列化漏洞实现”一文。
代码实现与运行结果分析
二、代码实现
import pickle


class BeSerializing:
 def __init__(self):
  self.var = "a test string."

 def print_var(self):
  print(f"self var value is:{self.var}")


class Serializing:
 def do_serializing(self):
  obj = BeSerializing()
  # with的好处是会最后自动释放获取的资源,对于文件就是最后会自己close()
  with open("test_pickle.obj", "wb") as file_handler:
   # 序列化,将对象写到文件
   pickle.dump(obj, file_handler)


class DeSerializing:
 def do_serializing(self):
  with open("test_pickle.obj", "rb") as file_handler:
   # 反序列化,将对象从文件中还原
   # 注意,虽然python的变量不需要使用前先定义类型,但使用时是要被格式化成确定类型的
   # 所以,如果反序列化类和被序列化类不在同一文件中,那么需要将被序列化类import进来,不然会因找不到被反序列化类而反序列化失败
   obj = pickle.load(file_handler)
   print(f"obj type: {type(obj)}\n"
     f"obj.var value: {obj.var}")


if __name__ == "__main__":
 obj_se = Serializing()
 obj_se.do_serializing()
 obj_de = DeSerializing()
 obj_de.do_serializing()
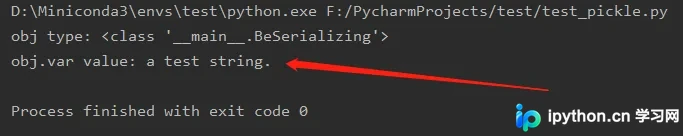
运行上述代码后,输出结果证实了反序列化成功,并正确打印出被序列化对象中变量的值。
参考:
https://docs.python.org/3/library/pickle.html
以上就是Python使用pickle进行序列化和反序列化的示例代码的详细内容,更多关于python 序列化和反序列化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









