

Python shelve模块实现数据持久化详解
本文详解Python中shelve模块的数据持久化用法。shelve是pickle的封装,支持将字典键值对持久化到文件,允许多次dump和load操作。通过生成.bak、.dat、.dir三个文件存储数据,可持久化列表、字典及datetime等类型。文章提供完整代码示例,展示如何保存和读取数据,适用于需要简单键值存储的场景。
2026-10-13
6

本文详解Python中shelve模块的数据持久化用法。shelve是pickle的封装,支持将字典键值对持久化到文件,允许多次dump和load操作。通过生成.bak、.dat、.dir三个文件存储数据,可持久化列表、字典及datetime等类型。文章提供完整代码示例,展示如何保存和读取数据,适用于需要简单键值存储的场景。
本文介绍Python中的序列化概念,重点对比JSON与Pickle两种常用序列化方式。JSON适用于跨语言数据交换,轻量且通用;Pickle专用于Python对象持久化,支持所有Python数据类型。文章提供具体代码示例,展示dumps/dump与loads/load方法的使用,帮助开发者理解不同场景下的最佳实践。
本文详细介绍Python中sys模块与常用序列化模块。sys模块提供与解释器交互的接口,如命令行参数和路径。序列化模块包括json(字符串与Python类型转换)、pickle(支持任意Python数据类型)及shelve(基于key的简单持久化),通过实例讲解各模块功能、参数及注意事项,帮助开发者实现数据持久化与传递。
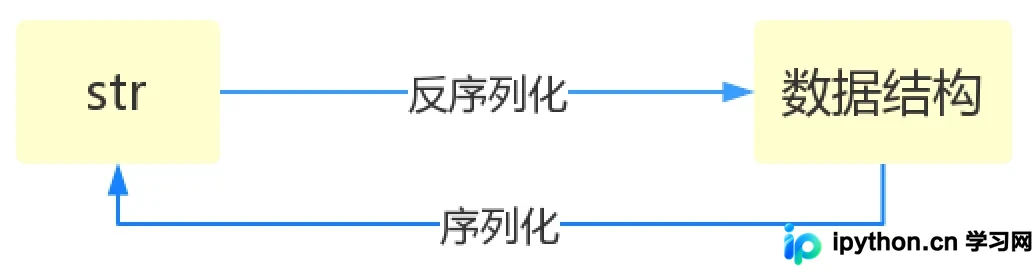
本文深入解析Python中json与pickle两大序列化模块。json用于字符串与通用数据类型转换,支持跨语言数据交换;pickle专用于Python特有类型及全数据类型序列化,仅限Python环境。通过对比dumps、loads、dump、load四个核心功能及文件读写模式(文本vs二进制),明确两者在数据类型支持、语言兼容性及使用场景上的关键差异,帮助开发者根据需求选择合适的序列化方案。
本文深入解析Python中常用的序列化工具,涵盖pickle、json及shelve模块。重点讲解如何在变量与文件中存储数据,以及如何处理自定义类的序列化与反序列化问题,包括使用default和object_hook参数解决JSON序列化报错,以及shelve模块的writeback机制,帮助开发者实现对象状态的持久化与恢复。
介绍Python标准库shelve模块的存储原理、核心用法及注意事项。通过字典式API演示数据的创建、读写、更新与删除操作,并附带命令行待办事项应用示例。适合小型配置管理、本地缓存及轻量级数据库场景,同时说明其并发限制与内存占用问题,帮助开发者快速搭建文件级数据持久化方案。
本文介绍如何使用Python标准库Tkinter构建图形界面,并结合Pickle模块实现本地数据持久化,完成带用户名密码校验的用户登录与注册交互功能。提供完整源码与关键逻辑解析,适合已掌握Python基础的开发者快速搭建轻量级桌面端账户管理原型。
本文介绍Python内置pickle模块的序列化与反序列化功能。通过具体代码示例,演示如何将Student对象保存为字节流文件,以及如何从文件中读取并恢复对象。同时展示了dumps和loads方法在内存中直接处理字节流的操作方式,帮助开发者理解对象持久化的基本流程。
本文详细介绍Python标准库中用于处理数据序列化的Pickle模块。通过对比dump、load、dumps和loads四个核心函数,梳理将Python对象转换为字节流进行持久化存储或内存交换的标准操作流程,帮助开发者掌握高效的对象读写技巧。
本文介绍Python中变量从内存到磁盘的序列化(pickling)及反序列化过程。通过对比cPickle与pickle模块的性能差异,演示如何使用dumps、dump、loads和load方法实现对象的持久化存储与读取,并指出pickle仅限Python使用的局限性。
本文深入解析Python标准库pickle模块,介绍其用于对象序列化的核心功能。通过具体代码示例,演示如何将列表等数据结构转换为二进制格式并保存至文件,以及如何从文件中恢复数据。文章同时涵盖pickle.dump、load、dumps及loads函数的用法,并针对Python版本差异带来的安全风险提供必要的操作建议。
本文介绍如何在Python中使用pickle模块将变量保存到本地文件,以及如何从文件中读取变量。通过定义save_variable和load_variavle函数,实现变量的持久化存储和读取。