

MySQL中count(*)执行慢的解决方案及优化
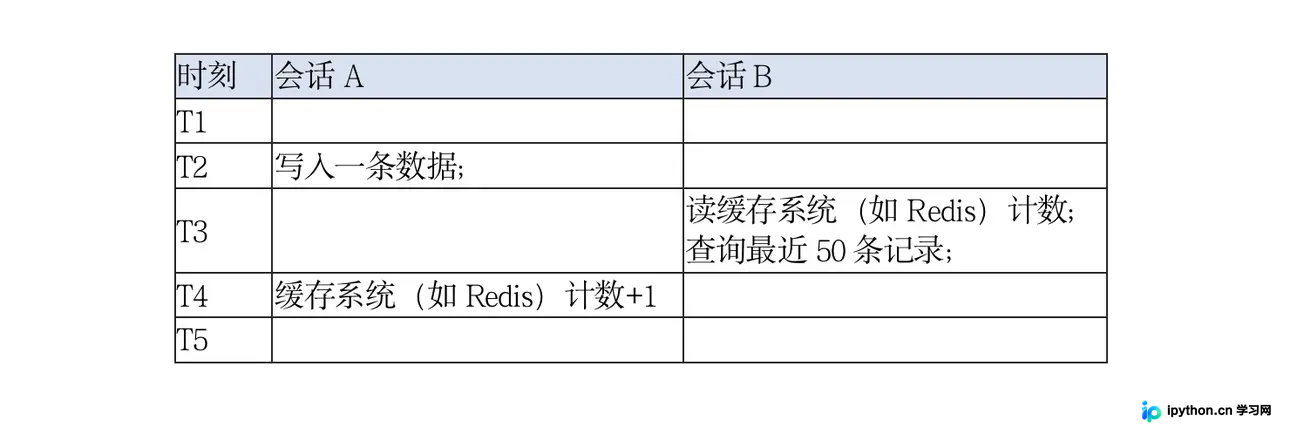
MySQL InnoDB引擎因MVCC机制无法直接缓存行数,导致count(*)全表扫描变慢。MyISAM虽快但不支持事务。本文深入解析count不同写法的执行差异,并提供基于Redis、独立计数表等替代方案,帮助开发者在数据一致性与应用性能间找到平衡点。
2026-10-16
7

MySQL InnoDB引擎因MVCC机制无法直接缓存行数,导致count(*)全表扫描变慢。MyISAM虽快但不支持事务。本文深入解析count不同写法的执行差异,并提供基于Redis、独立计数表等替代方案,帮助开发者在数据一致性与应用性能间找到平衡点。
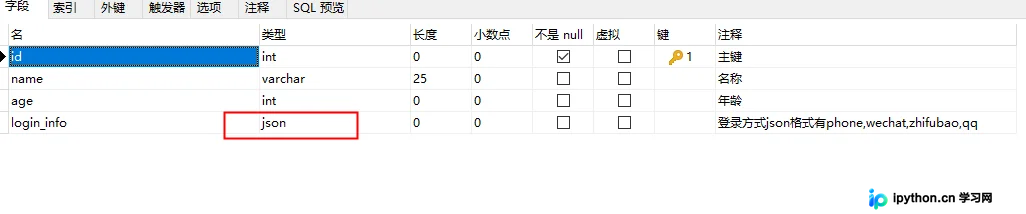
MySQL 5.7 原生支持 JSON 数据类型,适合存储结构灵活的用户画像或配置信息。本文详解如何通过 JSON_EXTRACT 提取数据、利用生成列优化查询性能,以及在 MySQL 8.0 中使用多值索引加速 JSON 数组检索,解决传统关系型字段扩展困难的问题。
本文通过代码测试对比了PHP中三种访问方式:`ClassName::method()`(类名访问静态)、`$obj->method()`(实例访问静态)和`$obj->nonStaticMethod()`(实例访问非静态)。测试结果表明,使用类名直接调用静态方法的效率低于通过实例调用同个静态方法,而通过实例调用非静态方法的耗时介于两者之间。测试基于Windows环境下的PHP CLI模式进行。
在 JavaScript 中频繁拼接大字符串会导致严重的性能问题。本文通过分析字符串分割后遍历的案例,对比了直接拼接与使用数组 push 再 join 的方法,揭示了前者因栈空间扩展导致的缓慢,并推荐利用引用类型特性进行高性能处理。
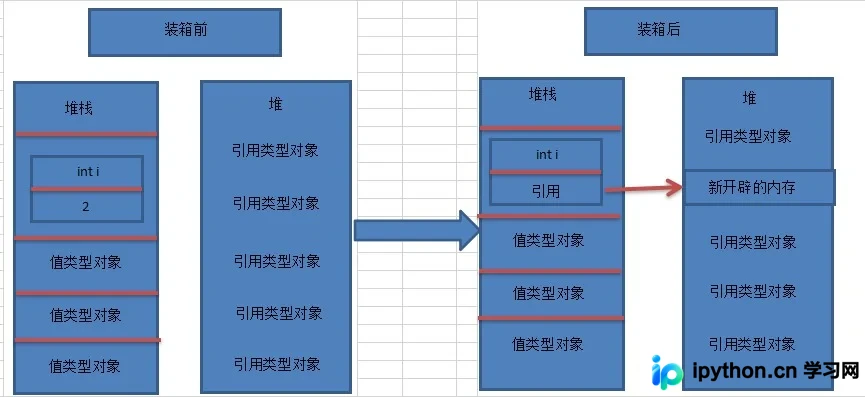
本文详细解析C#中值类型与引用类型转换时的装箱(Boxing)和拆箱(Unboxing)原理,揭示其对内存分配和GC的影响。通过代码示例演示非法拆箱的异常处理,并总结利用ToString()方法和泛型容器有效避免装箱拆箱带来的性能损耗的最佳实践。
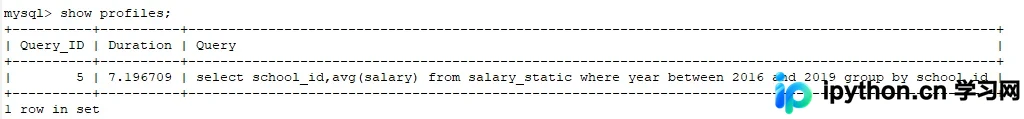
本文深入解析MySQL InnoDB引擎中因回表导致索引失效的经典案例。通过对比全表扫描与索引扫描的成本计算,揭示优化器在大数据量回表时误判的内在机制。文章提供了基于optimizer_trace的详细分析,并给出了通过创建覆盖索引解决回表开销过大的具体优化方案及临界值计算公式。
本文针对500万行级别的大规模数据,系统对比了Pandas中iloc、at、apply及Series直接处理的速度差异。实测显示,iloc耗时约5小时,at优化至10分钟,而转为Series处理仅需37秒。此外,文章通过数值实验深入剖析了loc、at、iloc、iat及直接访问values数组在读取与修改场景下的性能表现,指出直接获取二维数组再定位是最高效方案,并提供了相应的代码实现与优化建议。
本文详细介绍Python中字符串遍历的四种常用方式:下标法、for-in循环、enumerate内置函数以及iter内置函数。通过对比分析,指出下标法和enumerate适用于需要访问后续字符的场景(如括号匹配),而for-in和iter更适合直接处理字符。文章强调enumerate在需要索引时比单纯下标法性能更优,并基于Python3.x环境提供具体代码示例与适用场景建议。
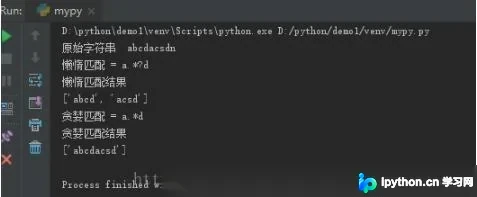
本文深入解析Python正则表达式中的贪婪匹配与懒惰匹配机制,通过代码示例展示两者在匹配结果上的差异。重点分析实际项目中因正则写法导致的性能瓶颈,对比不同匹配模式下的执行时间,并提供分段匹配等优化建议,帮助开发者提升正则处理效率。
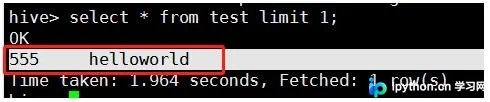
本文介绍如何利用Python脚本将Hive命令行输出转换为标准的Insert语句,解决Hive无法直接导出插入语句的问题。同时详细记录了通过impyla、HDFS及MySQL中转等多种尝试路径中的常见陷阱,重点警示批量插入的性能瓶颈,并提供实用的临时解决方案。
本文深入解析Python中 is 与 == 的核心区别,前者比较内存地址,后者比较值。重点讲解字符串驻留(Intern)机制对拼接性能的影响,以及-5到256整数缓存规则。通过多个代码示例对比不同场景下的行为,并说明交互式环境与IDE解释器优化的差异,最后给出使用 is 判断 None 的最佳实践建议。
本文介绍如何使用 Python 内置的 functools.lru_cache 装饰器优化递归函数的执行效率。通过一个在嵌套结构中查找元素的示例,对比了启用缓存前后的运行时间,展示了 lru_cache 如何避免重复计算并显著提升递归性能。