

Python构造Hive Insert语句及数据写入避坑指南

本文介绍如何利用Python脚本将Hive命令行输出转换为标准的Insert语句,解决Hive无法直接导出插入语句的问题。同时详细记录了通过impyla、HDFS及MySQL中转等多种尝试路径中的常见陷阱,重点警示批量插入的性能瓶颈,并提供实用的临时解决方案。
Python构造Hive Insert语句的方法
MySQL数据库通常支持使用Navicat等工具直接导出Insert语句以进行数据构造,但Hive并不具备这一直接导出功能。为此,我们可以先通过Hive命令行打印出相关数据记录,随后编写脚本将其拼装成标准的Insert语句,从而实现高效的数据构造。
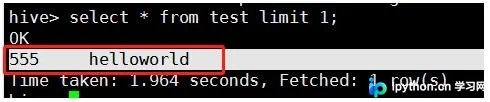
具体做法是将Hive命令行打印出的结果手动复制至Python脚本中,通过代码逻辑构造SQL语句。
def transformString(s): list_s = s.split('\t') print(len(list_s)) s_new = '' for item in list_s: s_new += '\"' + item.strip(' ') + '\"' + ',' return str(s_new.rstrip(','))# 为手动copy hive命令行打印输出的记录s = "555 helloworld"s_new = transformString(s)sql = 'insert into dw.test PARTITION (ymd = \'2019-03-18\') values({});'.format(s_new)print(sql)执行上述脚本后的输出结果如下所示。
insert into dw.test PARTITION (ymd = '2019-03-18') values("555","helloworld");
Python写入Hive数据的常见陷阱
补充知识:在使用Python向Hive插入数据时,开发者常会遇到一些典型问题与陷阱。
在实际项目需求中,往往需要通过Python进行建模分析,并需要从Hive中获取数据,同时将模型处理结果写回Hive表。
在此过程中,尝试了多种技术路径,现将这些充满挑战的探索经历记录如下,供参考。
impyla库连接与环境配置
首先尝试通过impyla库建立Hive与Python之间的连接桥梁。
1.1 环境配置环节存在诸多隐患(后续补充连接细节)。
注意:远程访问Hive服务时,务必正确配置账号和密码,否则可能遭遇类似“...-4...”的报错信息。
1.2 强烈不建议使用impyla库中的executemany方法进行批量数据插入,也不推荐其他类似的批量插入方式,因为这些方法均存在严重性能问题,执行速度极慢。查阅相关资料也普遍指出不建议采用此类做法。
HDFS间接写入方案及风险
另一种思路是通过HDFS文件系统间接处理数据。
2.1 尝试使用Python的pyhdfs库将处理结果直接写入HDFS文件,但实际操作中并未成功连接至服务器端的HDFS(仅在本地HDFS环境中可行)。
2.2 既然直接写入HDFS受阻,便改为通过hadoop/hdfs命令将模型结果上传至HDFS,随后利用hive命令执行load data操作,将HDFS中的数据导入Hive表。尽管流程较为繁琐,但该方法确实可行。然而,直接操作HDFS存在较高风险,建议寻找更稳妥的替代方案。
2.3 根据相关建议,可考虑使用Kafka作为中间件,但该路径的潜在风险需后续进一步验证。
2.4 一种临时且稳妥的处理方案是:先将数据结果写入MySQL数据库,再从MySQL导入Hive。此路径无明显技术障碍,虽然步骤稍显繁琐,但操作相对安全。
以上关于使用Python构造Hive Insert语句及数据写入的说明即为全部内容,旨在为读者提供参考与警示,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









